
As 10 melhores interfaces Web de IA local para laboratórios domésticos em 2026


Uma boa interface Web de IA local transforma um servidor de modelos de linha de comandos num serviço privado que todos em casa podem usar. As melhores opções também guardam o histórico de conversas, gerem modelos e permitem adicionar documentos ou ferramentas sem obrigar todos os utilizadores a compreender a infraestrutura subjacente.
O Open WebUI é a melhor opção geral para a maioria dos laboratórios domésticos, mas não é automaticamente a melhor interface para todas as tarefas. O LibreChat oferece mais recursos para agentes e ferramentas MCP, o AnythingLLM dá prioridade ao RAG baseado em documentos, o text-generation-webui disponibiliza controlos de inferência mais avançados e o Dify ou o Flowise são mais indicados quando o objetivo é criar aplicações, em vez de simplesmente conversar. A comparação abaixo começa pela adequação prática, para que possa escolher a interface mais simples que resolva o seu caso de utilização real.
Comparação de interfaces Web de IA local
| Classificação | Interface Web | Ideal para | Ligação a modelos locais | Vários utilizadores | Nível de configuração |
|---|---|---|---|---|---|
| 1 | Open WebUI | Melhor interface geral para laboratórios domésticos | Ollama e APIs compatíveis com OpenAI | Sim | Fácil–moderado |
| 2 | LibreChat | Agentes, MCP e utilizadores avançados | Ollama e vários pontos de acesso de API | Sim | Moderado |
| 3 | LobeHub | Espaço de trabalho de IA pessoal e aperfeiçoado | Ollama e amplo suporte para fornecedores | Com implementação no servidor | Moderado |
| 4 | AnythingLLM | Documentos privados e RAG pronto a usar | Fornecedores de LLM locais e na nuvem | Sim, na edição Docker | Fácil–moderado |
| 5 | text-generation-webui | Carregamento de modelos e controlo de inferência | Back-ends de inferência integrados | Limitado | Moderado–avançado |
| 6 | Big-AGI | Comparação de vários modelos e pesquisa | Ollama, LM Studio, LocalAI, APIs | Sem contas nativas na edição Open | Moderado |
| 7 | NextChat | Chat leve e responsivo | Pontos de acesso compatíveis com OpenAI e LocalAI | Código de acesso básico | Fácil |
| 8 | SillyTavern | Interpretação de papéis, personas e controlo de prompts | Ampla variedade de APIs de modelos locais | Principalmente para uso pessoal | Moderado |
| 9 | Dify | Criar e publicar aplicações de IA | Modelos locais através de fornecedores/plugins | Sim | Avançado |
| 10 | Flowise | Agentes visuais e fluxos de trabalho LLM | Ollama e outros nós de modelos | Controlos de acesso disponíveis | Avançado |
A classificação da configuração abrange a interface e os serviços de suporte, não a inferência do modelo. A execução de um modelo local de grandes dimensões pode exigir muito mais RAM ou capacidade de GPU do que a própria interface Web.
Como classificámos estas interfaces de IA locais
Demos prioridade à utilidade para laboratórios domésticos, em vez da quantidade de funcionalidades. Avaliámos cada interface quanto à compatibilidade com modelos locais, ao suporte para Docker ou alojamento próprio, à facilidade de utilização a partir de outros dispositivos na LAN, às funcionalidades RAG e de agentes, à gestão de utilizadores, à carga de manutenção e à clareza da documentação de implementação do projeto.
A privacidade também depende da configuração. Uma interface alojada no seu próprio servidor pode, ainda assim, enviar pedidos para APIs na nuvem, serviços de pesquisa, pontos de acesso de telemetria ou ferramentas externas, se os ativar. Para uma pilha verdadeiramente local, mantenha o ponto de acesso do modelo, os embeddings, a base de dados vetorial, os serviços de voz e o armazenamento dentro da sua rede. O guia da ZimaSpace para LLMs locais privados explica o percurso completo dos dados.
1. Open WebUI — Melhor interface Web de IA local no geral
O Open WebUI é a opção mais segura para um laboratório doméstico, porque combina uma experiência de chat acessível com funcionalidades suficientes para continuar a ser útil à medida que a configuração cresce. Liga-se diretamente ao Ollama e a APIs compatíveis com OpenAI, pode funcionar offline e suporta vários modelos sem vincular a interface a um único motor de inferência.
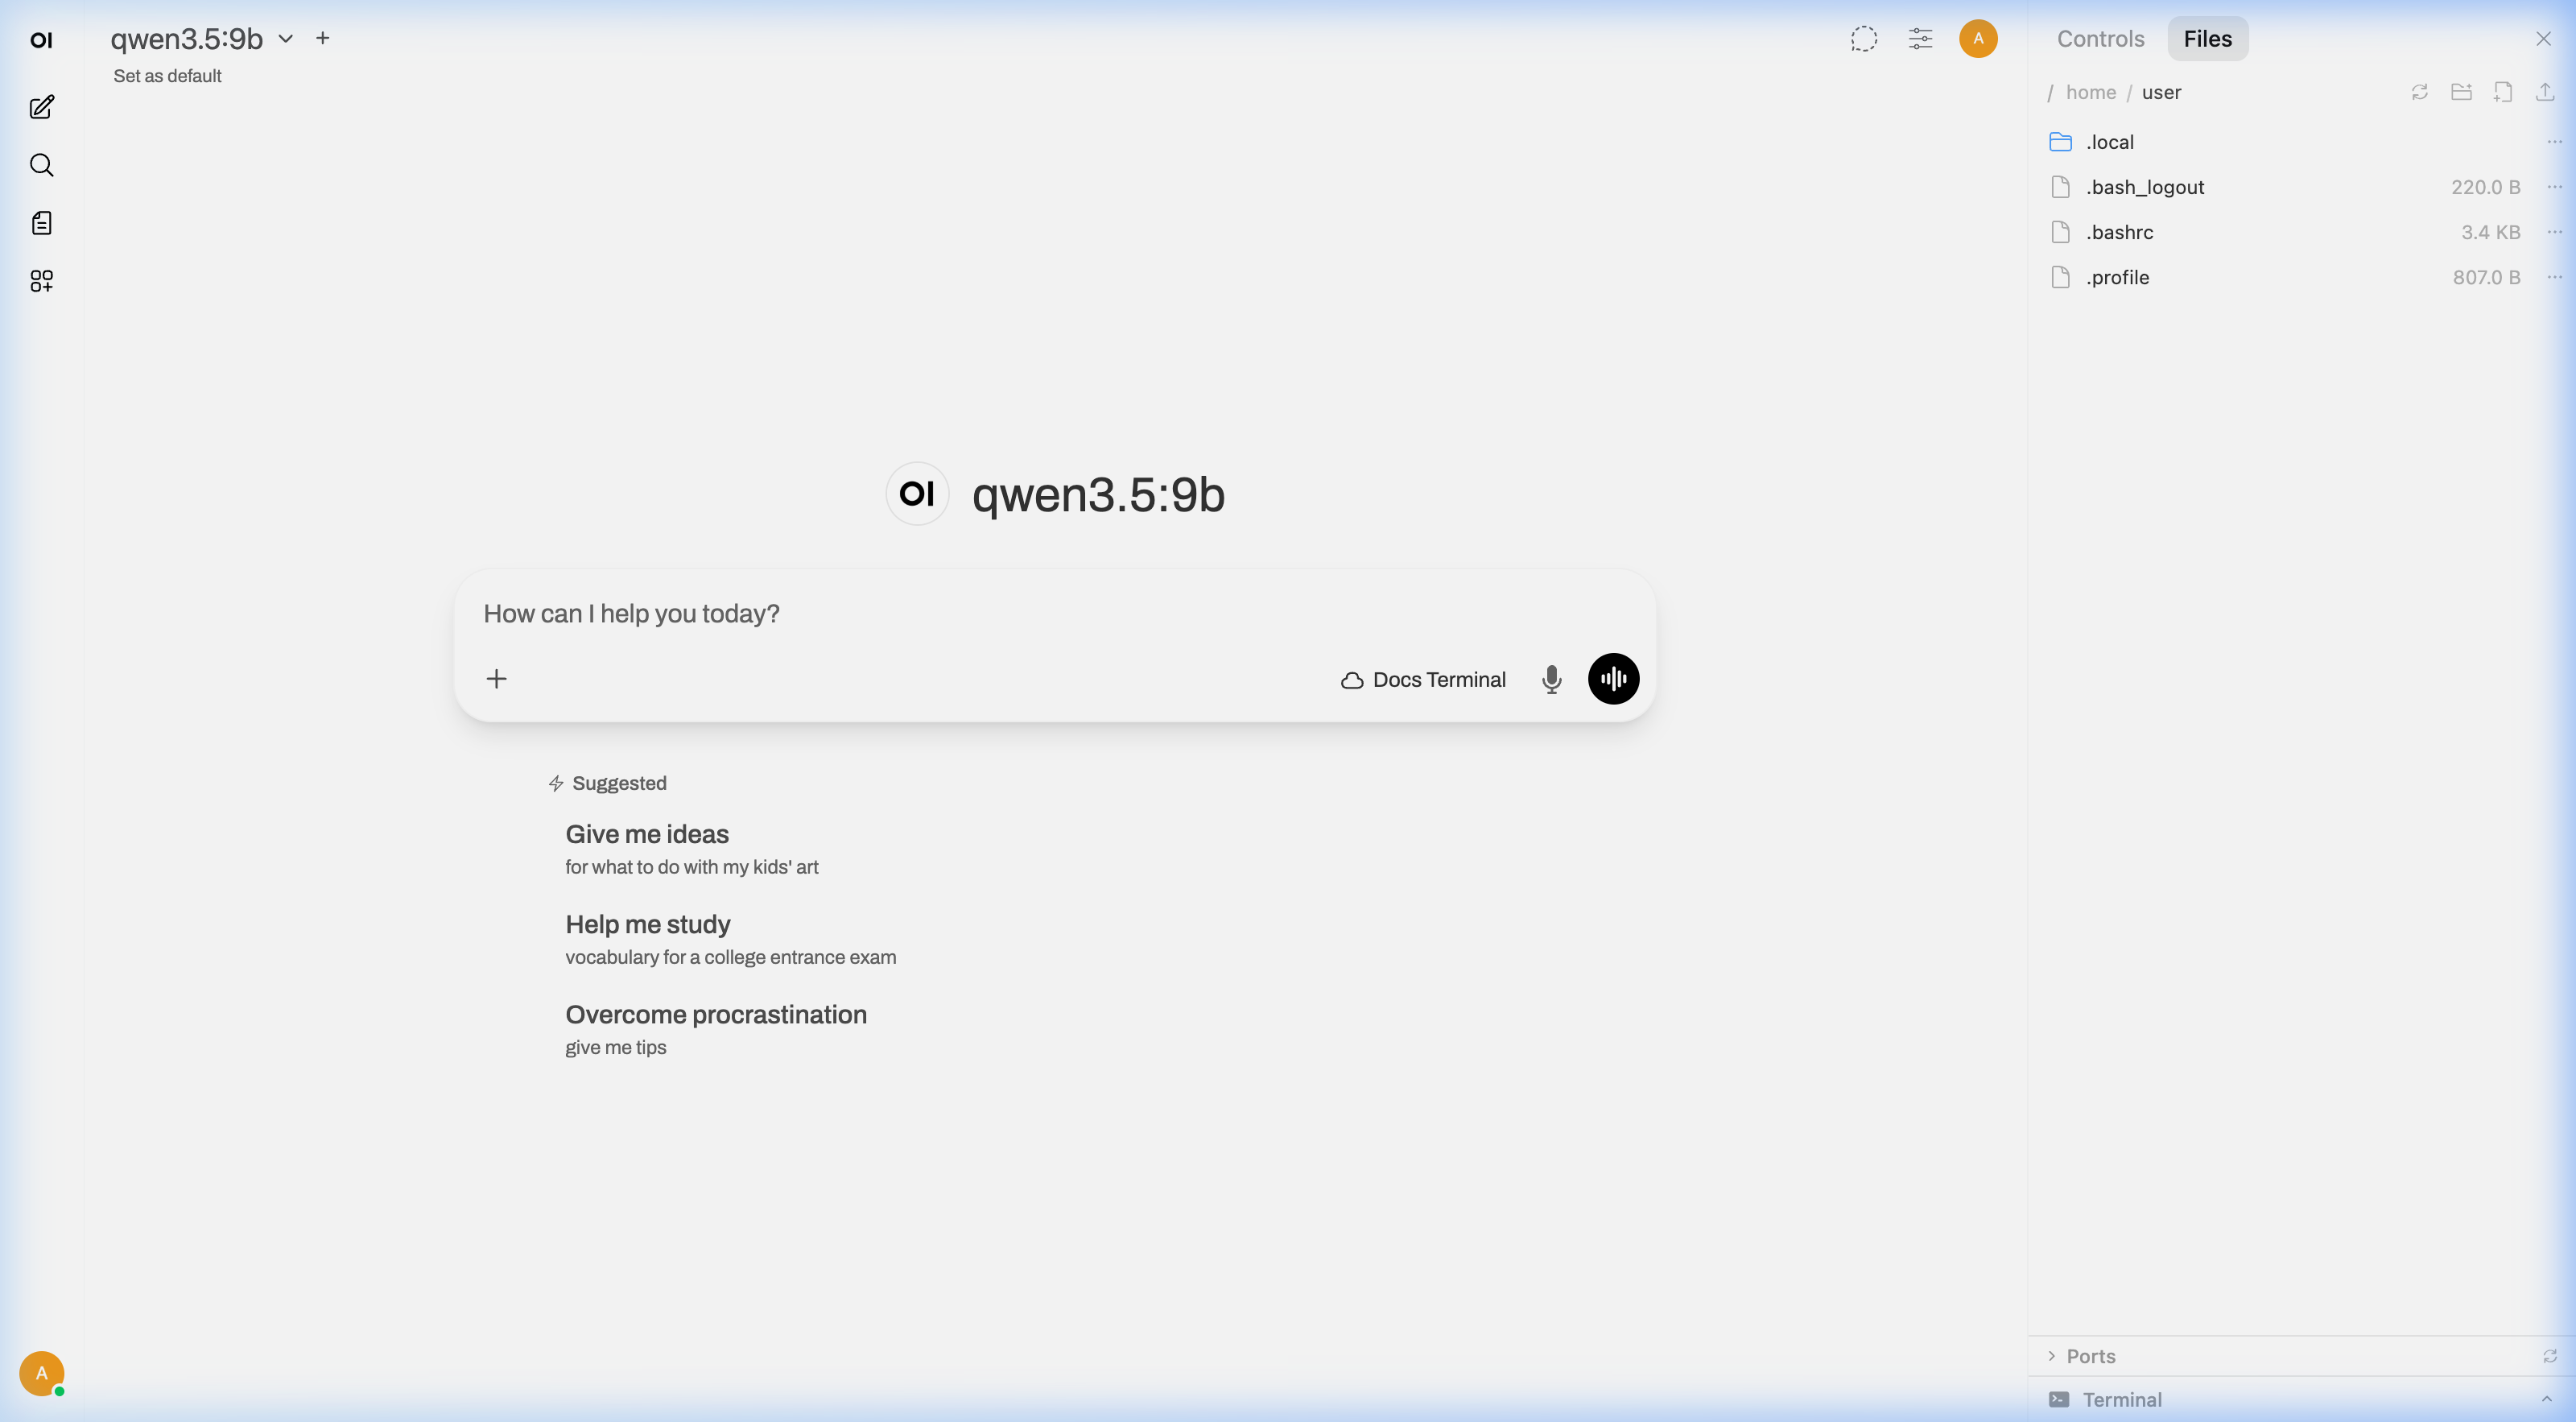
As funcionalidades incluem anexos de ficheiros e imagens, RAG, pesquisa na Web, execução de código, ferramentas, memória, conversas com vários modelos e gestão de utilizadores. A principal desvantagem é a complexidade: cada funcionalidade ativada acrescenta serviços, permissões e possíveis ligações de rede que têm de ser mantidos.
- Ideal para: famílias, entusiastas individuais e servidores domésticos multiutilizador.
- Escolha-o quando: pretender uma interface ao estilo do ChatGPT que funcione desde já e possa ser ampliada mais tarde.
- Atenção a: configuração de rede Docker entre o Open WebUI e um serviço Ollama noutro anfitrião.
2. LibreChat — Ideal para agentes e ferramentas MCP
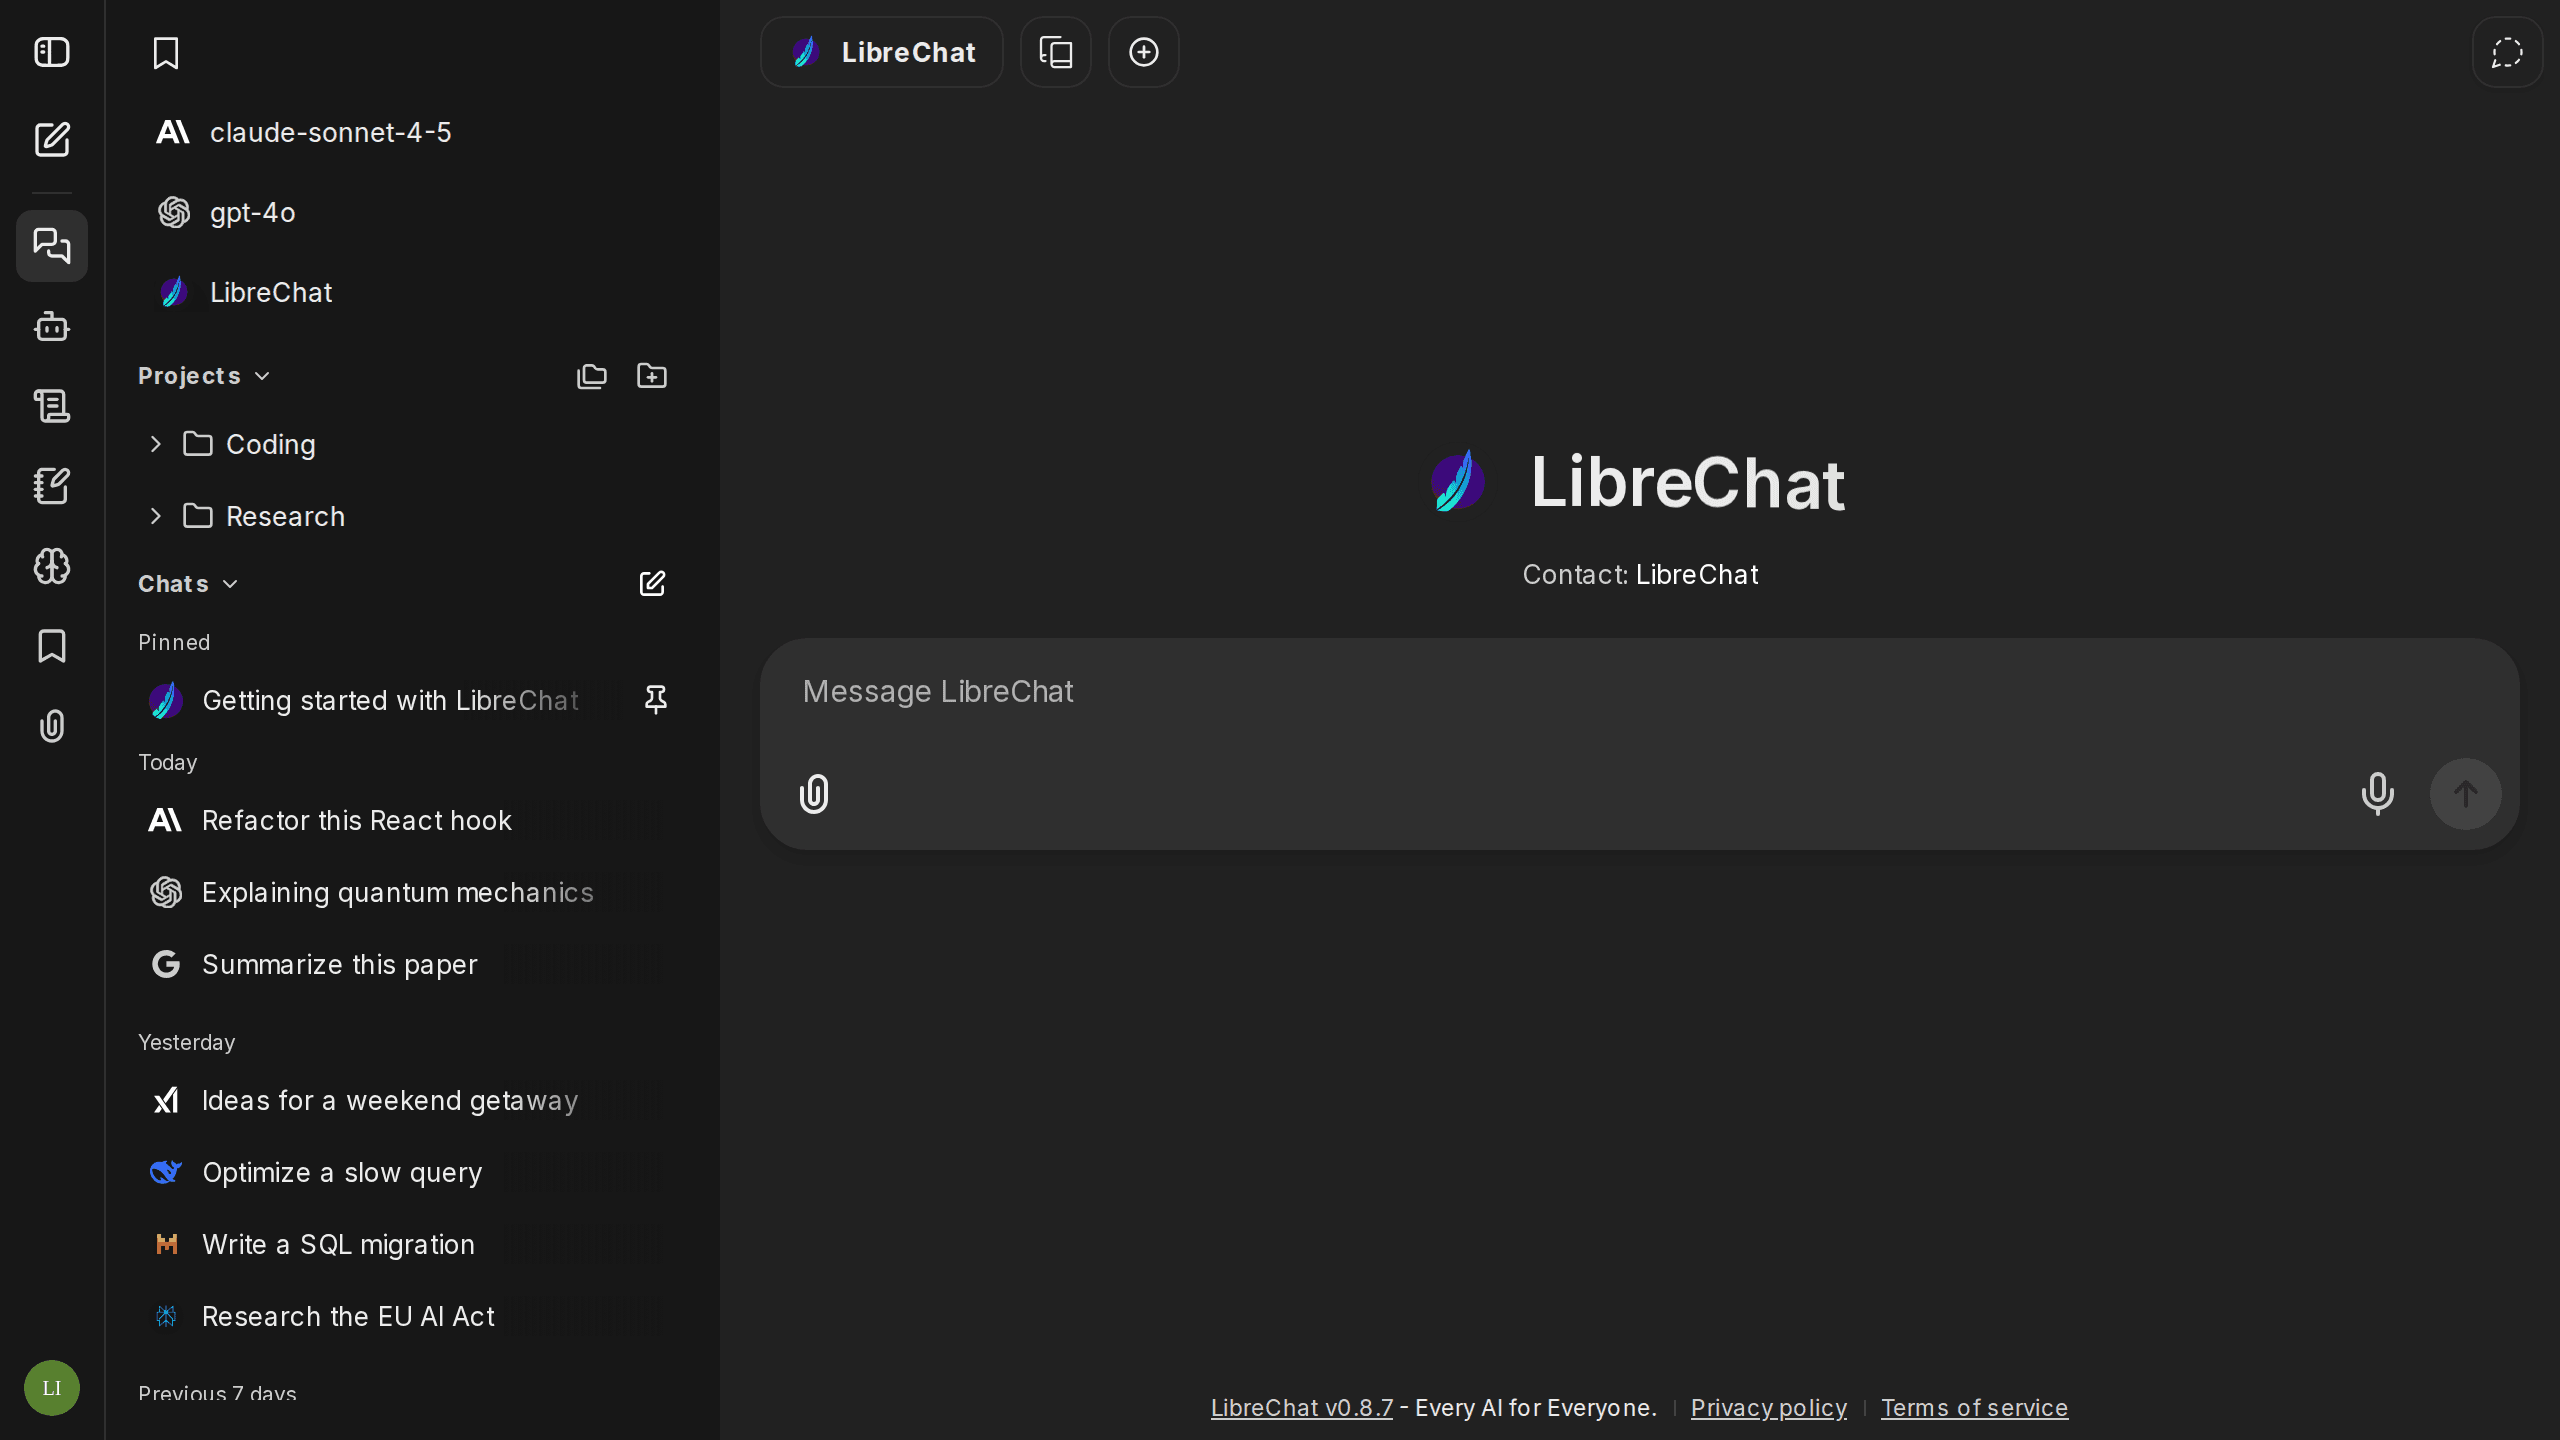
O LibreChat é uma excelente opção para quem pretende usar modelos locais e na cloud numa única interface de assistente avançada. O conjunto atual de funcionalidades inclui agentes, RAG, chat multimodal, execução de código, artefactos, pesquisa na Web, memória persistente e amplas opções de autenticação.
A funcionalidade de destaque é a integração do Model Context Protocol. Os servidores MCP podem ser disponibilizados diretamente no chat ou associados a agentes específicos, o que é útil para ligar um assistente privado a ficheiros, bases de dados, automatização ou serviços internos do laboratório doméstico.
- Ideal para: criadores de agentes, programadores e instalações avançadas multiutilizador.
- Escolha-o quando: as ferramentas e a flexibilidade de fornecedores forem mais importantes do que uma configuração simples.
- Atenção a: uma área de configuração mais ampla do que a das interfaces leves, apenas de chat.
3. LobeHub — Melhor espaço de trabalho pessoal de IA, com um design cuidado
LobeHub, anteriormente conhecido como LobeChat, destaca-se pela interface refinada e pelo amplo suporte a fornecedores de modelos. A integração com o Ollama permite que modelos alojados localmente apareçam no mesmo espaço de trabalho moderno que os agentes e os modelos fornecidos por outros fornecedores.
Também suporta o carregamento de ficheiros e fluxos de trabalho com bases de conhecimento, mas a implementação completa no servidor requer mais infraestrutura de suporte do que uma interface apenas de navegador. Escolha-o quando a apresentação, a organização dos agentes e um espaço de trabalho pessoal completo forem mais importantes do que ter o mínimo de contentores.
- Ideal para: utilizadores que valorizam a qualidade da interface e assistentes de IA organizados.
- Escolha-o quando: quiser aceder ao Ollama localmente sem abdicar de um espaço de trabalho bem concebido.
- A ter em conta: as diferenças entre implementações de cliente simples e funcionalidades completas com base de dados.
4. AnythingLLM — O melhor para documentos privados e RAG
AnythingLLM centra-se em transformar ficheiros privados em espaços de trabalho de IA úteis. Combina ingestão de documentos, embeddings, armazenamento vetorial, chat e agentes numa única aplicação, reduzindo o número de componentes que um principiante tem de configurar por conta própria.
A edição Docker suporta acesso pelo navegador, vários utilizadores, permissões de espaço de trabalho e ligações a LLMs locais. É uma melhor primeira escolha do que uma interface de chat genérica quando o principal requisito é fazer perguntas sobre manuais, notas, investigação ou arquivos domésticos.
- Ideal para: perguntas e respostas sobre documentos e RAG local pronto a usar.
- Escolha-o quando: os ficheiros forem o centro do fluxo de trabalho.
- A ter em conta: as escolhas de embeddings e bases de dados vetoriais, que afetam a qualidade da recuperação independentemente do modelo de chat.
5. text-generation-webui — O melhor para controlo de modelos e inferência
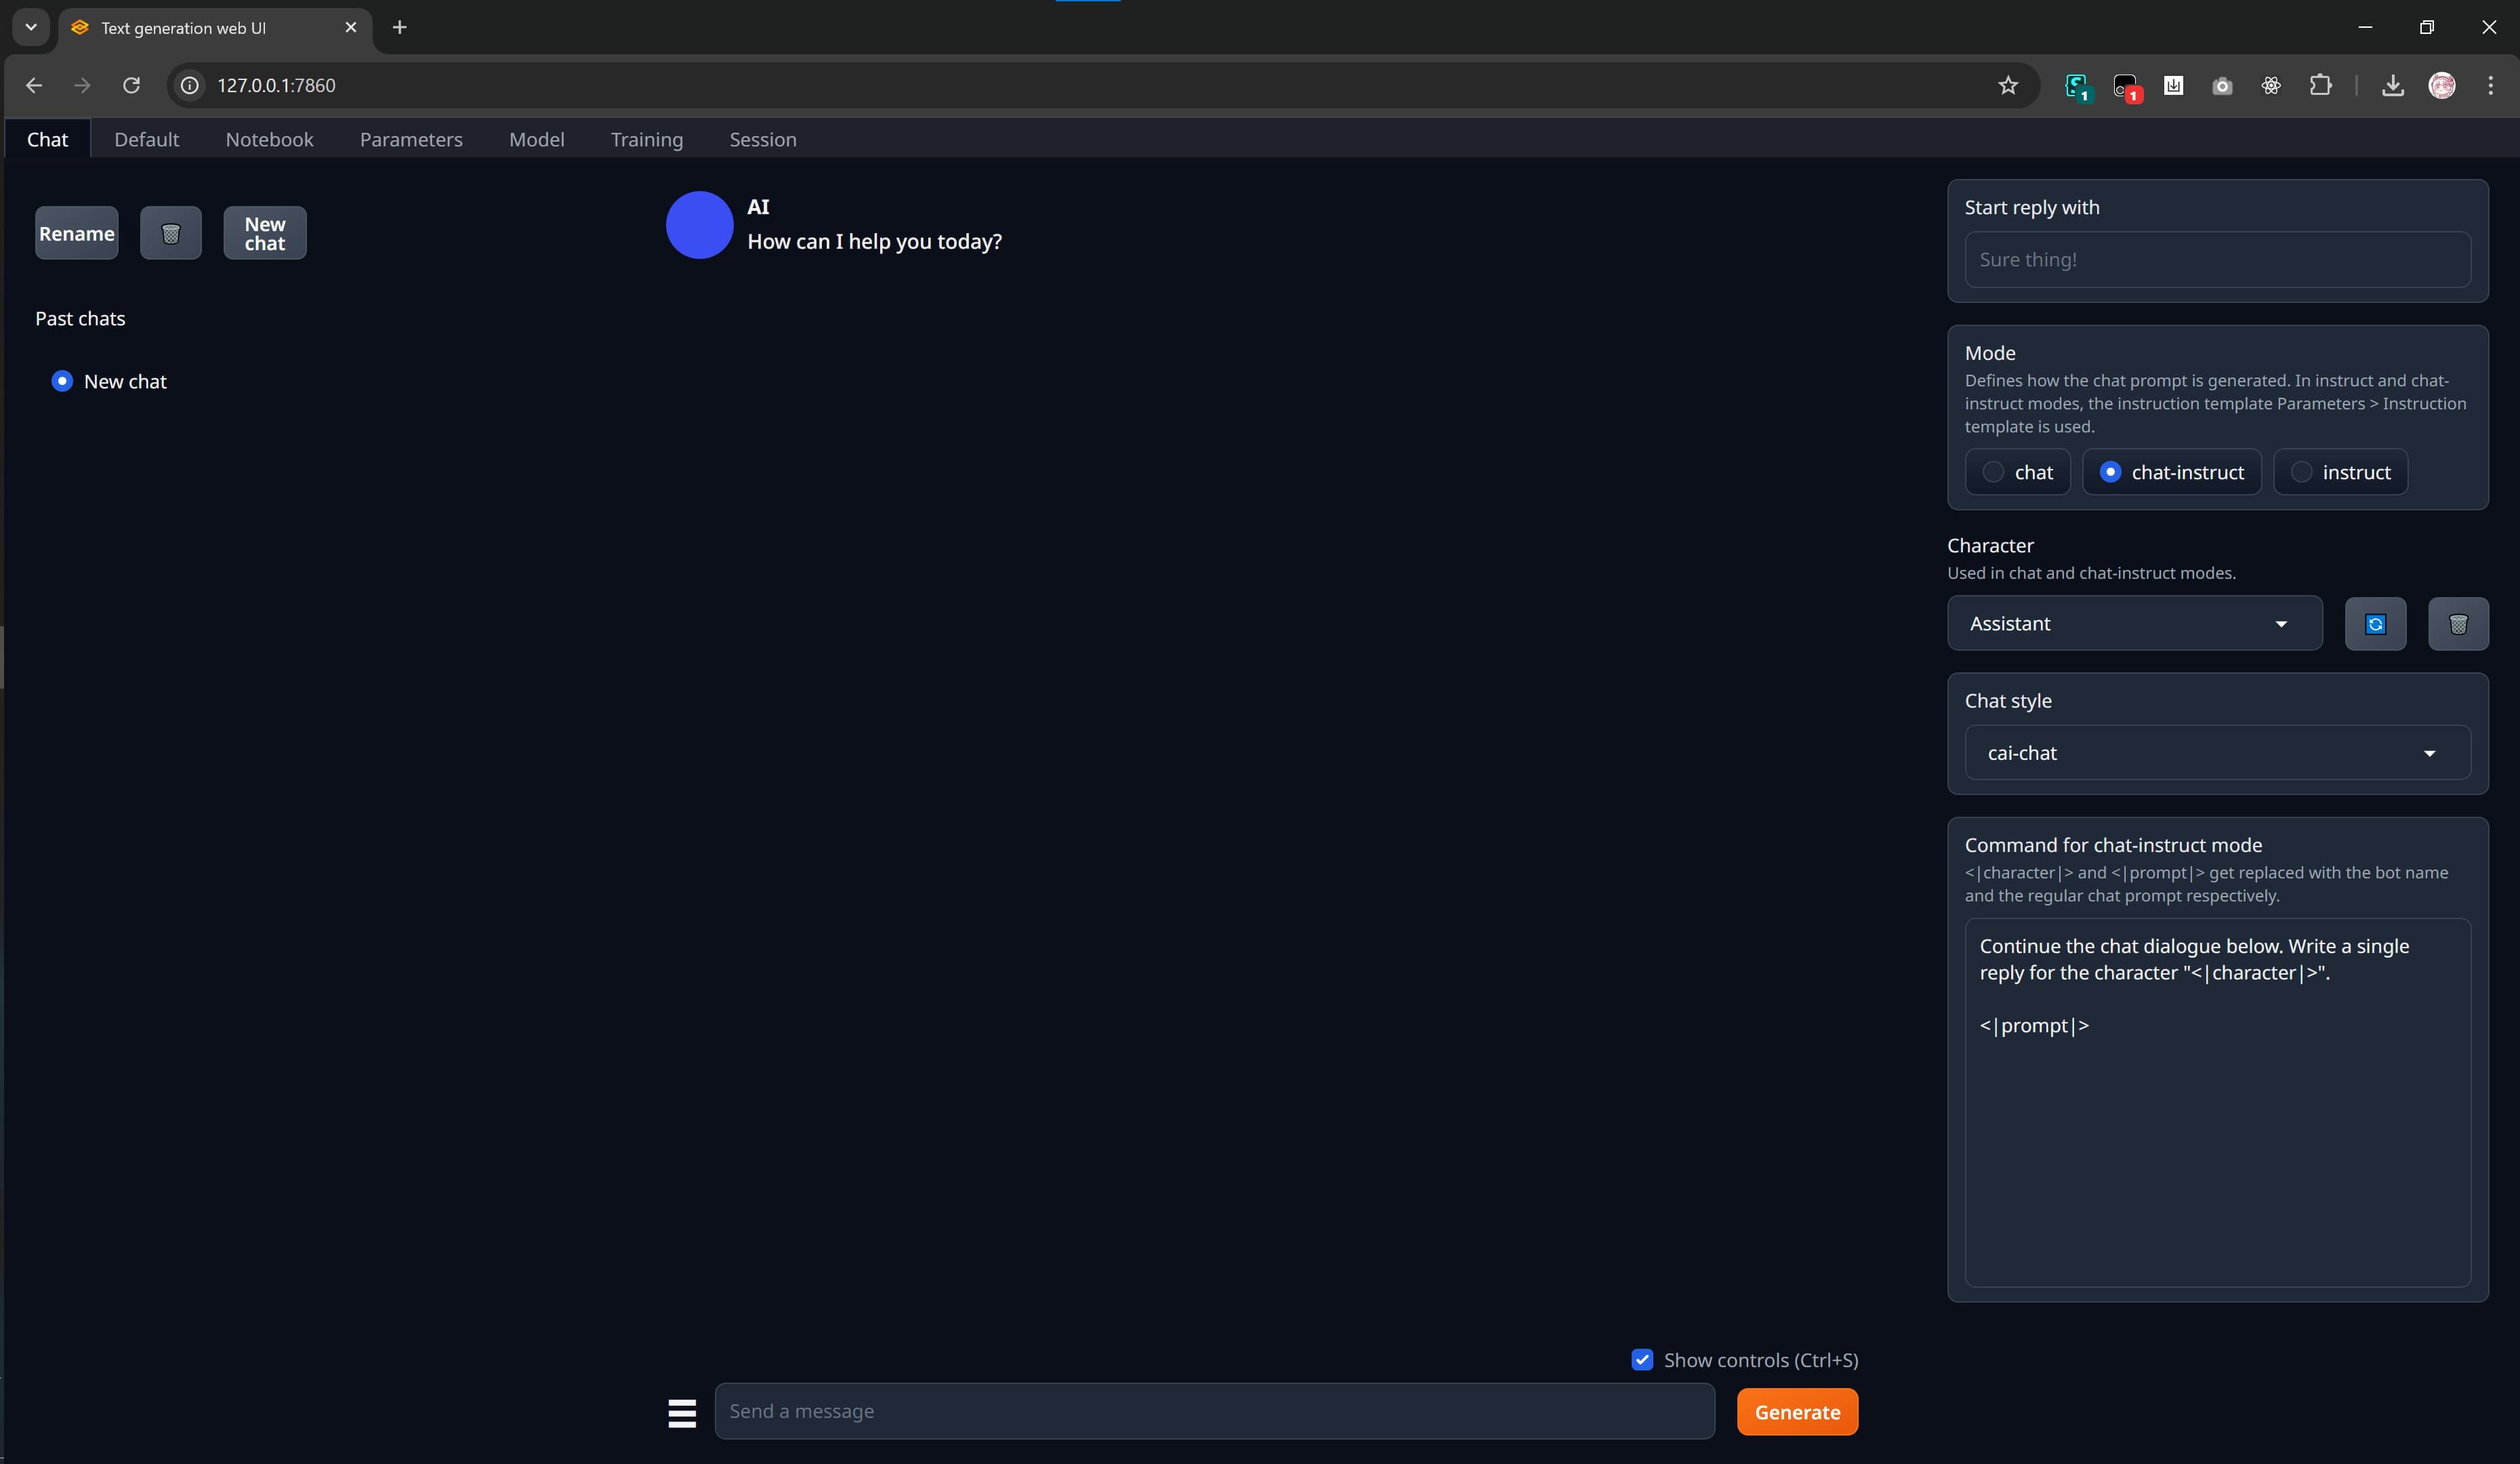
text-generation-webui é uma interface de navegador e um ambiente flexível de inferência local. Suporta vários backends, incluindo llama.cpp, Transformers, ExLlama e TensorRT-LLM, ao mesmo tempo que disponibiliza o carregamento de modelos, a amostragem, os modelos de prompt, as extensões e uma API compatível com OpenAI/Anthropic.
Isto torna-o útil para testar quantizações ou ajustar o comportamento de geração antes de colocar outra interface à frente. É menos indicado como portal doméstico, porque a administração multiutilizador e a gestão de conhecimento pronta a usar não são os seus pontos fortes.
- Ideal para: entusiastas que comparam carregadores, formatos e definições de geração.
- Escolha-o quando: o controlo sobre a inferência for mais importante do que uma experiência refinada para vários utilizadores.
- Atenção: não exponha uma interface poderosa de gestão de modelos para além da rede local de confiança.
6. Big-AGI — Ideal para comparar vários modelos
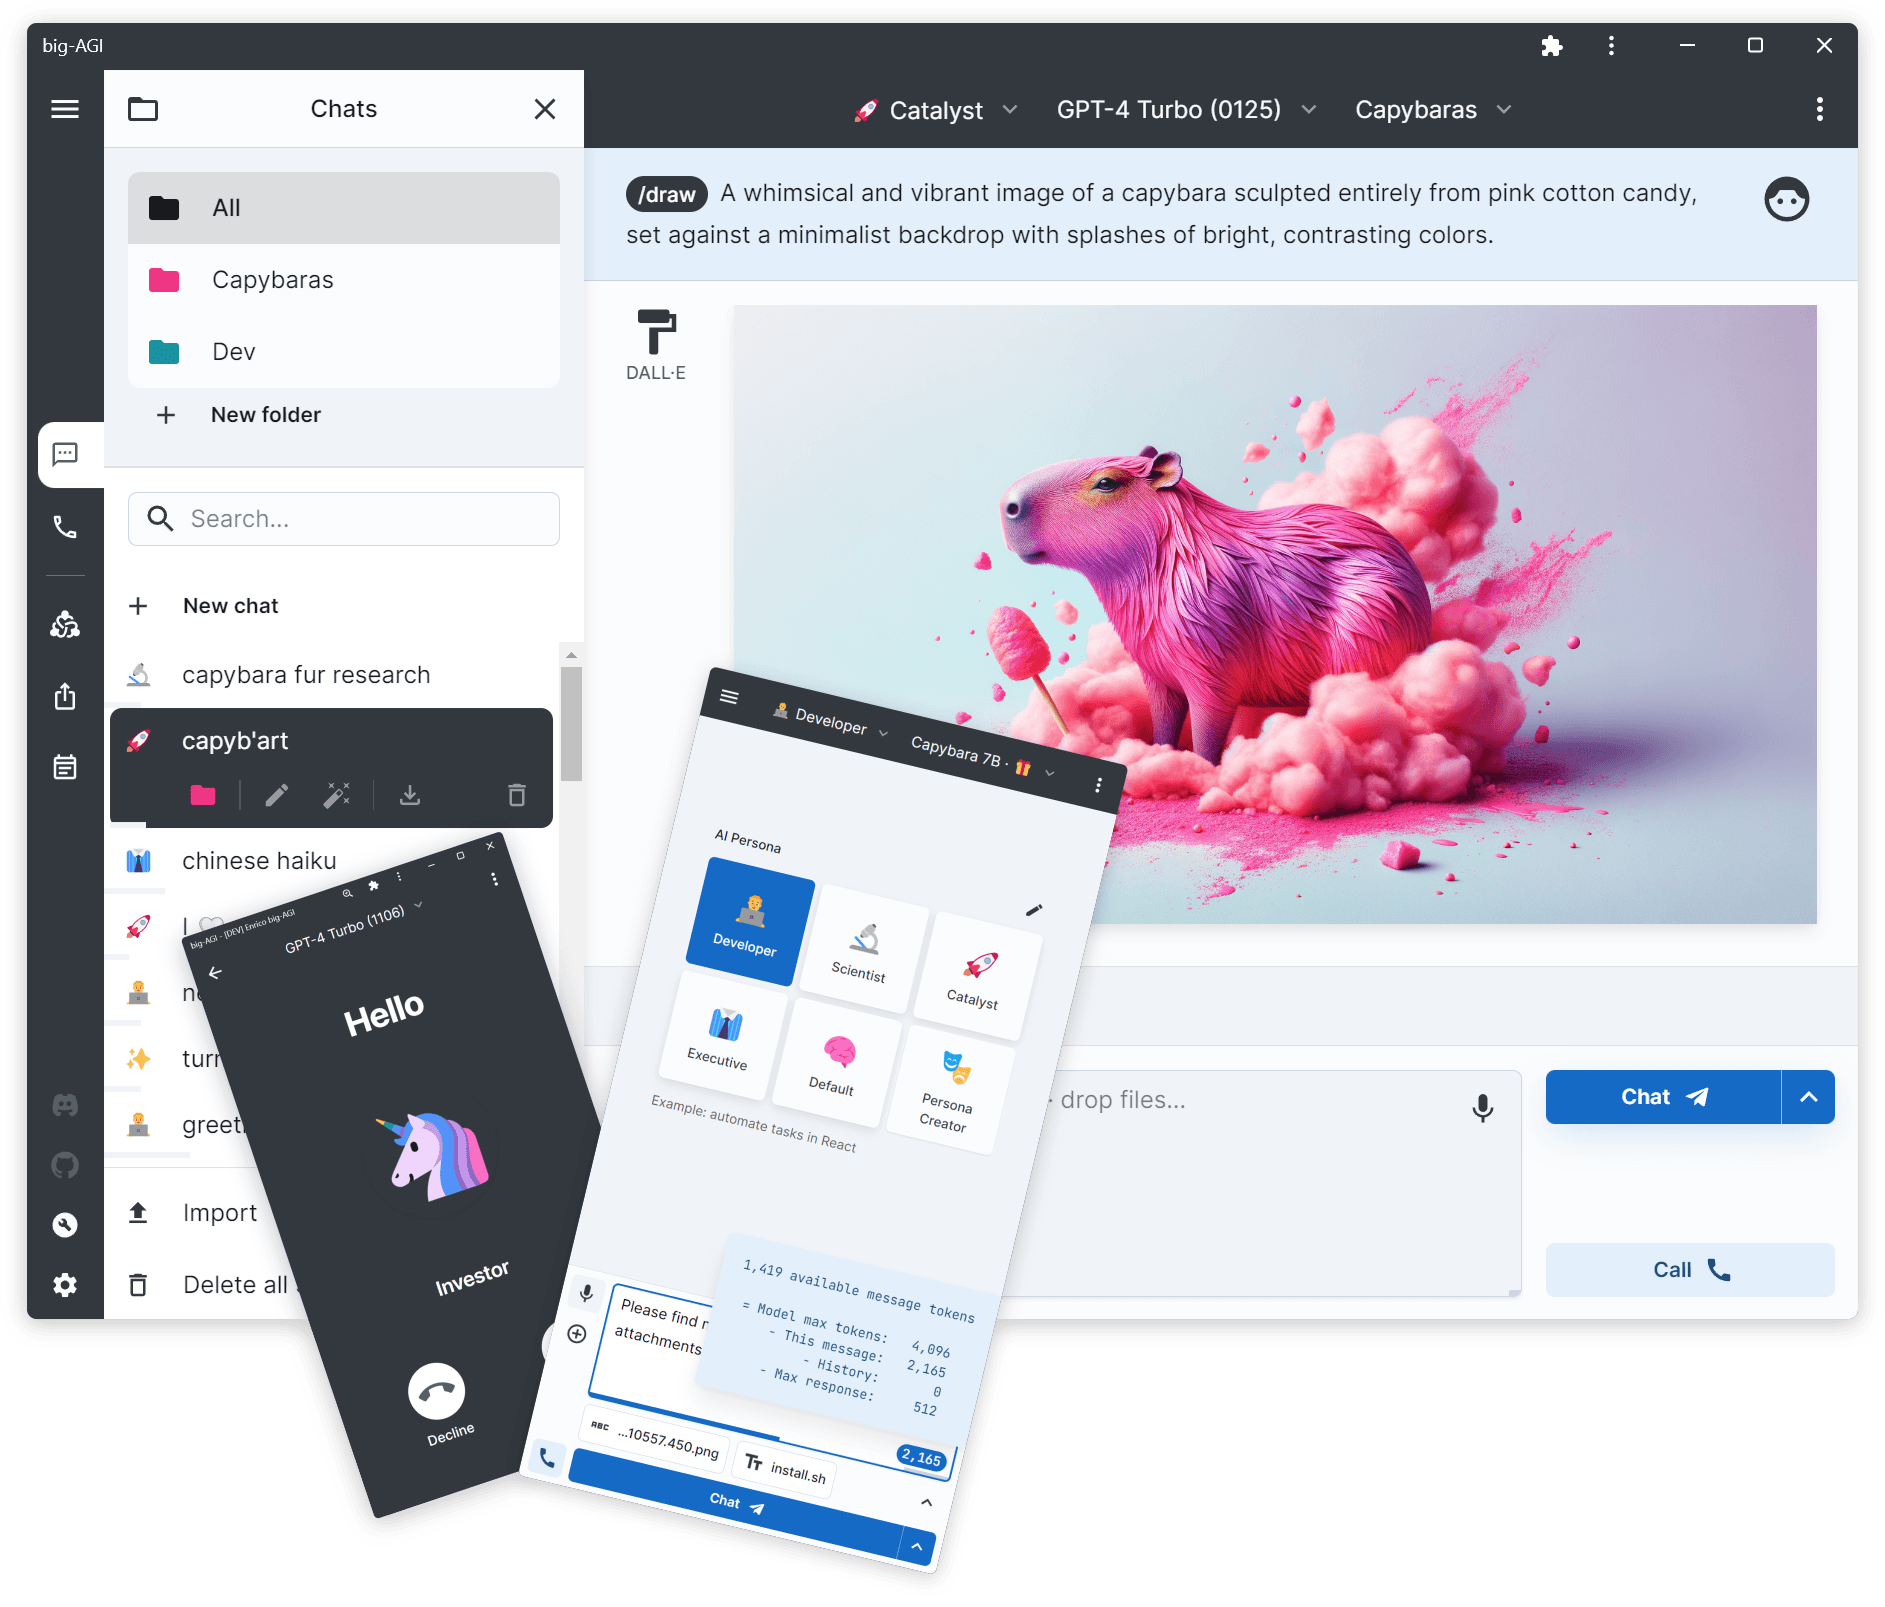
Big-AGI Open foi concebido como um espaço de trabalho multimodelo, e não como uma cópia de conversação de um único fornecedor. Pode ligar-se ao Ollama, ao LM Studio, ao LocalAI e a inúmeros fornecedores alojados, permitindo que respostas locais e na nuvem coexistam numa interface orientada para a investigação.
Os seus fluxos de trabalho de comparação e síntese são úteis quando pretende que vários modelos abordem o mesmo problema. A edição Open autoalojada não inclui contas de utilizador nativas, pelo que é mais adequada a um investigador individual do que a uma instalação partilhada por um agregado familiar, a menos que o acesso seja gerido por um proxy inverso.
- Ideal para: investigação, comparação de modelos e trabalho híbrido local e na nuvem.
- Escolha-o quando: alternar entre modelos ou compará-los for essencial para o fluxo de trabalho.
- Atenção: os fornecedores na nuvem podem comprometer um fluxo de dados que, de resto, é local.
7. NextChat — Ideal como interface de IA local leve

NextChat é uma interface de assistente pequena, rápida e adaptável, que pode ser implementada com Docker ou como aplicação Web. Suporta URLs base de API personalizadas, modelos implementados por si através de endpoints compatíveis, máscaras de prompt, respostas em fluxo contínuo, utilização como PWA e suporte opcional para MCP.
É uma opção atrativa quando o servidor doméstico deve dedicar os seus recursos à inferência, em vez de a uma pilha de frontend pesada. O seu mecanismo de código de acesso é mais simples do que a gestão completa de identidades e permissões para vários utilizadores, por isso, use um proxy inverso seguro se houver várias pessoas envolvidas ou acesso remoto.
- Ideal para: conversação leve em telemóveis, tablets e servidores mais antigos.
- Escolha-o quando: a rapidez e a simplicidade forem mais importantes do que o RAG integrado.
- Atenção: não trate um código de acesso partilhado como uma solução de segurança completa.
8. SillyTavern — Ideal para personas e controlo de prompts

SillyTavern é uma interface de navegador instalada localmente, destinada a utilizadores que pretendem um controlo aprofundado sobre personagens, personas, construção de prompts, conhecimento do mundo, definições de geração, conversão de texto em voz e ligações a geradores de imagens. Pode ligar-se a uma vasta gama de APIs locais de geração de texto.
Embora seja mais conhecido pela interpretação de papéis e pela escrita criativa, o Data Bank acrescenta aos prompts conhecimento baseado na recuperação de informação. A interface tem uma curva de aprendizagem mais acentuada e foi concebida sobretudo para uso pessoal, mas poucas alternativas oferecem o mesmo nível de controlo sobre conversas e personas.
- Ideal para: escrita criativa, interpretação de papéis, personas e criação avançada de prompts.
- Escolha-o quando: for essencial controlar a forma como os prompts são compostos.
- Atenção a: configuração complexa e extensões de terceiros.
9. Dify — Ideal para criar aplicações de IA autoalojadas
Dify é mais exigente do que uma interface de chat típica porque é uma plataforma de aplicações de IA. Disponibiliza orquestração visual, bases de conhecimento, agentes, fluxos de trabalho, plug-ins, registos e aplicações Web publicáveis, com modelos locais ou remotos.
A implementação oficial com Docker Compose inicia vários serviços essenciais e de suporte, pelo que o Dify é mais adequado a um servidor doméstico potente do que a um sistema pequeno de placa única. Escolha-o quando quiser conceber ferramentas reutilizáveis para a família ou aplicações internas, e não apenas substituir uma página de chat.
- Ideal para: criar, testar e publicar aplicações de IA.
- Escolha-o quando: os fluxos de trabalho, os pipelines de conhecimento e as interfaces reutilizáveis justificarem o esforço adicional.
- Atenção a: quantidade de contentores, cópias de segurança da base de dados, atualizações e utilização de recursos.
10. Flowise — Melhor interface visual para fluxos de trabalho de IA
Flowise é uma plataforma visual para criar fluxos de chat, fluxos de agentes, ferramentas, componentes de recuperação e ligações a modelos. Suporta implementações autoalojadas e isoladas de redes externas e pode ligar-se a modelos locais através de componentes como o Ollama.
O Flowise merece estar nesta lista porque o seu construtor visual e as interfaces de chat incorporáveis são úteis num laboratório doméstico, mas não é o melhor cliente de chat de uso geral para o dia a dia. Justifica a sua presença quando a interface se destina a conceber a lógica do assistente.
- Ideal para: prototipagem visual de agentes e pipelines de RAG.
- Escolha-o quando: quiser criar fluxos sem escrever a aplicação inteira.
- Atenção a: proteger credenciais, endpoints de fluxos e permissões das ferramentas.
Que interface Web de IA local deve escolher?
- Escolha o Open WebUI para a melhor experiência geral de laboratório doméstico.
- Escolha o LibreChat para ferramentas MCP, agentes e utilização avançada com vários fornecedores.
- Escolha o LobeHub para um espaço de trabalho pessoal bem concebido.
- Escolha o AnythingLLM quando a prioridade forem os documentos privados e o RAG.
- Escolha text-generation-webui quando precisar de controlo direto sobre o carregamento de modelos e a inferência.
- Escolha Big-AGI para comparar modelos locais e na nuvem num único espaço de trabalho.
- Escolha NextChat para uma interface de conversação leve.
- Escolha SillyTavern para personagens, interpretação de papéis e engenharia de prompts.
- Escolha Dify ou Flowise quando estiver a criar uma aplicação ou um fluxo de trabalho de IA.
Uma arquitetura prática para um laboratório doméstico
Uma configuração fiável separa quatro camadas: a interface Web, o servidor de inferência, a camada de dados e o acesso remoto. A interface pode ser executada num pequeno contentor Docker, enquanto o Ollama, o llama.cpp ou outro ambiente de execução utiliza o anfitrião com GPU. Os documentos, ficheiros de modelos, bases de dados e cópias de segurança podem permanecer numa NAS, com um proxy inverso ou uma VPN privada a controlar o acesso através do navegador.
Esta separação facilita as atualizações e impede que uma falha do frontend afete os modelos armazenados ou os ficheiros privados. Também permite manter um servidor de baixo consumo ligado 24 horas por dia, enquanto uma máquina com GPU só é ativada para tarefas de inferência exigentes. A comparação entre um laboratório de IA compacto e uma NAS de IA completa mostra como estas funções podem ser distribuídas.
Executar uma interface Web de IA local em hardware Zima
ZimaBoard 2 é um anfitrião sempre ligado e prático para interfaces Web leves, proxies inversos, autenticação, bases de dados pequenas e orquestração. Pode ligar-se por rede ao Ollama ou a outro servidor de inferência com uma GPU dedicada. É possível utilizar modelos pequenos no CPU, mas a sua função principal é coordenar serviços, não substituir uma estação de trabalho de IA de gama alta.
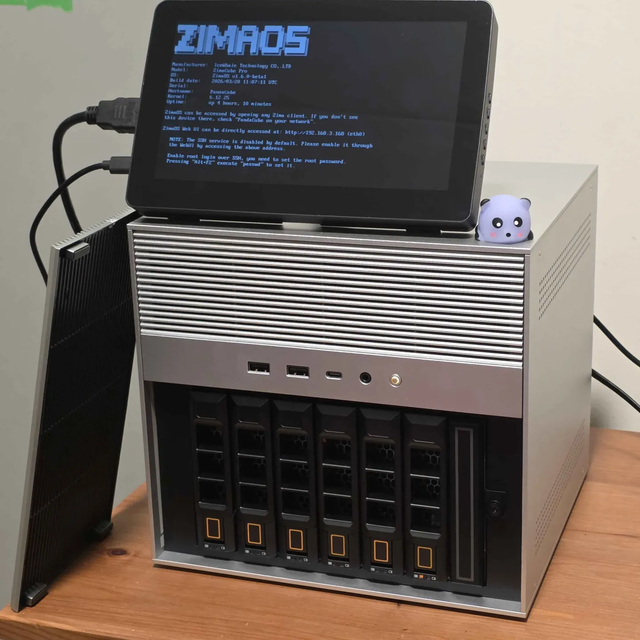
ZimaCube 2 acrescenta armazenamento expansível para pesos de modelos, bases de conhecimento, ficheiros carregados e cópias de segurança. Isso torna-a uma camada de dados ideal para Open WebUI, AnythingLLM, LibreChat, Dify ou Flowise. Para ver um exemplo detalhado, descubra como um fluxo de trabalho de NAS com IA ZimaCube 2 combina armazenamento com pesquisa privada e funcionalidades de assistente.
Lista de verificação de segurança antes de expor a interface
- Não encaminhe diretamente a porta da aplicação para a Internet. Utilize uma VPN ou um proxy inverso com TLS e autenticação robusta.
- Crie contas de utilizador separadas, sempre que possível. Não partilhe uma sessão de administrador com as restantes pessoas da casa.
- Restrinja os pontos de acesso a modelos e ferramentas. O Ollama, as bases de dados, os servidores MCP e os serviços de execução de código devem permanecer em redes de confiança.
- Mantenha os dados da aplicação e faça cópias de segurança. O histórico de conversas, os repositórios vetoriais, a configuração e os documentos carregados devem ser preservados quando um contentor é substituído.
- Verifique as ligações de saída. Os modelos na cloud, a pesquisa na Web, os fornecedores de serviços de voz, os plugins e a telemetria podem enviar dados para fora do laboratório doméstico.
- Atualize de forma deliberada. Fixe versões de contentores que sabe serem estáveis, leia as notas de migração e mantenha uma cópia de segurança pronta para reposição.
Se está a decidir entre contentores e a instalação direta, o guia sobre o Docker e as aplicações de IA locais instaladas diretamente aborda o isolamento, o acesso à GPU, as atualizações e a resolução de problemas.
Perguntas frequentes
Qual é a melhor interface Web para o Ollama?
O Open WebUI é a escolha padrão mais indicada para a maioria dos utilizadores do Ollama, pois oferece uma ligação simples, vários utilizadores, RAG, ferramentas, anexos e uma interface adequada à utilização diária. O NextChat é mais leve, enquanto o LibreChat é melhor para agentes e integrações MCP.
Uma interface Web de IA local pode funcionar numa máquina diferente daquela onde está o modelo?
Sim. A interface Web pode funcionar num servidor doméstico de baixo consumo e ligar-se pela LAN ao Ollama, vLLM, LocalAI ou a outro serviço de inferência compatível numa máquina com GPU. Esta é, muitas vezes, a configuração mais eficiente para um laboratório doméstico.
Alojar a interface num servidor próprio garante privacidade?
Não. A privacidade depende de todos os pontos de acesso configurados. Uma interface local ligada a um modelo na cloud ou a um fornecedor de pesquisa externo pode continuar a transmitir prompts e ficheiros. Verifique as APIs dos modelos, as incorporações, as ferramentas, os serviços de voz, os plugins e os registos.
Qual é a melhor interface para conversar com documentos privados?
O AnythingLLM é a opção pronta a usar mais focada em RAG baseado em documentos. O Open WebUI e o LibreChat são melhores se o chat com documentos for apenas uma de várias funcionalidades, enquanto o Dify e o Flowise são adequados para pipelines de recuperação personalizados.
Preciso de uma GPU para alojar a interface Web?
Não. A própria interface costuma funcionar no CPU. A GPU é utilizada pelo servidor do modelo, que pode estar na mesma máquina ou noutro sistema. Esta separação permite que um servidor eficiente mantenha a interface sempre disponível.
Veredicto final
O Open WebUI é o melhor ponto de partida para a maioria dos laboratórios de IA domésticos locais, pois combina facilidade de utilização, suporte para modelos locais, RAG, ferramentas e acesso multiutilizador. Escolha o LibreChat para instalações com muitos agentes, o AnythingLLM para documentos privados, o text-generation-webui para controlar a inferência e o Dify ou o Flowise para criar aplicações. A interface certa é aquela que acrescenta as capacidades de que precisa sem transformar um serviço doméstico privado numa plataforma desnecessariamente complexa.

Produtos recomendados


CENTRO DE TECNOLOGIA E IA
Mais para ler
Fixação de versões de embeddings: porque os vetores de consulta e de documentos têm de permanecer compatíveis
Uma explicação centrada no mecanismo da fixação de versões de embeddings, dos seus compromissos relativamente a recursos partilhados, de três perguntas frequentes sobre a...
Armazenamento de modelos endereçado por conteúdo: como os hashes evitam transferências duplicadas de pesos
Uma explicação sobre o armazenamento de modelos endereçado por conteúdo, centrada no mecanismo, as suas contrapartidas enquanto recurso partilhado, três perguntas frequentes sobre a...
Ações de compensação de agentes: como os passos reversíveis limitam as falhas parciais dos fluxos de trabalho
Uma explicação baseada nos mecanismos das ações de compensação de agentes, das suas contrapartidas em recursos partilhados, três perguntas frequentes sobre a ramificação de...


