
Porque é que o consumo de energia da GPU aumenta bruscamente no início de um pedido de inferência local?


A potência da GPU aumenta frequentemente no início de um pedido, porque o aumento da frequência e o prefill altamente paralelo do prompt ativam mais capacidade de processamento em simultâneo do que a descodificação token a token.
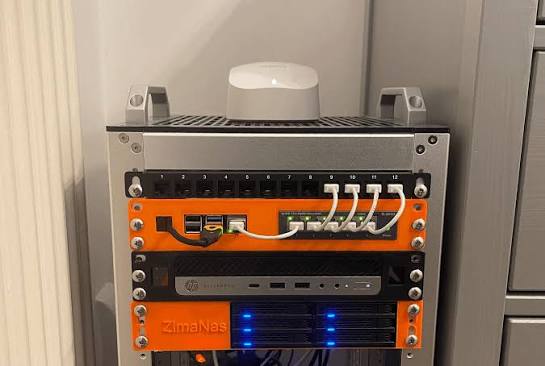
Um servidor doméstico pode permanecer silencioso em inatividade, aproximar-se do limite de potência da GPU durante um breve intervalo e depois estabilizar enquanto o modelo transmite tokens. A transição combina alterações ao estado de energia do dispositivo, alocação de memória, inicialização de kernels e prefill do prompt. O tamanho do modelo, o comprimento do prompt, o tamanho do lote, a política de frequência, a quantização, o intervalo de medição e outras cargas de trabalho do acelerador determinam a amplitude e a duração do pico observado.
A GPU Sai do Estado de Inatividade Quando Chega Trabalho
As GPUs modernas reduzem a frequência e a tensão quando são pouco utilizadas e aumentam-nas quando surgem kernels e tráfego de memória. O primeiro pedido também pode criar um contexto de dispositivo, inicializar bibliotecas, alocar buffers e carregar kernels, concentrando a atividade pontual na mesma janela de início.
picos de potência no início dos pedidos caracteriza as oportunidades de gestão de energia para cargas de trabalho de LLM e relata picos de potência no início dos pedidos de inferência. O estudo associa esses picos à fase de prefill, intensiva em computação, e analisa de que forma a frequência da GPU afeta a latência e a potência.
Uma amostra de monitorização pode exagerar ou ocultar a forma do pico. Uma média de um segundo pode juntar o aumento da frequência, o prefill e a descodificação inicial num único ponto, enquanto uma tomada inteligente lenta pode não detetar o evento da GPU ou registar apenas a resposta tardia de todo o sistema.
O Prefill Utiliza a Computação Paralela de Forma Diferente da Descodificação
O prefill processa os tokens do prompt em conjunto para criar a cache KV, expondo multiplicações de matrizes que podem ocupar muitos núcleos da GPU. A descodificação avança um token por sequência e é frequentemente mais limitada pelo movimento de dados e pela dependência sequencial, especialmente com um tamanho de lote de um.
medição de potência alinhada com as fases alinha as amostras de potência da GPU, do nó e do sistema com o prefill e a descodificação de cada pedido. O seu método sensível às fases mostra por que motivo um único total de energia não explica quando ocorre a potência de pico nem quais as variáveis do prompt e do serviço que a produziram.
Prompts mais longos ou lotes maiores podem prolongar o intervalo de elevada utilização, enquanto a quantização e os kernels fundidos alteram tanto a exigência computacional como a de memória. Os watts de pico, os watts médios e os joules por token concluído respondem a perguntas diferentes e não devem ser utilizados como substitutos uns dos outros.
Os Limites de Potência Reformulam o Pico em Vez de Eliminarem o Trabalho
Um limite inferior de potência ou de frequência pode reduzir o pico instantâneo, mas o prefill pode demorar mais tempo. A energia total pode diminuir, manter-se semelhante ou aumentar, dependendo da eficiência no ponto de funcionamento selecionado e de o pedido mais lento atrasar ou não outro trabalho em fila.
controlo de frequência sensível às fases controla as frequências separadamente para o prefill e a descodificação, protegendo simultaneamente os objetivos de latência. As poupanças de energia comunicadas demonstram que o controlo sensível às fases pode superar uma política fixa única, mas o resultado depende das classes de carga de trabalho e das restrições do nível de serviço.
O erro está em equiparar um breve pico da GPU a uma potência de parede insegura. A fonte de alimentação vê todo o sistema, incluindo CPU, unidades, ventoinhas e perdas de conversão, enquanto os sensores de software comunicam a potência do chip com a sua própria cadência. As decisões de segurança elétrica exigem medição ao nível da tomada e margem para transientes.

Alinhe as Amostras de Potência com as Fases da Inferência
Execute prompts fixos com 32, 512, 2K e 8K tokens de entrada e um comprimento de saída constante e, em seguida, repita com dois tamanhos de lote. Registe a potência da GPU, as frequências, a utilização, a temperatura, a potência do sistema medida na tomada, a chegada do pedido, a prontidão do modelo, o início e o fim do prefill, o primeiro token e a conclusão da descodificação.
Utilize a distinção entre fases em potência de arranque do servidor doméstico para calcular os watts de pico, os joules do prefill, os joules da descodificação, os joules por token, o TTFT e a latência p95 entre tokens. Repita uma vez com um limite de potência e outra após um longo intervalo de inatividade.
Mantenha uma política de potência apenas se esta respeitar simultaneamente a margem de potência na tomada, a temperatura e a latência. Se reduzir o pico prolongar o prefill o suficiente para aumentar a energia ou o atraso na fila, encare o gráfico mais suave como uma melhoria estética, e não como um ganho de eficiência.

Produtos recomendados

Centro de Tecnologia e IA
Mais para Ler

Porque é que a classificação da pesquisa vetorial muda quando são consultados vários segmentos de índice em conjunto?
Saiba como os limites de candidatos por segmento, os grafos aproximados, a calibração de pontuações, as atualizações e a consolidação alteram a classificação da...

Porque é que os grupos de deduplicação de fotografias se dividem depois de os metadados serem editados?
Veja como os hashes exatos, os hashes percetivos, a orientação EXIF, os carimbos de data e hora, os limiares e as versões do pipeline...
Porque é que um assistente de voz local se interrompe numa sala reverberante?
Saiba como os caminhos de eco acústico, a reverberação, os altifalantes não lineares, a fala simultânea e os limiares de interrupção fazem com que...


