
Liquid AI LFM3を解説:2Bのマルチモーダルモデルはローカルで動作するのか?


はい、LFM3はローカルで実行できます。ただし、まず適切なチェックポイントを選びましょう。Liquid AIは2026年10月27日に、オープンウェイトのLFM3ファミリーをリリースしました。テキストモデルのLFM3-1.7Bは17.3億パラメーターで、4ビット量子化時の重みの容量は約1 GBとされています。最新のllama.cppビルドを使えば、GGUFチェックポイントをローカルのCPUまたは対応GPUで実行できます。ただし、音声とビジョンに対応したアシスタント全体のメモリ使用量が1 GBだけという意味ではありません。
PCやホームNASで使う際は、まずテキスト、ビジョン、オーディオ、オムニのどれを使うか決めてから、ハードウェアの構成を検討しましょう。モデルファイル、エンコーダー/デコーダー、ランタイムバッファー、コンテキスト状態、画像や音声の入力、同時リクエストは、いずれもリソースを消費します。まずは4ビットのテキストモデル、コンテキスト長4K~8K、リクエスト1件で試し、入力を増やしたりNASの他のサービスを有効にしたりする前に、メモリ使用量とレイテンシを測定してください。
| ローカル導入に関する疑問 | 簡単に言うと |
|---|---|
| 公式チェックポイントは入手できますか? | はい。Liquid AIがオープンウェイトモデルとモデルカードを公開しています。 |
| すべての機能を備えた2Bモデルは1つありますか? | いいえ。LFM3は、共通の基盤を持つ特化型チェックポイントのファミリーです。 |
| ホームサーバーでテキスト推論を実行できますか? | 選択したGGUFモデルとランタイムが利用可能なRAMに収まる場合は、はい。CPUのみの動作では遅くなる場合があります。 |
| 1 GBは実行時のRAM全体を指しますか? | いいえ。これはテキストモデルの重みの容量がおよそ4ビット量子化でどれくらいかを示すもので、プロセスのピークメモリ使用量ではありません。 |
| 8 GBのRAMでコンテキスト長256Kを実用的に使えますか? | そうとは限りません。実行時のメモリ使用量は、コンテキスト長、リクエスト数、バックエンドによって変わります。 |
| ZimaOSでホストできますか? | 対応するLinuxランタイムで動作させることは現実的な選択肢ですが、この記事はZimaOSとの互換性を認定するものではありません。 |
Liquid AIはLFM3で何をリリースしたのか?
LFM3は、LFM3-1.7B-Baseを基盤として学習された、20億パラメーター級モデル6種のコレクションです。テキストモデル、ビジョン・言語モデル、オーディオモデル、オムニモデル、および意思決定に特化した2つのモデルで構成されています。Liquid AIは、このファミリーがデバイス上での特化型アプリケーションに適していると説明しています。重要なのは「ファミリー」という点です。LFM3-1.7Bをダウンロードしても、画像エンコーダー、マイク対応、音声デコーダーが自動的に追加されるわけではありません。LFM3の発表とモデルファミリーの概要をご覧ください。
| 公式チェックポイント | 主な入出力 | 公開されている情報 | ローカル導入時の注意点 |
|---|---|---|---|
| LFM3-1.7B | テキストからテキストへ、構造化レスポンスとツール | 17.3億パラメーター、コンテキスト長256K | モデルの重みは小さいものの、コンテキスト長と同時処理数は別途見積もる必要があります。 |
| LFM3-VL-2B | テキスト、画像、動画からテキストへ | 合計19.2億パラメーター、コンテキスト長128K | ビジョンエンコーダー、画像トークン、ビデオフレームはコストを増加させます。 |
| LFM3-Audio-2B | オーディオ/テキストからテキストまたは音声を生成 | 約2B、コンテキスト32K、対応音声言語18種類 | オーディオのフロントエンド、デコーダー、レイテンシーはテキストの重みとは別です。 |
| LFM3-Omni-2B | マルチモーダル入力からテキスト/音声を生成 | ビジョン、オーディオ、テキストで共有する処理経路 | オムニ専用のチェックポイントと対応ランタイムが必要です。 |
| d1-2B / d1-omni-2B | 調整済みの意思決定出力 | VL/Omniモデルを特定用途向けに調整 | 一般的なチャットではなく、想定する意思決定タスクで評価してください。 |
LFM3の重みにはLFM Open License v1.0が適用されます。「オープンウェイト」が正確な表現です。OSIのオープンソースソフトウェアライセンスと同一視せず、想定する配布方法や商用利用について実際のライセンスを確認してください。モデルカードには個別の制限も記載されています。たとえば、小型のテキストモデルは複雑な多段階推論やエージェント型コーディングには推奨されません。
トライハイブリッド・アーキテクチャがエッジデバイスに重要なのはなぜ?
公式のテキストモデルカードによると、1.73Bのテキストバックボーンは24層で構成され、ゲート付き短畳み込み層が13層、スライディングウィンドウ注意機構の層が5層、グローバル注意機構の層が6層あります。これらの処理を組み合わせることで、一部のグローバルコンテキストを維持しながら、すべての層ですべてのトークンをフルグローバル注意機構のように扱う必要性を抑えています。これはレイテンシーとメモリー効率を考慮した設計であり、長いプロンプトの処理コストがなくなるわけではありません。
Liquid AIは22兆トークンで学習したと報告し、以前のLFMモデルよりパラメーターあたりの品質が向上したとしています。これらは開発元が報告した結果であり、独立した家庭用NASのベンチマークとして解釈すべきではありません。アーキテクチャ上の進歩により、約20億パラメーターのモデルでも情報抽出、軽量な質問応答、ツールへの振り分けに役立つ理由が説明できます。一方で、モデルの能力はタスクの難易度、プロンプト、外部検索にも左右されます。

必要なRAM、VRAM、ストレージ容量は?
透過的な計算で確認できます。1.73B × 4ビット / 8 ≈ 0.865 GBが、理想化した場合の重みの生データ量です。量子化メタデータやファイルのパッケージングによって容量は増えるため、Liquid AIは4ビットのテキストモデルのサイズを「約1 GB」と説明しています。ただし、モデルの実行にはコンテキスト状態、実行バッファー、メモリアロケーター、アプリケーションのオーバーヘッドも必要です。実行中のシステムが使用するメモリは、ファイルサイズを大幅に上回る場合があります。
これらは慎重な試用向けの構成であり、公式のモデル最小要件でも、トークン毎秒の達成を保証するものでもありません。単一の4ビットテキストチェックポイントを使い、大規模な同時処理がなく、十分な空きストレージがあることを前提としています。
| ホストのクラス | 妥当な最初のテスト | 主な制約 |
|---|---|---|
| 8 GBのRAM、CPUのみ | テキストGGUF、4Kコンテキスト、ユーザー1人 | CPUのレイテンシーとNASサービスとのリソース競合。 |
| 16 GBのRAM、CPUまたは対応アクセラレーター | まずはテキストから。その後、小規模なVLテスト | マルチモーダルの前処理と大きなコンテキストには実測が必要です。 |
| 適切なGPUと32 GB以上のRAM | より高度なVL/音声パイプラインを試す | ドライバー、バックエンド、プロジェクター/デコーダーの互換性、ピークメモリ。 |
| ZimaCube 2、またはその他の共有NAS | チェックポイントとプロジェクトデータは専用ストレージに保存し、推論用の容量は別に見積もる | ディスク容量でRAM、GPUメモリ、メモリ帯域幅を補うことはできません。 |
公称256Kコンテキストはモデルがサポートする上限であり、推奨される開始設定ではありません。大きなプロンプトや複数の同時セッションでは、ランタイムがさらに多くの状態を保持する場合があります。パラメーター数だけで判断せず、実測したリソース使用量をもとに計画するために、ZimaSpaceのローカルモデルに必要なRAMとGPUの要件と、メモリ使用量全体に基づくモデルの振り分けに関する解説をご覧ください。
ホームNASにはどのLFM3モデルを選ぶべき?
ローカルでのテキストチャット、タグ付け、情報抽出、軽量なツール振り分けなら、LFM3-1.7Bが最も手軽に試せます。スキャンした書類、カメラの静止画、目視検査にはLFM3-VL-2Bを選びましょう。モデルカードによると、言語モデル本体に加えて、1億6400万パラメーターのビジョンエンコーダーと2500万パラメーターのプロジェクターを搭載しています。公式のビジョンモデルカードには、動画のサンプリング方法とフレーム数の上限も記載されています。動画の入力は、短いプレーンテキストのプロンプトを読むよりも多くのリソースを消費します。
音声インタラクションでは、LFM3-Audio-2Bは音声専用システムであり、テキストGGUFの無料アップグレードではありません。多言語音声、文字起こし、音声応答に対応しますが、ストリーミング性能はデバイスによって異なります。複数のモダリティを実際に組み合わせるワークフローで、その組み合わせに対応したバックエンドを使用する場合に限り、LFM3-Omni-2Bを選んでください。チャット、画像認識、音声の各パイプラインを1台のGPUで動かす場合は、家庭用GPUでマルチモーダル処理を行うガイドで説明しているように、同時稼働時のピークメモリを考慮する必要があります。
llama.cppを使ってLFM3-1.7Bをローカルで実行する方法
このセットアップの実行環境については、テキスト推論と実験段階のリアルタイム音声の違いも解説している、当社のllama.cpp 0.8.0のデプロイガイドをご覧ください。
再現性のある初回確認を行うには、公開されているGGUFリポジトリと、llama.cpp v0.8.0またはそれ以降のLFM3対応ビルドを使用してください。この例では、公式のQ4_K_Mバリアントを使用し、サーバーをループバックアドレスにバインドします。モデルAPIをインターネットに公開する設定ではありません。Git、CMake、互換性のあるコンパイラーがインストールされたLinuxホストで、次のコマンドを実行します:
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout v0.8.0
cmake -S . -B build
cmake --build build --config Release -j --target llama-server
./build/bin/llama-server \
  -hf LiquidAI/LFM3-1.7B-GGUF:Q4_K_M \
  -c 4096 --host 127.0.0.1 --port 8080
http://127.0.0.1:8080を同じマシン上で開くか、ターミナルからサーバーをテストしてください:
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"local","messages":[{"role":"user","content":"量子化について3文で説明してください。"}],"max_tokens":128}'
OpenAI互換APIで使用するモデル識別子は、サーバーの設定によって異なる場合があります。お使いのビルドで"local"が受け付けられない場合は、まず/v1/modelsに問い合わせて、返されたIDを使用してください。デフォルトのCPUバックエンドをビルドするのが無難な出発点です。GPUアクセラレーションを使うには、適切なバックエンドを選択してテストする必要があります。公式のGGUFカードには、OllamaやLM Studioなど、ほかの実行環境の選択肢も掲載されています。これらは別の実行環境として扱い、すべてのZimaOSパッケージにこの特定バージョンのモデルがすでに含まれている証拠とはみなさないでください。
後でビジョン機能をテストするには、ドキュメントに記載されているLFM3-VL GGUFチェックポイントを使用し、公式のビジョン向けクイックスタートに従って、対応するビジョンプロジェクターが読み込まれるようにしてください。適当なコマンドでテキストモデル名を置き換えただけで、画像入力が機能すると決めつけないでください。
デプロイの成功を判断する前に、何を確認すべきですか?
- モデルの識別情報: ダウンロードが完了したことだけでなく、選択したGGUFのバリアントと実行環境のバージョンを確認してください。
- リソース上限: アイドル時、プリフィル時、長めのプロンプト処理時の常駐RAM/VRAMを記録し、ZimaOSやその他のNASアプリに十分な余裕があることを確認してください。
- レイテンシと品質: プロンプト処理、1秒あたりの生成トークン数、指示への追従性、代表的な5つのタスクでの正確性を測定してください。
- プライバシーの境界: ローカルAPIはループバックまたは信頼できるプライベートネットワーク上に置いてください。他のクライアントからアクセスする必要がある場合は、認証とプロキシを適切に設定してください。
- 永続性: ダウンロードしたモデルファイルはブートパーティション以外に保存し、変更不可のウェイトと書き込み可能なアプリの状態を明確に分けてください。モデルファイルと実行時状態の分離およびローカルLLMの安全なデプロイガイドをご覧ください。
デスクトップでは動作するのにNASで失敗する場合は、量子化モデルのサイズ、正しいバインドマウント、使用可能なRAM、バックエンドの選択、CPU命令セットとの互換性、プロジェクター、コンテキスト長など、処理経路全体を診断してください。モデル保存先の確認チェックリストも参考になります。
よくある質問
LFM3は完全なオープンソースですか?
Liquid AIは、LFM Open License v1.0のもとでオープンウェイトを公開しています。ただし、だからといって、そのモデルやトレーニング用コンポーネントがオープンソースソフトウェアのあらゆる定義を満たすとは限りません。デプロイを再配布したり収益化したりする前に、ライセンスを確認してください。
CPUのみのPCやNASでLFM3を実行できますか?
小型のGGUFテキストモデルは、OSと使用可能なRAMが対応していれば、互換性のあるllama.cpp CPUバックエンドで実行できます。快適に操作できるかどうかは、CPUの性能、メモリ帯域幅、プロンプトの長さによって異なります。8 GBは公式の最小要件ではなく、実用的なテスト基準と考えてください。
LFM3-1.7Bは画像や音声の入力に対応していますか?
それだけでは十分ではありません。画像や動画にはLFM3-VL、音声にはLFM3-Audio、複数のモダリティを組み合わせる必要がある場合はLFM3-Omniを使用してください。それぞれチェックポイントと実行時の依存関係が異なります。
1 GBの4ビットモデルなら、RAMは1 GBだけで十分ですか?
いいえ。この数値は、量子化されたテキストモデルの重みのおおよその容量を示しています。推論プロセスでは、状態、ランタイムバッファー、トークンキャッシュ、オペレーティングシステムの使用分も加わります。長いコンテキストや複数ユーザーの利用では、その差が大きくなることがあります。
すべてのLFM3モデルで256Kのコンテキストを利用できますか?
いいえ。テキストモデルのコンテキスト長は256K、ビジョンモデルは128K、音声モデルは32Kを指定しています。ただし、対応する最大値であっても、特定の8 GBデバイスで快適に処理できる保証はありません。
ZimaCube 2またはZimaOSは、現在LFM3を実行できますか?
選んだハードウェア、モデル、ランタイムが適合すれば、ローカル推論スタックは技術的に実現可能です。ZimaCube 2は、プライベートなモデルストレージ、文書、アプリケーションサービスにも役立ちます。上記の確認内容は、ZimaOS上でのLFM3導入が独立した認証を受けたという主張でも、スループットを測定した結果でもありません。
まとめ
LFM3によって、小型で特化したオンデバイスAIがより実用的になりますが、話題の「2Bマルチモーダル」という表現より、どのチェックポイントを選ぶかのほうが重要です。ホームサーバーで最初に試すなら、コンテキストを短くし、ワークロードを制御した4ビットのLFM3-1.7Bテキストモデルが最も有望です。ビジョンや音声を追加するのは、該当するチェックポイントやランタイムのサポートを確認し、実測メモリが十分な場合に限ってください。
ZimaSpace環境では、ストレージ、推論、アプリケーションへのアクセスをそれぞれ別の判断事項として考えてください。より高性能なマシンでモデルを実行する場合でも、ホームNASはモデルファイルを保存し、個人文書を保護し、ローカルワークフローを調整できます。さらに大規模なオープンウェイトモデルに関心が広がった場合は、Kimi K3のローカル実行に関するハードウェア分析で、パラメーター規模によってメモリ要件の限界がいかに大きく変わるかを確認できます。
出典と対象範囲
2026年10月29日に確認した公式資料: Liquid AIローンチブログ、ファミリー概要、テキストモデルカード、ビジョンモデルカード、オーディオモデルカード、およびllama.cpp v0.8.0リリース。性能に関する主張は開発者によるものです。ここでのハードウェア要件と運用上の推奨事項は編集上の推定であり、ZimaSpaceでのベンチマーク結果ではありません。
カバー画像: Liquid AI、LFM3公式ローンチ動画のサムネイル。

おすすめの商品

テクノロジー&AIハブ
続きを読む
llama.cpp 0.8.0:新モデル、リアルタイム音声、ローカルAI機能
llama.cpp 0.8.0では、LFM3などのモデルアーキテクチャ、実験的なリアルタイム音声API、TTSサポート、サーバーとメモリの改善が追加されました。このガイドでは、確認済みのリリース内容と導入時の制約を分けて説明し、再現可能なローカル検証手順を紹介します。
クラウドAI APIの料金とローカルAI:ワークロードの実際のコストは?
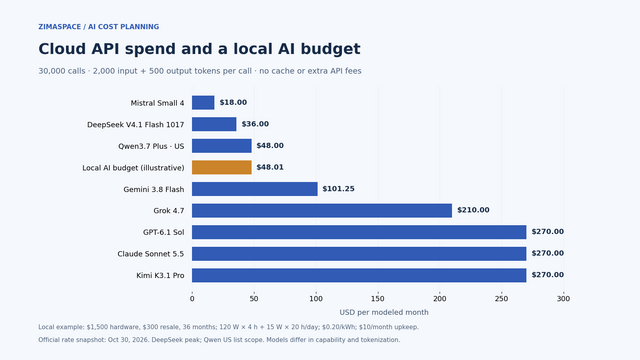
クラウドAPIのトークン料金と、ローカルAIハードウェアの電気代・維持費を比較しましょう。月ごとの例を試算し、無料のZimaSpaceコスト計算ツールをご利用ください。

シークレットゼロ問題:ホームAIエージェントに初期の信頼の起点が依然として必要な理由
secret-zero問題、その共有リソースに関するトレードオフ、クエリのファンアウトに関する3つのよくある質問、実践的な検証プロトコルを、仕組みを第一に解説します。


