
Kimi K3.1 Pro uitgelegd: codeeragents, lange context en privébestandsworkflows


Omslagafbeelding: Moonshot AI — lanceringsafbeelding van Kimi K3.1 Pro.
Kimi K3.1 Pro breidt de K3-familie uit met een nieuwe release voor programmeren en langlopende agenttaken. De relevante vraag voor een thuisserver is hoe je een krachtig gehost model gecontroleerde toegang tot een project geeft, zonder van een privéarchief een onbeperkte toolomgeving te maken.
Deze gids maakt onderscheid tussen de gepubliceerde aankondiging en de praktische implementatie. De gids legt uit wat de bron bevestigt, waar het bewijs ophoudt en hoe je een workflow met privébestanden kunt beoordelen zonder aan te nemen dat een indrukwekkend model of een nieuwere server de noodzaak van afgebakende toegang en controle wegneemt.
| Beslissing | Geverifieerd feit of praktische beperking |
|---|---|
| Grens van de release | Kimi Code vermeldt K3.1 Pro en Highspeed vanaf 23 oktober 2026. |
| Context | De aangekondigde maximale contextomvang is één miljoen tokens; toegang is afhankelijk van het product en het abonnement. |
| Grens van de dienstverlening | Een API of programmeerclient gebruiken is iets anders dan de volledige gewichten lokaal laden. |
| Rol van de thuisserver | Privébrongegevens, ophalen, projectkopieën en herstelbare uitvoer. |

Wat is er veranderd van Kimi K3 naar K3.1 Pro?
De officiële release-opmerkingen van Kimi Code beschrijven verbeteringen op het gebied van programmeren, 3D-creatie, financieel onderzoek en langere agenttaken. Ook introduceren ze Highspeed, dat wordt omschreven als ongeveer twee tot drie keer sneller, met dezelfde modelkwaliteit. Dit zijn productclaims van de aanbieder, geen tijdmetingen op een NAS thuis. Beoordeel snelheid, toegangsrechten en taakprestaties afzonderlijk in de specifieke client en het abonnement dat je gebruikt.
De gedocumenteerde upgrade verandert ook de gebruiksinstellingen: redeneren blijft ingeschakeld, bij de overstap vanuit sessies met oudere modellen wordt een nieuwe sessie aanbevolen en native API-protocollen krijgen de voorkeur boven conversie via proxytools. Een workflow kan daardoor anders werken, ook als de prompttekst ongewijzigd blijft. Noteer de model-ID, redeneerinstelling, clientversie en toolconfiguratie bij je testresultaten. Als je modelnamen vergelijkt terwijl je alle vier tegelijk wijzigt, is het resultaat niet eenduidig.
Maakt één miljoen tokens ophalen overbodig?
Een groot contextvenster vergroot de hoeveelheid materiaal die een verzoek kan bevatten. Het betekent niet dat elk bestand relevant, actueel, geautoriseerd of goedkoop te verwerken is. Een project kan dubbele afhankelijkheden, gegenereerde bestanden en verouderde documentatie bevatten. Alles versturen kan het beschikbare budget opsouperen en het tegelijk moeilijker maken om de belangrijke uitzondering te vinden. Begin met een manifest en een expliciete taakafbakening en haal daarna de bestanden op die nodig zijn om die taak uit te voeren.
Een codeeragent die bijvoorbeeld een importfout oplost, heeft de betreffende module, afhankelijkheidsdefinities, de mislukte test en de relevante configuratie nodig. Niet-gerelateerde familiedocumenten op dezelfde NAS heeft die meestal niet nodig. Een lange context kan helpen om samenhangend bewijs bij een grotere wijziging te behouden, maar dataminimalisatie blijft nuttig voor de kosten, beoordeling en vertrouwelijkheid. Wanneer je een verouderd bestand uit de werkruimte verwijdert, moet je ook elke index of elk gecachet fragment ongeldig maken waarin het ongemerkt opnieuw kan opduiken.
Kan een NAS thuis het volledige model lokaal uitvoeren?
Leid de haalbaarheid van lokale implementatie niet af uit het aantal actieve parameters, een client die op je computer draait of een aangekondigd plan voor open gewichten. De eerdere implementatiegids voor K3 maakt al onderscheid tussen de totale opslagruimte voor gewichten en de actieve rekenkracht en overhead voor het uitvoeren van het model. Voor een nieuwe Pro-release moeten het checkpoint, de licentie, de runtime en de hardware afzonderlijk worden geverifieerd. Op de afsluitdatum van deze berichtgeving moet de aangekondigde planning voor de publicatie van gewichten als een plan worden beschouwd, niet als bewijs dat er al een bruikbaar lokaal checkpoint is uitgebracht.
Een hybride opstelling is voor de meeste huishoudens een realistischer uitgangspunt: de NAS slaat de gezaghebbende projectbestanden en een zoekindex op, terwijl een gehost endpoint de geavanceerde inferentie uitvoert. De connector exporteert alleen goedgekeurd materiaal naar een afgebakende werkmap. Gegenereerde code komt terug als een diff om te testen en te beoordelen. Deze architectuur maakt gehoste inferentie niet standaard privé; controleer precies welke fragmenten, logboeken, afbeeldingen en toolresultaten het netwerk verlaten.
Wat moet je meten voordat je deze workflow vertrouwt?
Stel een codeerevaluatie samen rond een repository die je kent. Kies een kleine bug met een falende test, een functie die twee modules raakt en een documentatievraag waarvan het antwoord afhangt van een recente wijziging. Leg de repositoryrevisie en het lockbestand met afhankelijkheden vast. Voer elke taak uit in een schone branch, met dezelfde instructies en toolmachtigingen. Vergelijk geaccepteerde patches, niet-gerelateerde wijzigingen, daadwerkelijk uitgevoerde tests en de beoordelingstijd. Het aantal gegenereerde regels is geen bruikbare maatstaf voor een correcte wijziging.
Test lang contextgebruik los van informatie ophalen. Geef eerst een compacte set relevante bestanden en voeg daarna realistische afleiders toe, zoals verouderde documentatie en gegenereerde code. Vraag het model aan te geven op welke bronrevisie het antwoord is gebaseerd. Als de nauwkeurigheid afneemt naarmate de invoer groeit, onderzoek dan eerst de selectie en volgorde voordat je meer contextcapaciteit aanschaft. Houd voor vergelijkingen met Highspeed dezelfde modelinstellingen, taak en acceptatiecriteria aan. Snelheidsclaims van leveranciers zeggen niets over de latentie of kwaliteit van jouw specifieke repository-workflow.
Hoe houd je het resultaat controleerbaar en herstelbaar?
Gebruik versiebeheer als scheidslijn tussen een voorgestelde patch en een geaccepteerde projectstatus. Een codesessie moet een diff opleveren die je kunt beoordelen, en niet stilzwijgend de gezaghebbende repository op een gedeeld volume vervangen. Bewaar de oorspronkelijke taak, commit-ID, relevante configuratie en testuitvoer bij de patch. Controleer wijzigingen in afhankelijkheden, gegenereerde scripts en nieuwe netwerkoproepen expliciet. Dat een beperkte unittestsuite slaagt, bewijst niet dat een agent zich aan alle projectbeperkingen heeft gehouden.
Herstel moet zowel de repository als de werkruimte van de agent omvatten. Met een schone checkout kun je bijgehouden bestanden herstellen, maar niet per se genegeerde assets, lokale databases of een verwijderd werkdocument. Houd die invoer buiten het schrijfbereik van de agent of maak een aparte back-up. Voordat je een uitgebreidere taak toestaat, onderbreek je een wegwerptest en controleer je of je gedeeltelijke wijzigingen kunt herkennen, ongedaan kunt maken en opnieuw kunt beginnen vanaf de oorspronkelijke revisie, zonder de volgende sessie in verwarring te brengen.
Hoe kun je de workflow testen voordat je belangrijke bestanden gebruikt?
Het volgende is een redactioneel validatieprotocol, geen bewering dat ZimaSpace de service heeft gebenchmarkt. Voer het uit met wegwerpbare of goedgekeurde testgegevens en leg de testomstandigheden bij het resultaat vast.
- Leg de taak en de revisie van de repository vast. Noteer het verwachte gedrag en de bestanden die gewijzigd mogen worden voordat je een codesessie start; vermeld ook de opdracht waarmee de oorspronkelijke fout kan worden aangetoond.
- Maak een beperkte werkkopie. Sluit inloggegevens, privéarchieven en niet-gerelateerde repositories uit. Controleer wat de programmeerclient naar het gehoste model stuurt en wat de tools ervan kunnen uitvoeren.
- Noteer het exacte model en de denkconfiguratie. Start een nieuwe sessie voor het nieuwe model, zoals de release notes aanbevelen, en noteer welke client en welk protocol je hebt gebruikt.
- Voer varianten uit met een compacte en een uitgebreide context. Laat de acceptatietest ongewijzigd, voeg realistisch maar irrelevant materiaal toe en controleer of het model nog steeds naar de juiste bronversie verwijst.
- Controleer de voorgestelde diff en voer de tests zelf uit. Maak onderscheid tussen de bewering van een model dat een test is geslaagd en een bewaard testlogboek dat door de geconfigureerde omgeving is gegenereerd.
- Test het terugdraaien op een tijdelijke branch. Zet de repository en eventuele niet-getrackte invoer terug en herhaal de taak voordat je de agent meer bevoegdheden binnen het project geeft.
Waar past een ZimaOS-server?
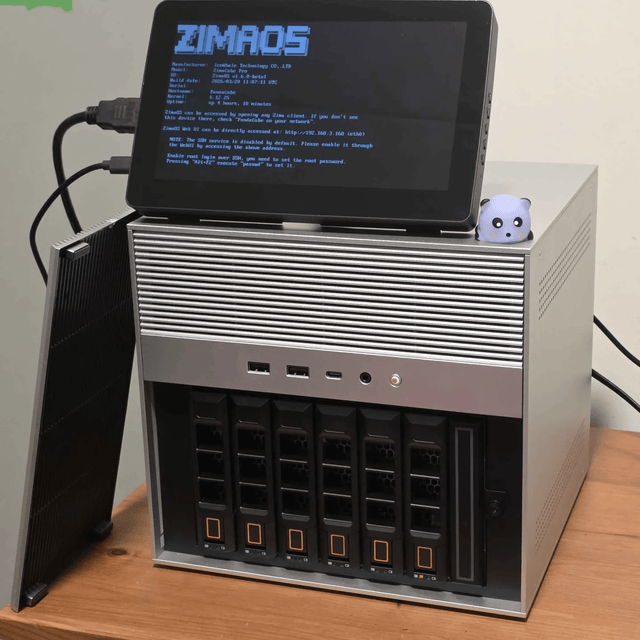
Een ZimaCube 2 persoonlijke cloud-NAS kan een lokale opslag- en applicatielaag bieden wanneer een project echt meerdere schijven, een SSD-werklaag of gedeelde toegang tot een groeiend archief nodig heeft. Kies hardware op basis van de brongegevens die je bewaart, de actieve services en het back-upbeleid. De productaanbeveling biedt architecturale context, maar vormt geen bewijs dat dit cloudmodel, deze previewservice of dit onderzoekssysteem lokaal op de NAS draait.
Houd gevolgtrekkingen en gegevensbeheer uit elkaar. Een gehost model kan goedgekeurde fragmenten ontvangen, terwijl de gezaghebbende originelen op de server blijven staan. Voor optionele lokale indexering, conversie of services met kleinere modellen moet je afzonderlijk nagaan hoeveel geheugen en rekenkracht daarvoor nodig zijn. Bewaar een tweede herstelbare kopie op een ander apparaat en beschouw RAID of een geslaagde upload niet als een volwaardige back-upstrategie. Een kleinere bestaande server blijft een geschikte keuze als die al voldoet aan de gemeten werklast.
Veelgestelde vragen
Is K3.1 Pro hetzelfde als een downloadbaar lokaal checkpoint?
Nee. Toegang tot Kimi Code en het aangekondigde plan om gewichten vrij te geven zijn twee verschillende dingen. Controleer of er daadwerkelijk een checkpoint beschikbaar is, en ga na welke licentie, runtime en hardwarevereisten gelden voordat je deze release omschrijft als lokaal inzetbaar.
Moet ik altijd het contextvenster van één miljoen tokens volledig benutten?
Nee. Begin met de bestanden die relevant zijn voor de taak en vergelijk de resultaten met die van een uitvoering met een grotere context. Meer invoer kan de kosten verhogen en verouderd of irrelevant bewijs toevoegen; de contextlimiet is geen streefwaarde.
Hoe beoordeel ik de Highspeed-optie?
Houd de repositoryversie, taak, modelinstellingen en acceptatiecontroles ongewijzigd. Meet de tijd tot een geaccepteerde patch en de benodigde controle-inspanning, naast de reactietijd. De snelheidsclaim van de leverancier is geen benchmark van je NAS of codeerproject.
Moet ik het hele privéarchief toegankelijk maken voor een AI-tool?
Geef voor de taak alleen het benodigde materiaal toegang via een account of werkmap met passende toegangsbeperkingen. Controleer wat de specifieke dienst uploadt, logt en bewaart. Een privéopslaglocatie garandeert niet dat een gekoppelde tool de verwerking lokaal houdt.
Wanneer is een grotere NAS nuttig?
Pas wanneer de gemeten groei van brongegevens, gedeelde toegang, actieve toepassingen of bewaartermijnen de opslagtopologie rechtvaardigen. Dit lost niet automatisch problemen op met modeltoegang, niet-ondersteunde runtimes, limieten voor netwerkuploads of onzekerheid over een onderzoeksclaim.
Wanneer moet je stoppen voordat je het in productie gebruikt?
Stop als je de identiteit van de software of het model, de bevoegdheid over de invoer, de beschikbaarheid van de vereiste functies of de herstelprocedure niet kunt vaststellen. Los die punten eerst op en herhaal daarna de kleine test. Compenseer ontbrekend bewijs niet met een stelliger advies.
Bronnen en meer informatie
Controle van de rapportage uitgevoerd op 28 oktober 2026. Beschikbaarheid van producten, toegangsplannen en beveiligingsadviezen kunnen veranderen. Claims van upstream-bronnen worden aan de bron toegeschreven; aanbevelingen voor workflows en architectuurvoorbeelden zijn redactionele analyses en geen metingen van een ZimaSpace-hardwaretest.
Gerelateerde gids: Kimi K3 lokaal uitvoeren: hardware, geheugen en implementatiebeperkingen.
Gerelateerde gids: Je NAS-bestanden voorbereiden op AI-agentworkflows zonder alles te delen.
Gerelateerde gids: Herstelbare kopieën bewaren van bestanden die door je AI-agent worden gebruikt.

Aanbevolen producten

Technologie- en AI-hub
Meer om te lezen
Versiepinning van embeddings: waarom query- en documentvectoren compatibel moeten blijven
Een uitleg die begint bij de werking van versiepinning voor embeddings, de afwegingen rond gedeelde resources, drie veelgestelde vragen over query-fan-out en een praktisch...
Contentgeadresseerde modelopslag: hoe hashes dubbele downloads van gewichten voorkomen
Een uitleg van content-addressed modelopslag die begint bij de werking, de afwegingen rond gedeelde resources, drie veelgestelde vragen over queryfan-out en een praktisch verificatieprotocol.
Acties voor agentcompensatie: hoe omkeerbare stappen gedeeltelijke workflowfouten beperken
Een uitleg van agentcompensatieacties vanuit de werking, de afwegingen rond gedeelde resources, drie veelgestelde vragen over query-fan-out en een praktisch verificatieprotocol.


