
Le 10 migliori interfacce web per l’IA locale per home lab nel 2026


Una buona interfaccia web per l’AI locale trasforma un server di modelli a riga di comando in un servizio privato che tutti in casa possono usare davvero. Le opzioni migliori consentono anche di conservare la cronologia delle chat, gestire i modelli e aggiungere documenti o strumenti senza costringere ogni utente a capire l’infrastruttura sottostante.
Open WebUI è la scelta complessiva migliore per la maggior parte degli home lab, ma non è automaticamente l’interfaccia migliore per ogni esigenza. LibreChat offre funzionalità più avanzate per agent e strumenti MCP, AnythingLLM dà priorità alla RAG basata sui documenti, text-generation-webui offre controlli più approfonditi sull’inferenza e Dify o Flowise sono più adatti quando l’obiettivo è creare applicazioni anziché semplicemente chattare. Il confronto qui sotto parte dall’utilizzo pratico, così puoi scegliere l’interfaccia più essenziale che soddisfa le tue reali esigenze.
Confronto tra interfacce web per l’AI locale
| Posizione | Interfaccia web | Ideale per | Connessione ai modelli locali | Multiutente | Livello di configurazione |
|---|---|---|---|---|---|
| 1 | Open WebUI | La migliore interfaccia complessiva per home lab | Ollama e API compatibili con OpenAI | Sì | Da facile a moderato |
| 2 | LibreChat | Agent, MCP e utenti esperti | Ollama e diversi endpoint API | Sì | Moderato |
| 3 | LobeHub | Ambiente di lavoro AI personale curato | Ollama e ampia compatibilità con i provider | Con distribuzione su server | Moderato |
| 4 | AnythingLLM | Documenti privati e RAG pronto all’uso | Provider LLM locali e cloud | Sì, nell’edizione Docker | Da facile a moderato |
| 5 | text-generation-webui | Controllo del caricamento e dell’inferenza dei modelli | Backend di inferenza integrati | Limitato | Da moderato ad avanzato |
| 6 | Big-AGI | Confronto tra più modelli e ricerca | Ollama, LM Studio, LocalAI, API | Nessun account nativo nell’edizione Open | Moderato |
| 7 | NextChat | Chat leggera e reattiva | Endpoint compatibili con OpenAI e LocalAI | Codice di accesso di base | Facile |
| 8 | SillyTavern | Roleplay, personaggi e controllo dei prompt | Ampia scelta di API per modelli locali | Principalmente per uso personale | Moderato |
| 9 | Dify | Creazione e pubblicazione di app AI | Modelli locali tramite provider/plugin | Sì | Avanzato |
| 10 | Flowise | Agent visivi e flussi di lavoro LLM | Ollama e altri nodi modello | Controlli di accesso disponibili | Avanzato |
Il livello di configurazione riguarda l’interfaccia e i servizi di supporto, non l’inferenza del modello. L’esecuzione di un modello locale di grandi dimensioni può richiedere molta più RAM o capacità GPU rispetto alla sola interfaccia web.
Come abbiamo classificato queste interfacce AI locali
Abbiamo dato priorità all’utilità per gli home lab rispetto al numero di funzionalità. Abbiamo valutato ogni interfaccia in base alla compatibilità con i modelli locali, al supporto per Docker o per il self-hosting, alla facilità d’uso da altri dispositivi sulla LAN, alle funzionalità RAG e agent, alla gestione degli utenti, all’impegno richiesto per la manutenzione e alla chiarezza della documentazione di distribuzione del progetto.
La privacy dipende anche dalla configurazione. Anche un’interfaccia self-hosted può inviare prompt ad API cloud, servizi di ricerca, endpoint di telemetria o strumenti esterni, se li abiliti. Per uno stack davvero locale, mantieni endpoint del modello, embedding, database vettoriale, servizi vocali e archiviazione all’interno della tua rete. La guida di ZimaSpace agli LLM locali privati spiega l’intero percorso dei dati.
1. Open WebUI — La migliore interfaccia web complessiva per l’IA locale
Open WebUI è la scelta predefinita più sicura per un home lab, perché unisce un’esperienza di chat intuitiva a funzionalità sufficientemente avanzate da restare utile anche quando la configurazione si amplia. Si collega direttamente a Ollama e alle API compatibili con OpenAI, può funzionare offline e supporta più modelli senza vincolare l’interfaccia a un unico motore di inferenza.
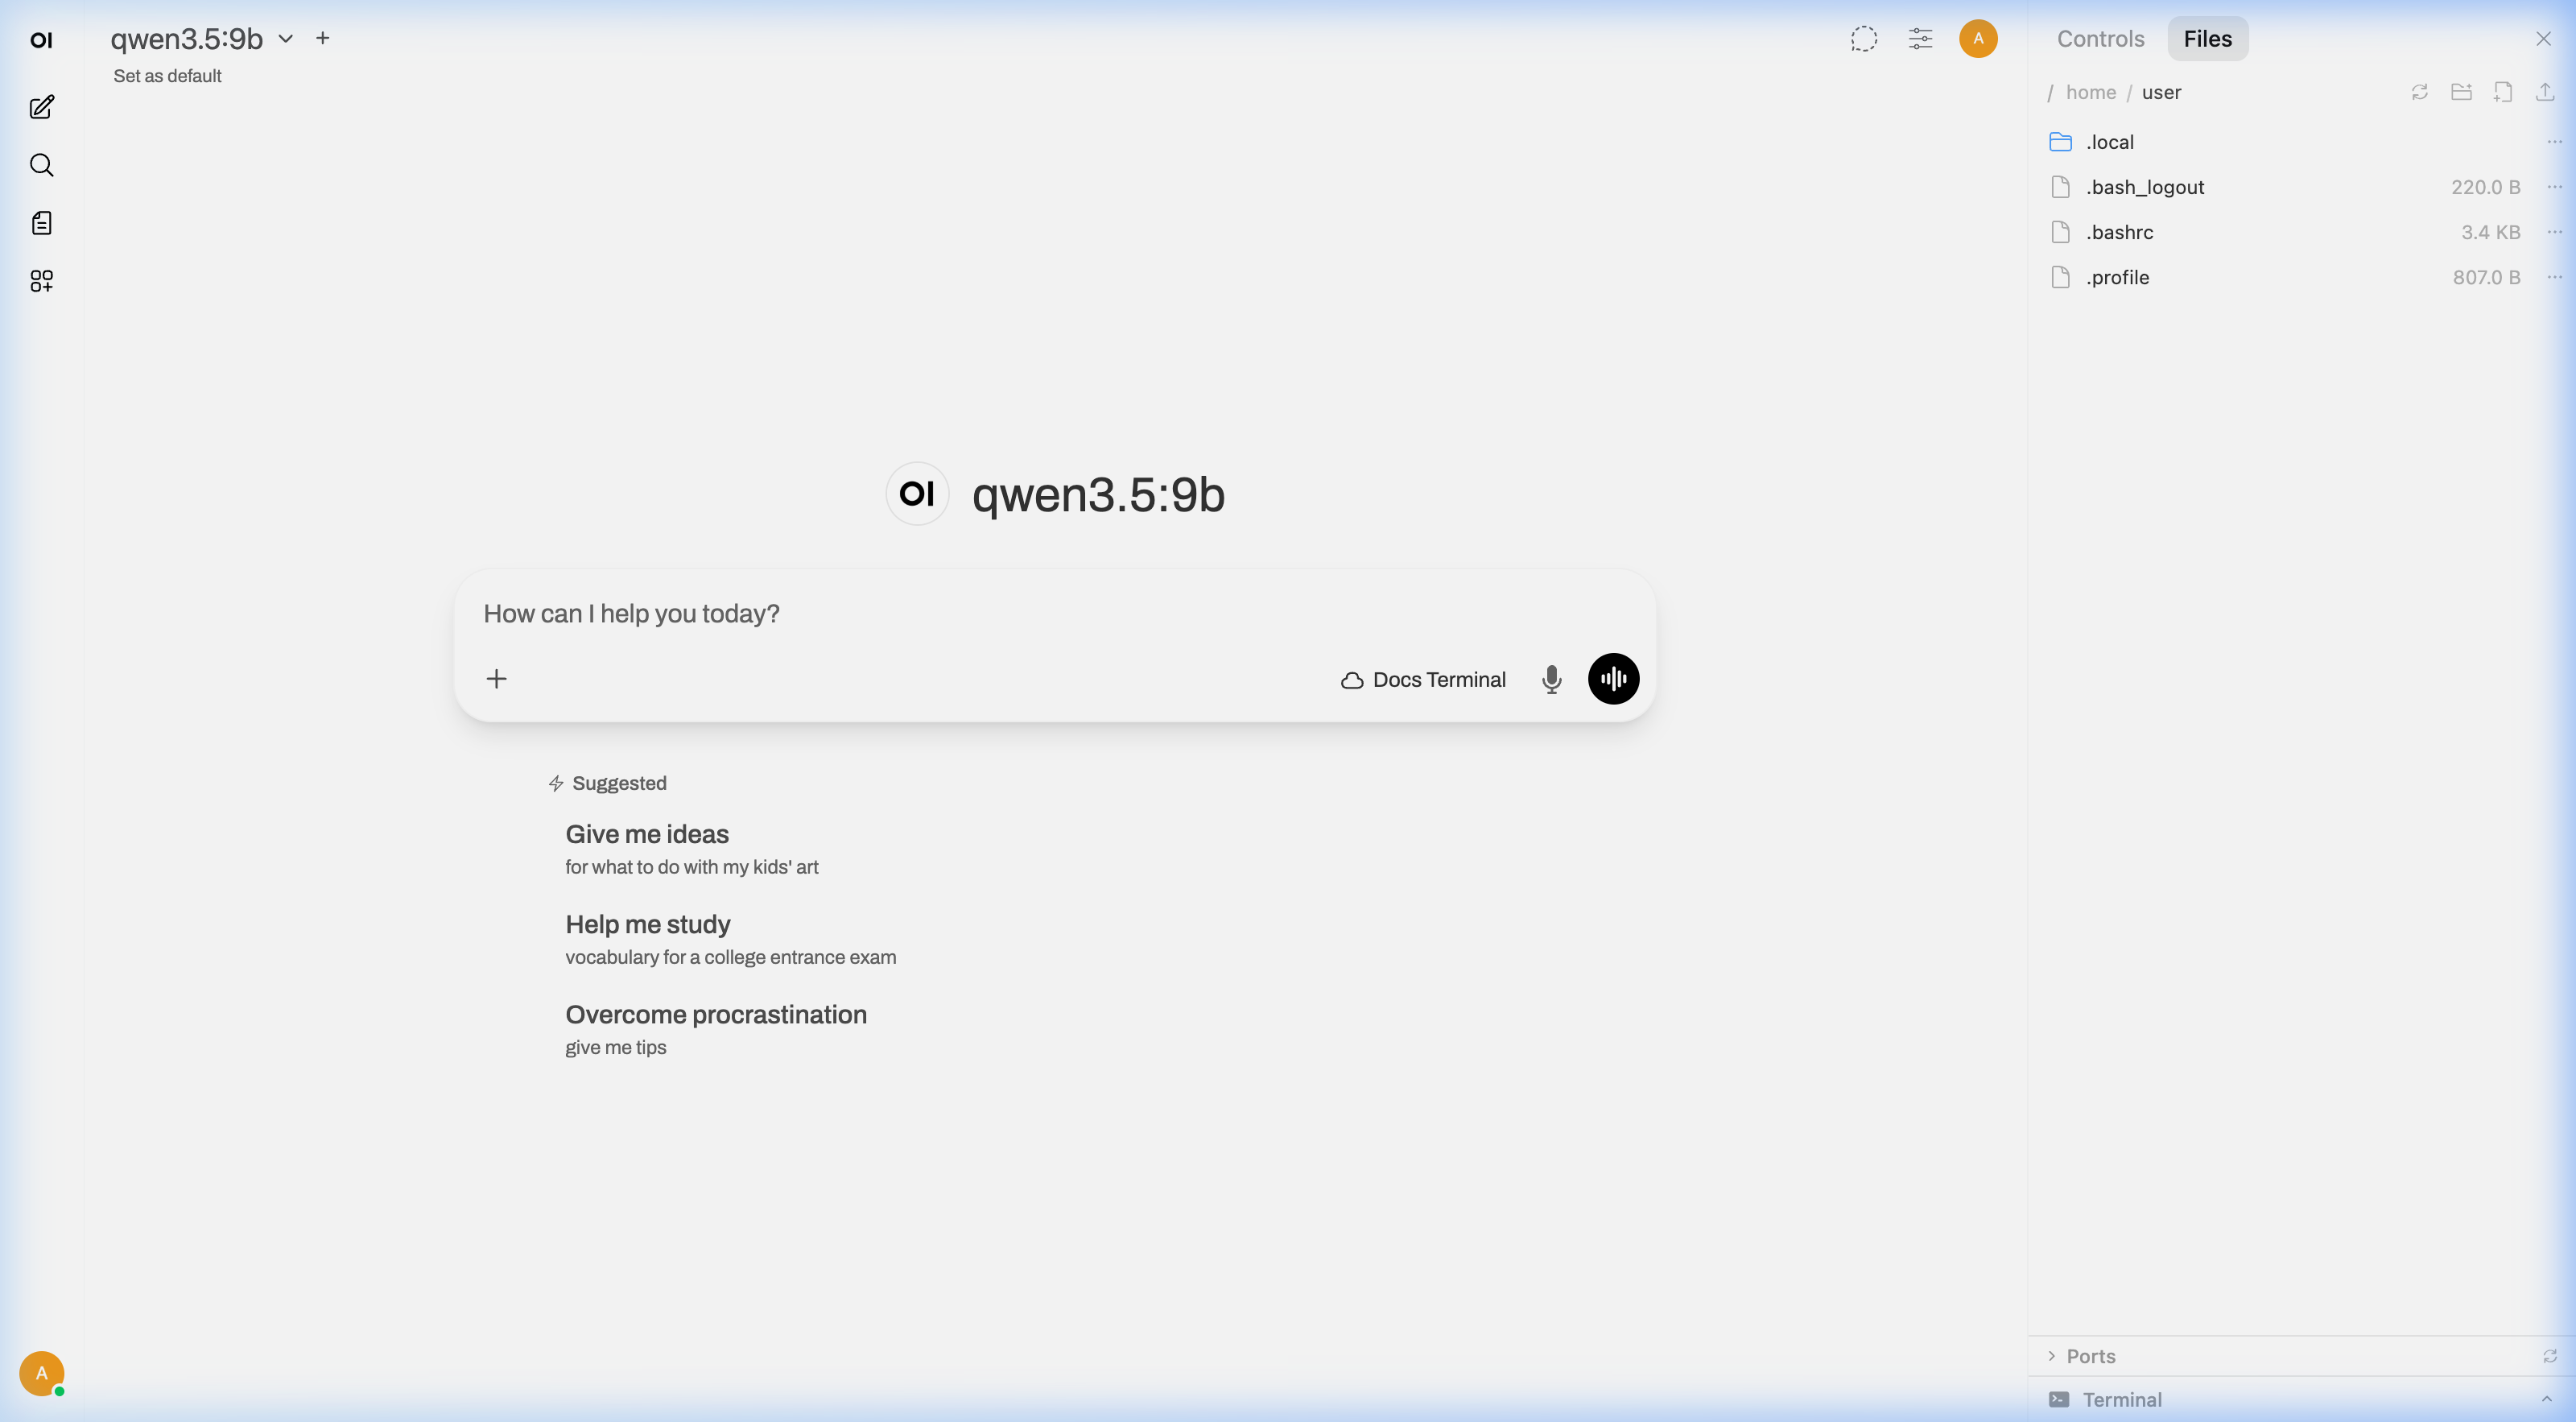
Le funzionalità includono allegati di file e immagini, RAG, ricerca sul Web, esecuzione del codice, strumenti, memoria, chat con più modelli e gestione degli utenti. Lo svantaggio principale è la complessità: ogni funzionalità attivata aggiunge servizi, autorizzazioni e possibili percorsi di rete da gestire.
- Ideale per: famiglie, appassionati e server domestici multiutente.
- Sceglilo quando: vuoi un’interfaccia in stile ChatGPT, pronta all’uso e ampliabile in seguito.
- Da tenere presente: la configurazione della rete Docker tra Open WebUI e un servizio Ollama su un altro host.
2. LibreChat — Il migliore per agenti e strumenti MCP
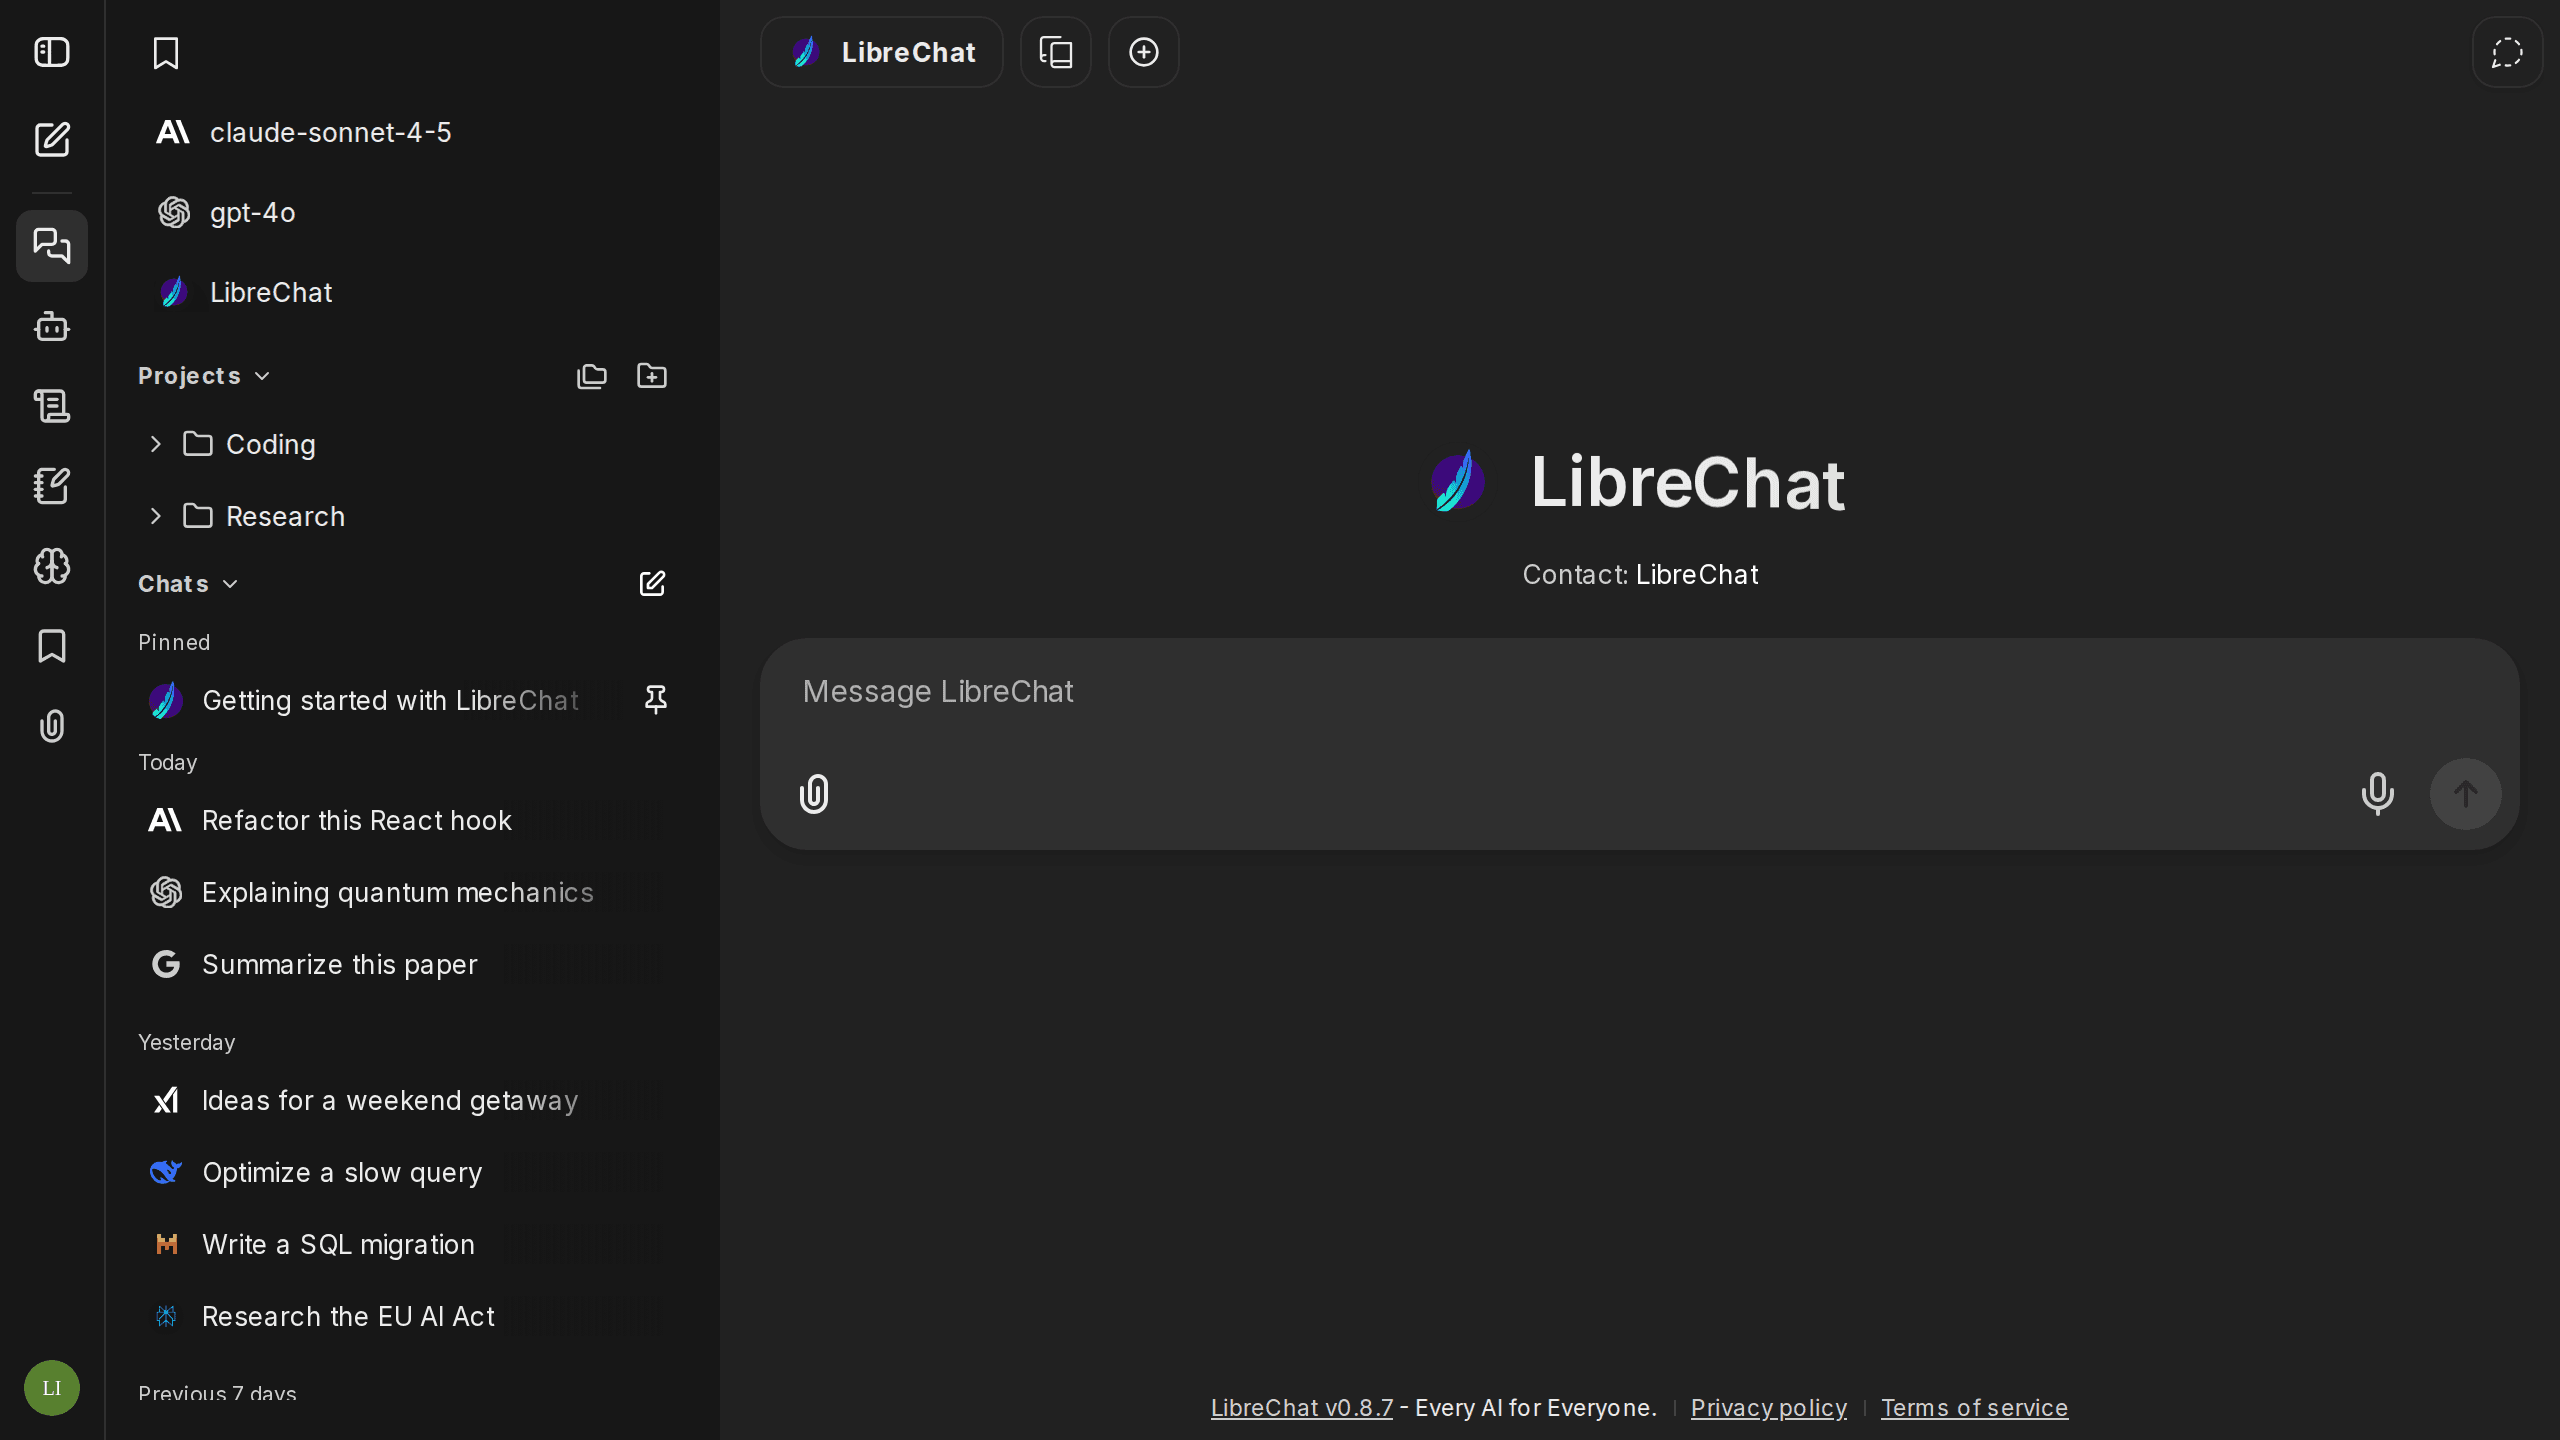
LibreChat è un’ottima scelta per chi desidera usare modelli locali e cloud in un’unica interfaccia di assistente completa. Le funzionalità attuali includono agenti, RAG, chat multimodale, esecuzione del codice, artefatti, ricerca sul Web, memoria persistente e ampie opzioni di autenticazione.
La funzionalità più interessante è l’integrazione del Model Context Protocol. I server MCP possono essere resi disponibili direttamente nella chat o associati ad agenti specifici, una soluzione utile per collegare un assistente privato a file, database, automazioni o servizi interni dell’home lab.
- Ideale per: chi crea agenti, sviluppatori e installazioni avanzate multiutente.
- Sceglilo quando: gli strumenti e la flessibilità nella scelta dei provider sono più importanti della configurazione più semplice.
- Da tenere presente: offre più opzioni di configurazione rispetto alle interfacce di chat essenziali.
3. LobeHub — Il miglior spazio di lavoro personale per l’IA, curato nei dettagli
LobeHub, precedentemente noto come LobeChat, si distingue per l’interfaccia curata e il supporto a un’ampia gamma di provider di modelli. La sua integrazione con Ollama permette di utilizzare modelli ospitati in locale nello stesso moderno spazio di lavoro dedicato agli agenti e ai modelli dei provider.
Supporta anche il caricamento di file e i flussi di lavoro basati su knowledge base, ma la distribuzione completa del server richiede più infrastruttura di supporto rispetto a un frontend accessibile solo tramite browser. Sceglilo quando la presentazione, l’organizzazione degli agenti e uno spazio di lavoro personale completo contano più del numero minimo di container.
- Ideale per: utenti che apprezzano la qualità dell’interfaccia e gli assistenti AI ben organizzati.
- Sceglilo quando: vuoi accedere a Ollama in locale senza rinunciare a uno spazio di lavoro curato.
- Da considerare: le differenze tra le distribuzioni client semplici e le funzionalità complete basate su database.
4. AnythingLLM — La scelta migliore per documenti privati e RAG
AnythingLLM si concentra sulla trasformazione di file privati in spazi di lavoro AI utili. Riunisce in un’unica applicazione l’acquisizione di documenti, gli embedding, l’archiviazione vettoriale, la chat e gli agenti, riducendo il numero di componenti che un principiante deve assemblare autonomamente.
L’edizione Docker supporta l’accesso tramite browser, più utenti, autorizzazioni per gli spazi di lavoro e connessioni a LLM locali. È una scelta iniziale migliore rispetto a un’interfaccia di chat generica quando l’esigenza principale è fare domande su manuali, appunti, ricerche o archivi domestici.
- Ideale per: domande e risposte sui documenti e RAG locale chiavi in mano.
- Sceglilo quando: i file sono al centro del flusso di lavoro.
- Da considerare: le scelte di embedding e di database vettoriale, che influiscono sulla qualità del recupero indipendentemente dal modello di chat.
5. text-generation-webui — La scelta migliore per il controllo dei modelli e dell’inferenza
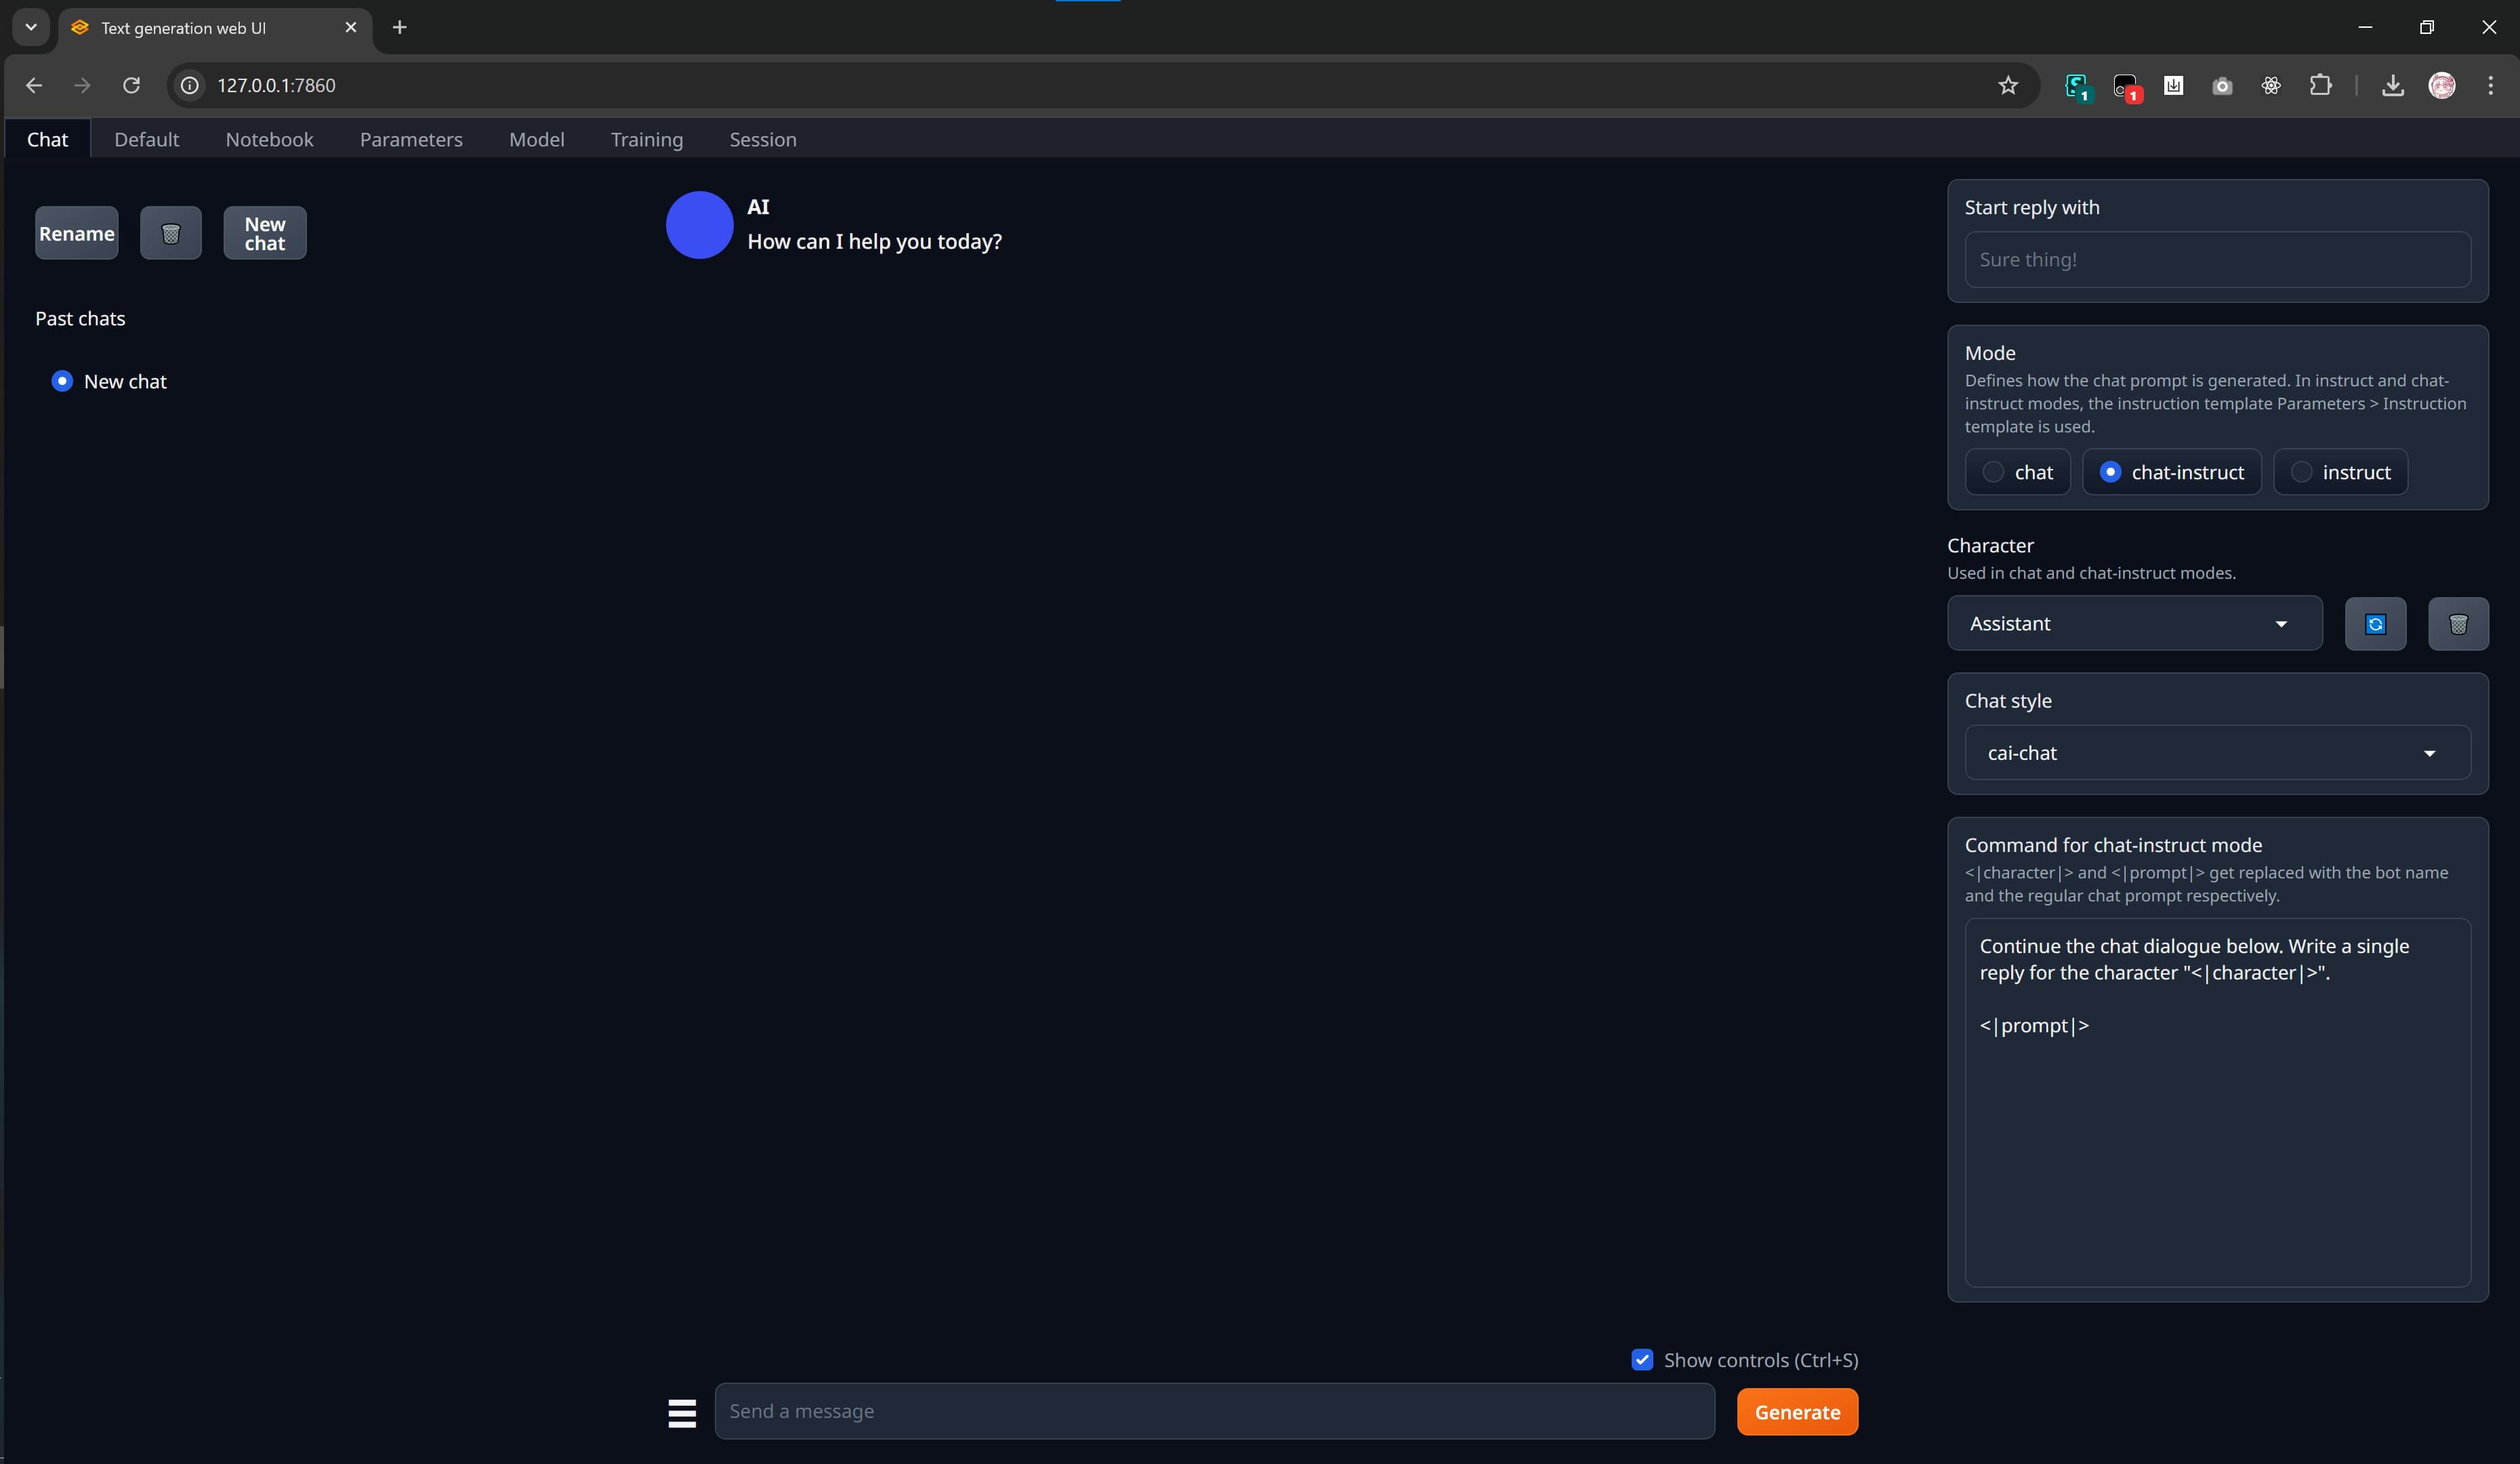
text-generation-webui è sia un’interfaccia browser sia un ambiente flessibile per l’inferenza locale. Supporta diversi backend, tra cui llama.cpp, Transformers, ExLlama e TensorRT-LLM, offrendo al contempo il caricamento dei modelli, il campionamento, i template per i prompt, le estensioni e un’API compatibile con OpenAI e Anthropic.
Questo lo rende utile per testare le quantizzazioni o regolare il comportamento di generazione prima di aggiungere un altro frontend. È meno adatto a un portale domestico, perché l’amministrazione multiutente e la gestione della conoscenza chiavi in mano non sono i suoi punti di forza.
- Ideale per: appassionati che confrontano loader, formati e impostazioni di generazione.
- Sceglilo quando: il controllo sull'inferenza conta più di un'esperienza multiutente curata.
- Attenzione a: esporre un'interfaccia potente per la gestione dei modelli al di fuori della LAN fidata.
6. Big-AGI — Ideale per confrontare più modelli
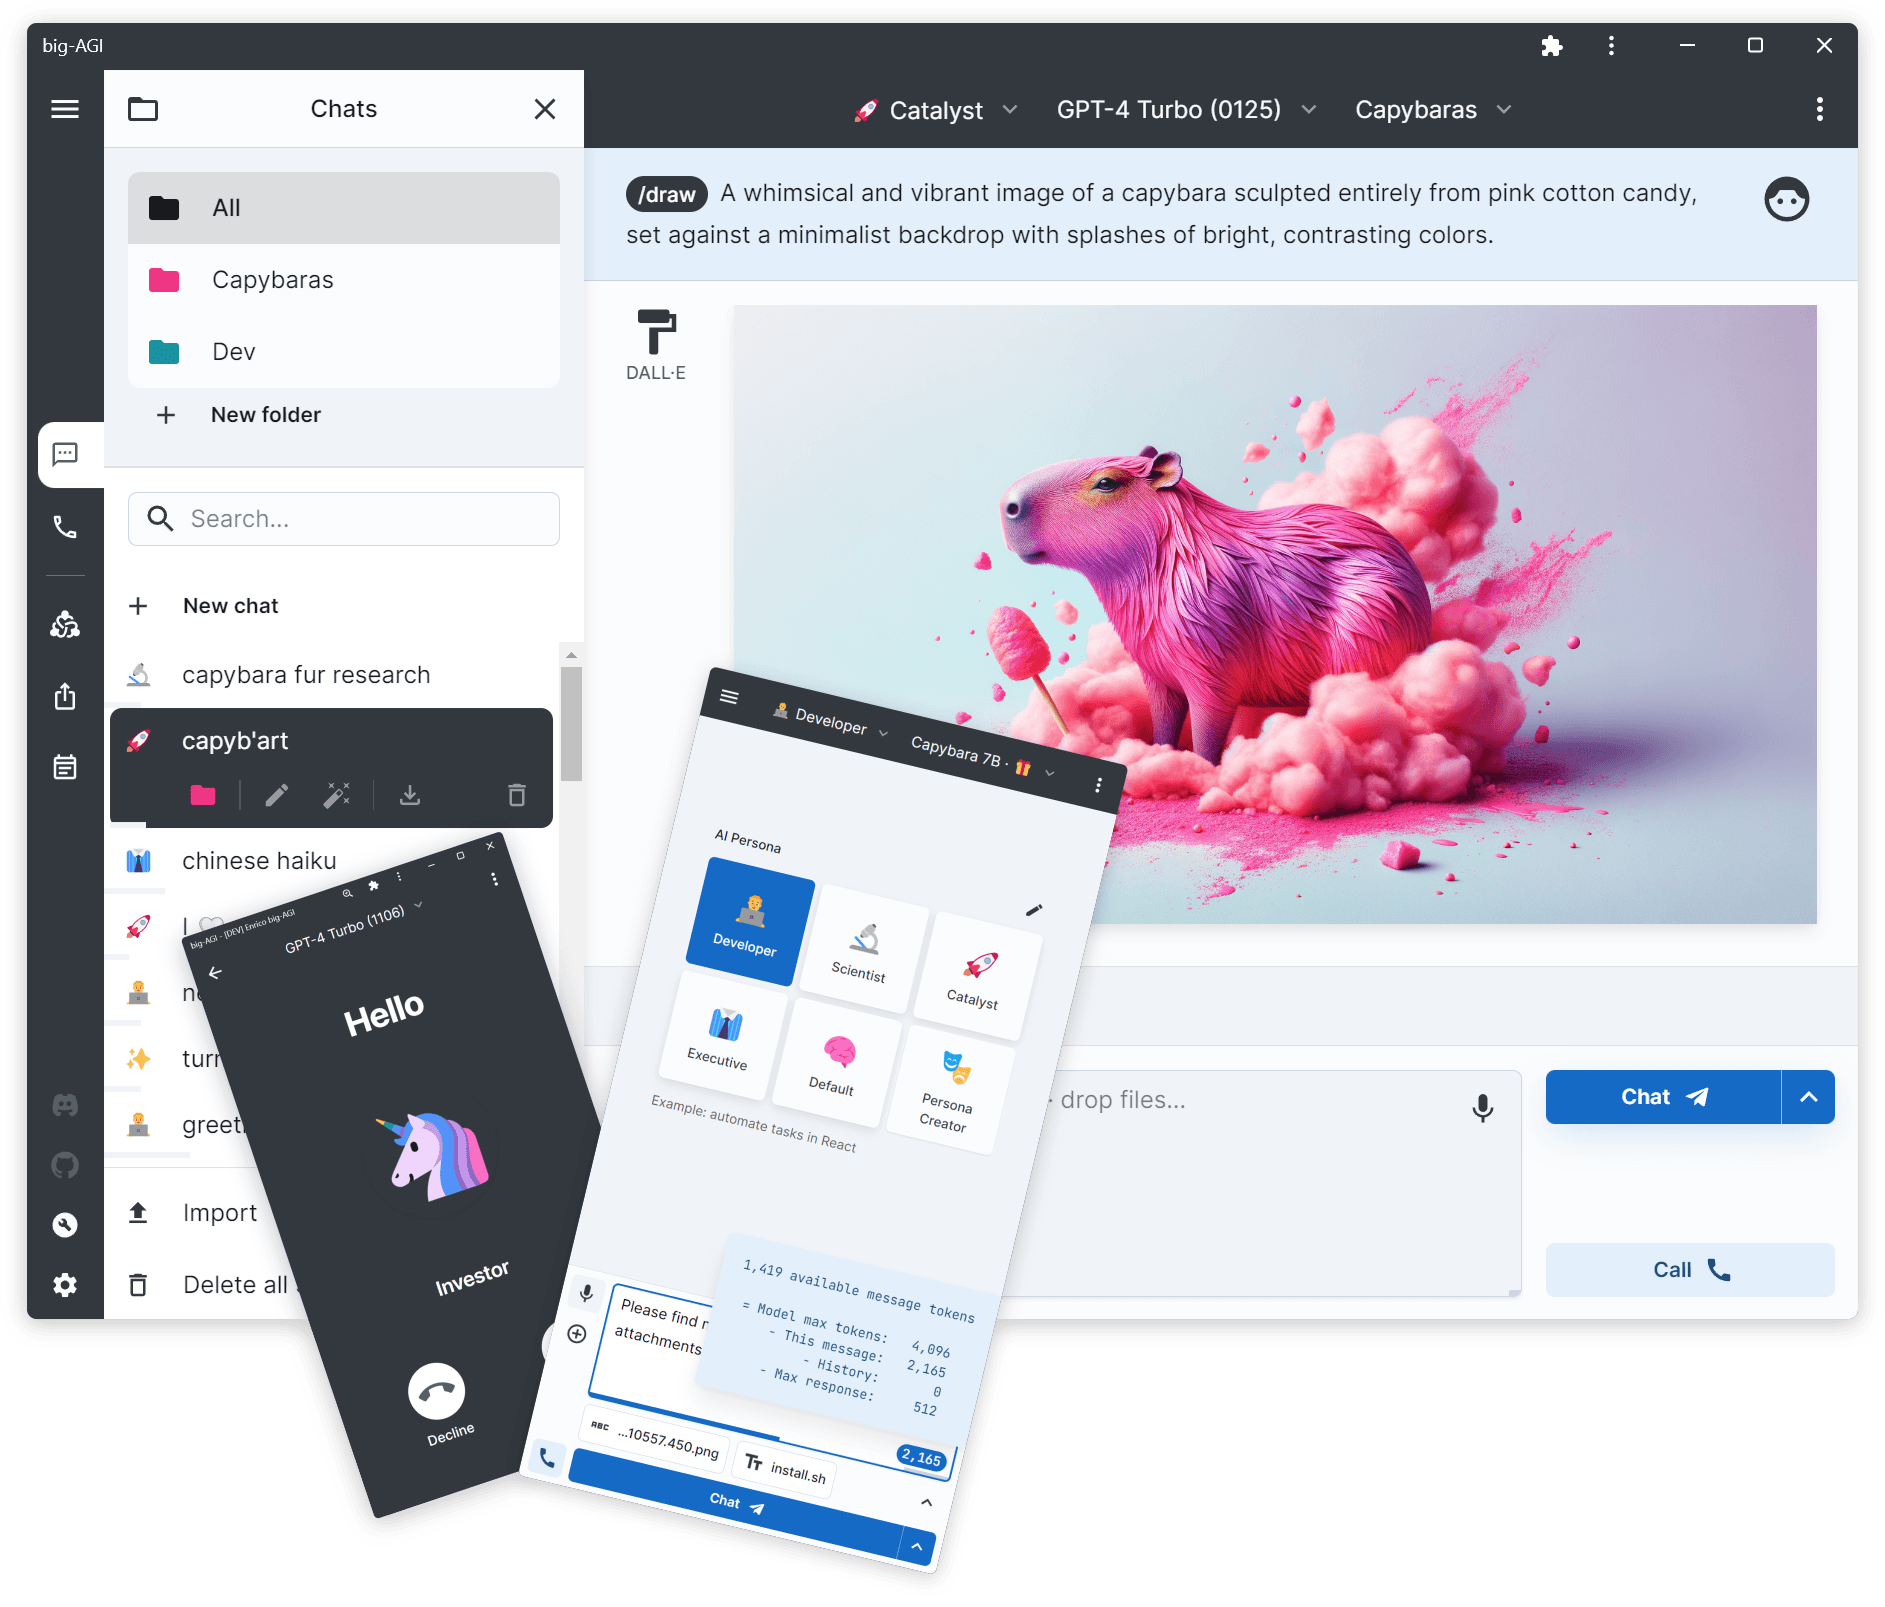
Big-AGI Open è concepito come uno spazio di lavoro multimodello, anziché come una replica di una chat basata su un unico provider. Può connettersi a Ollama, LM Studio, LocalAI e numerosi provider ospitati, permettendo di affiancare risposte generate in locale e nel cloud in un'unica interfaccia orientata alla ricerca.
I flussi di lavoro per il confronto e la sintesi sono utili quando vuoi che più modelli affrontino lo stesso problema. L'edizione Open self-hosted non include account utente nativi, quindi è più adatta a un singolo ricercatore che a un'installazione condivisa in famiglia, a meno che l'accesso non sia gestito tramite un reverse proxy.
- Ideale per: ricerca, confronto di modelli e lavoro ibrido tra locale e cloud.
- Sceglilo quando: passare da un modello all'altro o confrontarli è fondamentale per il flusso di lavoro.
- Attenzione a: provider cloud che compromettono un flusso di dati altrimenti locale.
7. NextChat — La migliore interfaccia IA locale leggera

NextChat è un'interfaccia per assistenti leggera, veloce e reattiva, distribuibile con Docker o come applicazione web. Supporta URL di base API personalizzati, modelli distribuiti autonomamente tramite endpoint compatibili, maschere per i prompt, risposte in streaming, utilizzo come PWA e supporto MCP opzionale.
È una scelta interessante quando si vuole che il server domestico dedichi le proprie risorse all'inferenza anziché a uno stack frontend pesante. Il meccanismo con codice di accesso è più semplice di una gestione completa di identità e autorizzazioni multiutente: se accedono più persone o da remoto, usa un reverse proxy sicuro.
- Ideale per: chat leggera su telefoni, tablet e server meno recenti.
- Sceglilo quando: velocità e semplicità contano più di una funzione RAG integrata.
- Attenzione a: considerare un codice di accesso condiviso come una protezione completa.
8. SillyTavern — Ideale per profili e controllo dei prompt

SillyTavern è un'interfaccia per browser installata localmente, pensata per gli utenti che desiderano un controllo approfondito su personaggi, profili, creazione dei prompt, lore, impostazioni di generazione, sintesi vocale e connessioni per la generazione di immagini. Può connettersi a un'ampia gamma di API locali per la generazione di testo.
Sebbene sia noto soprattutto per i giochi di ruolo e la scrittura creativa, la sua Data Bank aggiunge ai prompt conoscenze basate sul recupero delle informazioni. L'interfaccia richiede una curva di apprendimento più ripida ed è progettata principalmente per l'uso personale, ma poche alternative offrono lo stesso livello di controllo sulle conversazioni e sui personaggi.
- Ideale per: scrittura creativa, giochi di ruolo, personaggi e prompt avanzati.
- Sceglilo quando: è fondamentale controllare come vengono assemblati i prompt.
- Attenzione a: complessità della configurazione ed estensioni di terze parti.
9. Dify — Il migliore per creare applicazioni IA self-hosted
Dify è più pesante di una tipica interfaccia di chat perché è una piattaforma per applicazioni IA. Offre orchestrazione visuale, basi di conoscenza, agenti, flussi di lavoro, plugin, log e applicazioni web pubblicabili basate su modelli locali o remoti.
La distribuzione ufficiale con Docker Compose avvia numerosi servizi principali e di supporto, quindi Dify è più adatto a un home server potente che a un piccolo sistema a scheda singola. Sceglilo quando vuoi progettare strumenti riutilizzabili per la famiglia o applicazioni interne, non semplicemente sostituire una pagina di chat.
- Ideale per: creare, testare e pubblicare app IA.
- Sceglilo quando: flussi di lavoro, pipeline di conoscenza e interfacce riutilizzabili giustificano il carico aggiuntivo.
- Attenzione a: numero di container, backup dei database, aggiornamenti e utilizzo delle risorse.
10. Flowise — Migliore interfaccia visuale per i flussi di lavoro IA
Flowise è una piattaforma visuale per assemblare flussi di chat, flussi di agenti, strumenti, componenti di recupero e connessioni ai modelli. Supporta distribuzioni self-hosted e air-gapped e può collegarsi a modelli locali tramite componenti come Ollama.
Flowise è in questo elenco perché il suo generatore visuale e le interfacce di chat integrate sono utili in un home lab, ma non è il miglior client di chat generico per l'uso quotidiano. Si distingue quando l'interfaccia serve a progettare la logica dell'assistente.
- Ideale per: la prototipazione visiva di agenti e pipeline RAG.
- Sceglilo quando: vuoi creare flussi senza scrivere l'intera applicazione.
- Attenzione a: proteggere le credenziali, gli endpoint dei flussi e le autorizzazioni degli strumenti.
Quale interfaccia web per l'IA locale dovresti scegliere?
- Scegli Open WebUI per la migliore esperienza generale in un home lab.
- Scegli LibreChat per gli strumenti MCP, gli agenti e l'uso avanzato con più provider.
- Scegli LobeHub per uno spazio di lavoro personale curato.
- Scegli AnythingLLM se la priorità sono i documenti privati e RAG.
- Scegli text-generation-webui quando hai bisogno di controllare direttamente il caricamento dei modelli e l'inferenza.
- Scegli Big-AGI per confrontare modelli locali e cloud in un unico spazio di lavoro.
- Scegli NextChat per un'interfaccia di chat leggera.
- Scegli SillyTavern per personaggi, giochi di ruolo e progettazione di prompt.
- Scegli Dify o Flowise per creare un'applicazione o un flusso di lavoro basato sull'IA.
Un'architettura pratica per un home lab
Una configurazione affidabile separa quattro livelli: l'interfaccia web, il server di inferenza, il livello dati e l'accesso remoto. L'interfaccia può essere eseguita in un piccolo container Docker, mentre Ollama, llama.cpp o un altro runtime sfrutta la GPU dell'host. Documenti, file dei modelli, database e backup possono restare su un NAS, mentre un proxy inverso o una VPN privata controllano l'accesso dal browser.
Questa separazione semplifica gli aggiornamenti e impedisce che un guasto del frontend comprometta i modelli archiviati o i file privati. Inoltre, consente a un server a basso consumo di restare online 24 ore su 24, mentre una macchina con GPU si attiva solo per le inferenze più impegnative. Il confronto tra laboratorio AI compatto e NAS AI completo mostra come suddividere questi ruoli.
Esecuzione di un'interfaccia web AI locale su hardware Zima
ZimaBoard 2 è una soluzione pratica sempre attiva per interfacce web leggere, proxy inversi, autenticazione, database di piccole dimensioni e orchestrazione. Può connettersi in rete a Ollama o a un altro server di inferenza con una GPU dedicata. È possibile usare modelli di piccole dimensioni sulla CPU, ma il suo ruolo principale è coordinare i servizi, non sostituire una workstation AI di fascia alta.
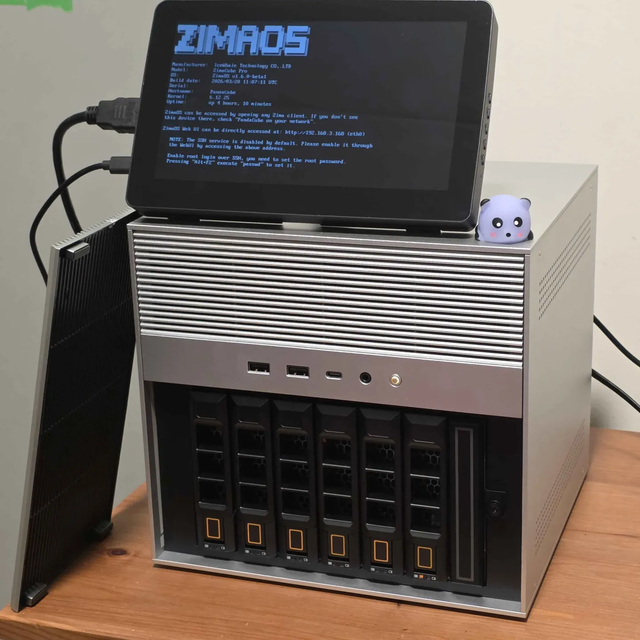
ZimaCube 2 offre spazio di archiviazione espandibile per pesi dei modelli, basi di conoscenza, file caricati e backup. È quindi un livello dati ideale per Open WebUI, AnythingLLM, LibreChat, Dify o Flowise. Per un esempio dettagliato, scopri come un flusso di lavoro AI NAS con ZimaCube 2 combina l'archiviazione con la ricerca privata e le funzionalità dell'assistente.
Lista di controllo della sicurezza prima di esporre l'interfaccia
- Non inoltrare direttamente la porta dell'applicazione a Internet. Usa una VPN o un proxy inverso con TLS e autenticazione robusta.
- Crea account utente separati, se supportato. Non condividere una sessione amministratore con gli altri componenti della famiglia.
- Limita gli endpoint dei modelli e degli strumenti. Ollama, database, server MCP e servizi di esecuzione del codice dovrebbero restare su reti affidabili.
- Salva e fai il backup dei dati dell'applicazione. La cronologia delle chat, gli archivi vettoriali, la configurazione e i documenti caricati devono essere conservati quando sostituisci un container.
- Controlla le connessioni in uscita. I modelli cloud, la ricerca sul web, i provider vocali, i plugin e la telemetria possono inviare dati al di fuori dell'home lab.
- Aggiorna con criterio. Fissa versioni dei container che sai essere affidabili, leggi le note di migrazione e conserva un backup pronto per il ripristino.
Se stai scegliendo tra i container e l'installazione diretta, la guida a Docker rispetto alle app native per l'IA locale illustra isolamento, accesso alla GPU, aggiornamenti e risoluzione dei problemi.
Domande frequenti
Qual è la migliore interfaccia web per Ollama?
Open WebUI è la scelta predefinita migliore per la maggior parte degli utenti di Ollama, perché offre una connessione semplice, supporto per più utenti, RAG, strumenti, allegati e un'interfaccia adatta all'uso quotidiano. NextChat è più leggero, mentre LibreChat è più completo per gli agenti e le integrazioni MCP.
Un'interfaccia web per l'IA locale può funzionare su una macchina diversa da quella del modello?
Sì. L'interfaccia web può funzionare su un server domestico a basso consumo e collegarsi tramite LAN a Ollama, vLLM, LocalAI o un altro servizio di inferenza compatibile su una macchina con GPU. Spesso è la soluzione più efficiente per un home lab.
L'hosting autonomo dell'interfaccia garantisce la privacy?
No. La privacy dipende da ogni endpoint configurato. Un'interfaccia locale collegata a un modello cloud o a un provider di ricerca esterno può comunque trasmettere prompt e file. Controlla le API dei modelli, gli embedding, gli strumenti, i servizi vocali, i plugin e i log.
Qual è l'interfaccia migliore per chattare con documenti privati?
AnythingLLM è l'opzione chiavi in mano più mirata per la RAG basata sui documenti. Open WebUI e LibreChat sono preferibili se la chat sui documenti è una funzione tra tante, mentre Dify e Flowise sono adatti a pipeline di recupero personalizzate.
Mi serve una GPU per ospitare l'interfaccia web?
No. Di norma, l'interfaccia stessa viene eseguita sulla CPU. La GPU viene usata dal server dei modelli, che può trovarsi sulla stessa macchina o su un altro sistema. Questa separazione permette a un server efficiente di ospitare l'interfaccia in modo continuativo.
Verdetto finale
Open WebUI è il miglior punto di partenza per la maggior parte degli home lab con IA locale, perché bilancia facilità d'uso, supporto per i modelli locali, RAG, strumenti e accesso multiutente. Scegli LibreChat per installazioni incentrate sugli agenti, AnythingLLM per i documenti privati, text-generation-webui per il controllo dell'inferenza e Dify o Flowise per creare applicazioni. L'interfaccia giusta è quella che offre le funzionalità di cui hai bisogno senza trasformare un servizio domestico privato in una piattaforma inutilmente complessa.

Prodotti consigliati


Hub di tecnologia e IA
Altre letture
Blocco della versione degli embedding: perché i vettori delle query e dei documenti devono rimanere compatibili
Una spiegazione dell’associazione delle versioni degli embedding incentrata sui meccanismi, dei compromessi relativi alle risorse condivise, di tre domande frequenti sull’espansione delle query e...
Archiviazione dei modelli basata sul contenuto: come gli hash impediscono il download duplicato dei pesi
Una spiegazione incentrata sui meccanismi dell'archiviazione dei modelli con indirizzamento basato sul contenuto, dei compromessi legati alle risorse condivise, tre domande frequenti sulla distribuzione...
Azioni di compensazione degli agenti: come i passaggi reversibili limitano i guasti parziali del flusso di lavoro
Una spiegazione dei meccanismi alla base delle azioni di compensazione degli agenti, dei compromessi relativi alle risorse condivise, di tre FAQ sull’espansione delle query...


