
Cataloghi dei punti di ripristino: come i manifest delle dipendenze ricostruiscono uno stack AI privato


L'effetto osservabile di solito si manifesta perché le voci del catalogo associano versioni di modello, indice, metadati, configurazione e segreti; le risorse condivise e la tempistica ne determinano l'entità pratica.
In un flusso di lavoro su un server domestico, i cataloghi dei punti di ripristino possono modificare sia il comportamento interattivo sia l'uso delle risorse in background. L'effetto visibile emerge solo dopo che la richiesta attraversa diverse fasi di elaborazione, perciò un singolo valore medio può nascondere dove sono iniziati il ritardo, la perdita di qualità o l'errore. Separare lo stato di trasporto, calcolo, archiviazione e applicazione rende verificabile il rapporto a parità di tutte le altre condizioni.
Come i cataloghi dei punti di ripristino raggiungono il livello visibile all'utente
L'effetto visibile all'utente è una conseguenza di questa condizione: le voci del catalogo associano versioni di modello, indice, metadati, configurazione e segreti. Questa fase cambia ciò che riceve il componente successivo, quindi il risultato osservato non può essere attribuito soltanto all'interfaccia finale o al modello. Mantenere costanti l'input e il carico di lavoro rende visibile questa trasformazione iniziale.
Il modello di rilevamento dell'MTU del percorso offre un modo concreto per interpretare questa fase: le voci del catalogo associano versioni di modello, indice, metadati, configurazione e segreti. In pratica, permette di distinguere la variabile modificata dai successivi effetti di buffering, pianificazione, archiviazione o rendering, che possono produrre sintomi simili.
Quando cambia la prima fase, i manifest delle dipendenze selezionano gli elementi compatibili durante la ricostruzione. A seconda del tema dell'articolo, la conseguenza può manifestarsi sotto forma di latenza, precisione, consumo energetico, capacità o fluidità percepita, ma il nesso causale ha comunque origine prima che venga mostrato il risultato finale.
L'accoppiamento delle risorse che determina il risultato
L'accoppiamento delle risorse è importante perché durante la ricostruzione i manifest delle dipendenze selezionano gli elementi compatibili. I processi simultanei di IA, archiviazione, contenuti multimediali o automazione possono quindi amplificare un effetto che in un benchmark con una sola richiesta appare contenuto. Il comportamento nei casi peggiori conta più della media a sistema inattivo.
Il meccanismo di rilevamento delle dimensioni dei pacchetti collega il livello delle risorse condivise al risultato: durante la ricostruzione, i manifest delle dipendenze selezionano gli elementi compatibili. Misurare separatamente questo livello evita di confondere il throughput, gli hit della cache, le conferme o gli aggiornamenti ottimistici dello stato con il completamento del lavoro visibile all'utente.
L'interazione prosegue perché la correttezza del catalogo dipende dalla verifica degli oggetti a cui fa riferimento prima di un disastro. Per questo, due server domestici con le stesse caratteristiche hardware dichiarate o la stessa velocità di rete possono comportarsi diversamente quando cambiano la profondità della coda, la disposizione dei dati, lo stato della cache o i criteri.
Quando i cataloghi dei punti di ripristino non sono determinanti
L’effetto dichiarato non si applica universalmente. In questo caso, l’intero stack viene ricreato dal codice sorgente senza vincoli sui tempi di ripristino. Un altro collo di bottiglia può determinare il limite massimo prima che una modifica ai cataloghi dei punti di ripristino diventi misurabile.
La relazione con elaborazione dei messaggi DNS aiuta a distinguere il meccanismo atteso da una spiegazione alternativa. In un test controllato, i dati sorgente, l’hardware, la concorrenza, lo stato della cache e le versioni software devono rimanere invariati, modificando solo la variabile indicata nel titolo.
Il limite di validità viene raggiunto quando l’intero stack viene ricreato dal codice sorgente senza vincoli sui tempi di ripristino. Oltre quel punto, un’ottimizzazione più aggressiva può aumentare costi, rischi o instabilità senza migliorare il risultato promesso dal titolo.

Domande frequenti sui cataloghi dei punti di ripristino
I cataloghi dei punti di ripristino sono il collo di bottiglia principale?
Non automaticamente. È il collo di bottiglia principale solo quando modificarlo cambia il risultato, mentre i manifest delle dipendenze selezionano artefatti compatibili durante la ricostruzione e le altre condizioni restano fisse. Se l’output non cambia, è un’altra fase a determinare il limite massimo.
La memorizzazione nella cache può nascondere l’effetto dei cataloghi dei punti di ripristino?
Sì. Le cache precaricate, le sessioni mantenute, i modelli residenti, i contenuti multimediali bufferizzati e gli aggiornamenti ottimistici dell’interfaccia possono bypassare la fase analizzata. Le esecuzioni a freddo e a caldo vanno riportate separatamente. Questa dipendenza deve rimanere visibile in un test ripetibile su un home server.
Qual è la metrica più importante per i cataloghi dei punti di ripristino?
Le misurazioni utili sono la copertura del catalogo, gli oggetti mancanti, l’RPO e l’RTO. I valori medi vanno affiancati da latenza di coda, errori, qualità o costo delle risorse, per evitare di scambiare un risultato dall’aspetto più regolare per un sistema migliore. Il risultato va valutato separatamente dalle fasi adiacenti della pipeline.
Esegui un test controllato dei cataloghi dei punti di ripristino
Crea un carico di lavoro rappresentativo e registra la copertura del catalogo, gli oggetti mancanti, l’RPO e l’RTO prima di modificare i cataloghi dei punti di ripristino. Esegui prove a freddo e a caldo, includi una concorrenza realistica e mantieni gli stessi dati, versioni, hardware e criteri di successo visibili all’utente in ogni confronto.
Usa il meccanismo correlato in cataloghi dei punti di ripristino per definire la direzione attesa prima del test. Modifica una sola variabile alla volta, registra la mediana e l’andamento delle code e conserva il caso non riuscito o degradato, così che il risultato includa il relativo limite operativo.
Adotta la modifica solo quando il beneficio misurato si mantiene nelle prove ripetute e il limite dichiarato resta accettabile. Se un’altra fase è predominante, lascia invariati i cataloghi dei punti di ripristino e verifica invece quel collo di bottiglia, senza dedurre un rapporto di causa-effetto dalla correlazione.

Prodotti consigliati

Hub di tecnologia e IA
Altre letture
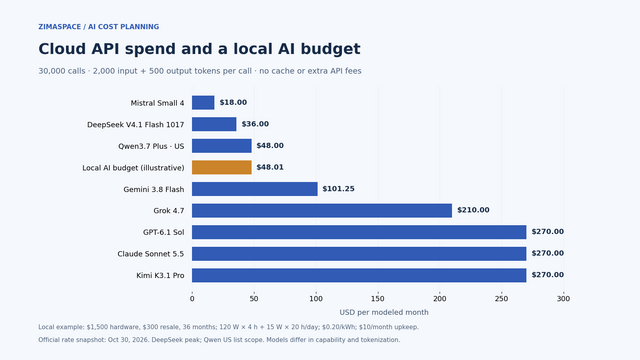
Cloud AI API Pricing vs Local AI: What Does Your Workload Really Cost?
Compare cloud API token charges with local AI hardware, electricity and upkeep. Work through a monthly example and use the free ZimaSpace cost calculator.

Il problema del segreto zero: perché un agente AI domestico ha ancora bisogno di una radice di fiducia iniziale
Una spiegazione del problema del secret zero basata sui meccanismi, dei compromessi legati alle risorse condivise, di tre domande frequenti sulla propagazione delle query...
Federazione delle identità dei carichi di lavoro: come i servizi locali evitano le chiavi API condivise
Una spiegazione della federazione delle identità dei carichi di lavoro incentrata sui meccanismi, dei compromessi relativi alle risorse condivise, di tre FAQ sulla propagazione...


