
Top 10 des interfaces web d’IA locale pour les laboratoires domestiques en 2026


Une bonne interface web d’IA locale transforme un serveur de modèles en ligne de commande en un service privé que tout le monde à la maison peut utiliser. Les meilleures options conservent aussi l’historique des discussions, gèrent les modèles et ajoutent des documents ou des outils sans obliger chaque utilisateur à comprendre l’infrastructure sous-jacente.
Open WebUI est le meilleur choix global pour la plupart des labos à domicile, mais ce n’est pas forcément la meilleure interface pour tous les usages. LibreChat offre des fonctionnalités plus poussées pour les agents et les outils MCP, AnythingLLM privilégie le RAG à partir de documents, text-generation-webui donne accès à des commandes d’inférence plus avancées, tandis que Dify ou Flowise sont plus adaptés à la création d’applications qu’à la simple discussion. Le comparatif ci-dessous met l’accent sur les usages pratiques pour vous aider à choisir l’interface la plus simple qui réponde à vos besoins réels.
Comparatif des interfaces web d’IA locales
| Classement | Interface web | Idéal pour | Connexion à un modèle local | Multi-utilisateur | Niveau de configuration |
|---|---|---|---|---|---|
| 1 | Open WebUI | Meilleure interface globale pour un labo à domicile | Ollama et API compatibles avec OpenAI | Oui | Facile à modéré |
| 2 | LibreChat | Agents, MCP et utilisateurs avancés | Ollama et plusieurs points de terminaison d’API | Oui | Modéré |
| 3 | LobeHub | Espace de travail d’IA personnel soigné | Ollama et prise en charge étendue des fournisseurs | Avec déploiement serveur | Modéré |
| 4 | AnythingLLM | Documents privés et RAG prêt à l’emploi | Fournisseurs de LLM locaux et cloud | Oui, dans l’édition Docker | Facile à modéré |
| 5 | text-generation-webui | Chargement des modèles et contrôle de l’inférence | Moteurs d’inférence intégrés | Limité | Modéré à avancé |
| 6 | Big-AGI | Comparaison de plusieurs modèles et recherche | Ollama, LM Studio, LocalAI, API | Pas de comptes natifs dans l’édition Open | Modéré |
| 7 | NextChat | Discussion légère et réactive | Points de terminaison compatibles avec OpenAI et LocalAI | Code d’accès de base | Facile |
| 8 | SillyTavern | Jeu de rôle, personnages et contrôle des prompts | Large choix d’API de modèles locaux | Principalement pour un usage personnel | Modéré |
| 9 | Dify | Création et publication d’applications d’IA | Modèles locaux via des fournisseurs/extensions | Oui | Avancé |
| 10 | Flowise | Agents visuels et flux de travail LLM | Ollama et autres nœuds de modèles | Contrôles d’accès disponibles | Avancé |
La note de configuration concerne l’interface et les services qui la prennent en charge, pas l’inférence du modèle. L’exécution d’un grand modèle local peut nécessiter beaucoup plus de RAM ou de capacité GPU que l’interface web elle-même.
Comment nous avons classé ces interfaces d’IA locales
Nous avons privilégié l’utilité pour les labos à domicile plutôt que le nombre de fonctionnalités. Chaque interface a été évaluée selon sa compatibilité avec les modèles locaux, la prise en charge de Docker ou de l’auto-hébergement, la facilité d’utilisation depuis d’autres appareils du réseau local, les fonctionnalités RAG et agent, la gestion des utilisateurs, la charge de maintenance et la clarté de la documentation de déploiement du projet.
La confidentialité dépend aussi de la configuration. Une interface auto-hébergée peut quand même envoyer des prompts à des API cloud, des services de recherche, des points de terminaison de télémétrie ou des outils externes si vous les activez. Pour une pile véritablement locale, gardez le point de terminaison du modèle, les embeddings, la base de données vectorielle, les services vocaux et le stockage au sein de votre réseau. Le guide ZimaSpace sur les LLM locaux privés explique le parcours complet des données.
1. Open WebUI — La meilleure interface web d’IA locale, toutes catégories confondues
Open WebUI est le choix par défaut le plus sûr pour un laboratoire domestique, car il associe une expérience de chat accessible à suffisamment de fonctionnalités pour rester utile à mesure que l’installation évolue. Il se connecte directement à Ollama et aux API compatibles avec OpenAI, peut fonctionner hors ligne et prend en charge plusieurs modèles sans lier l’interface à un seul moteur d’inférence.
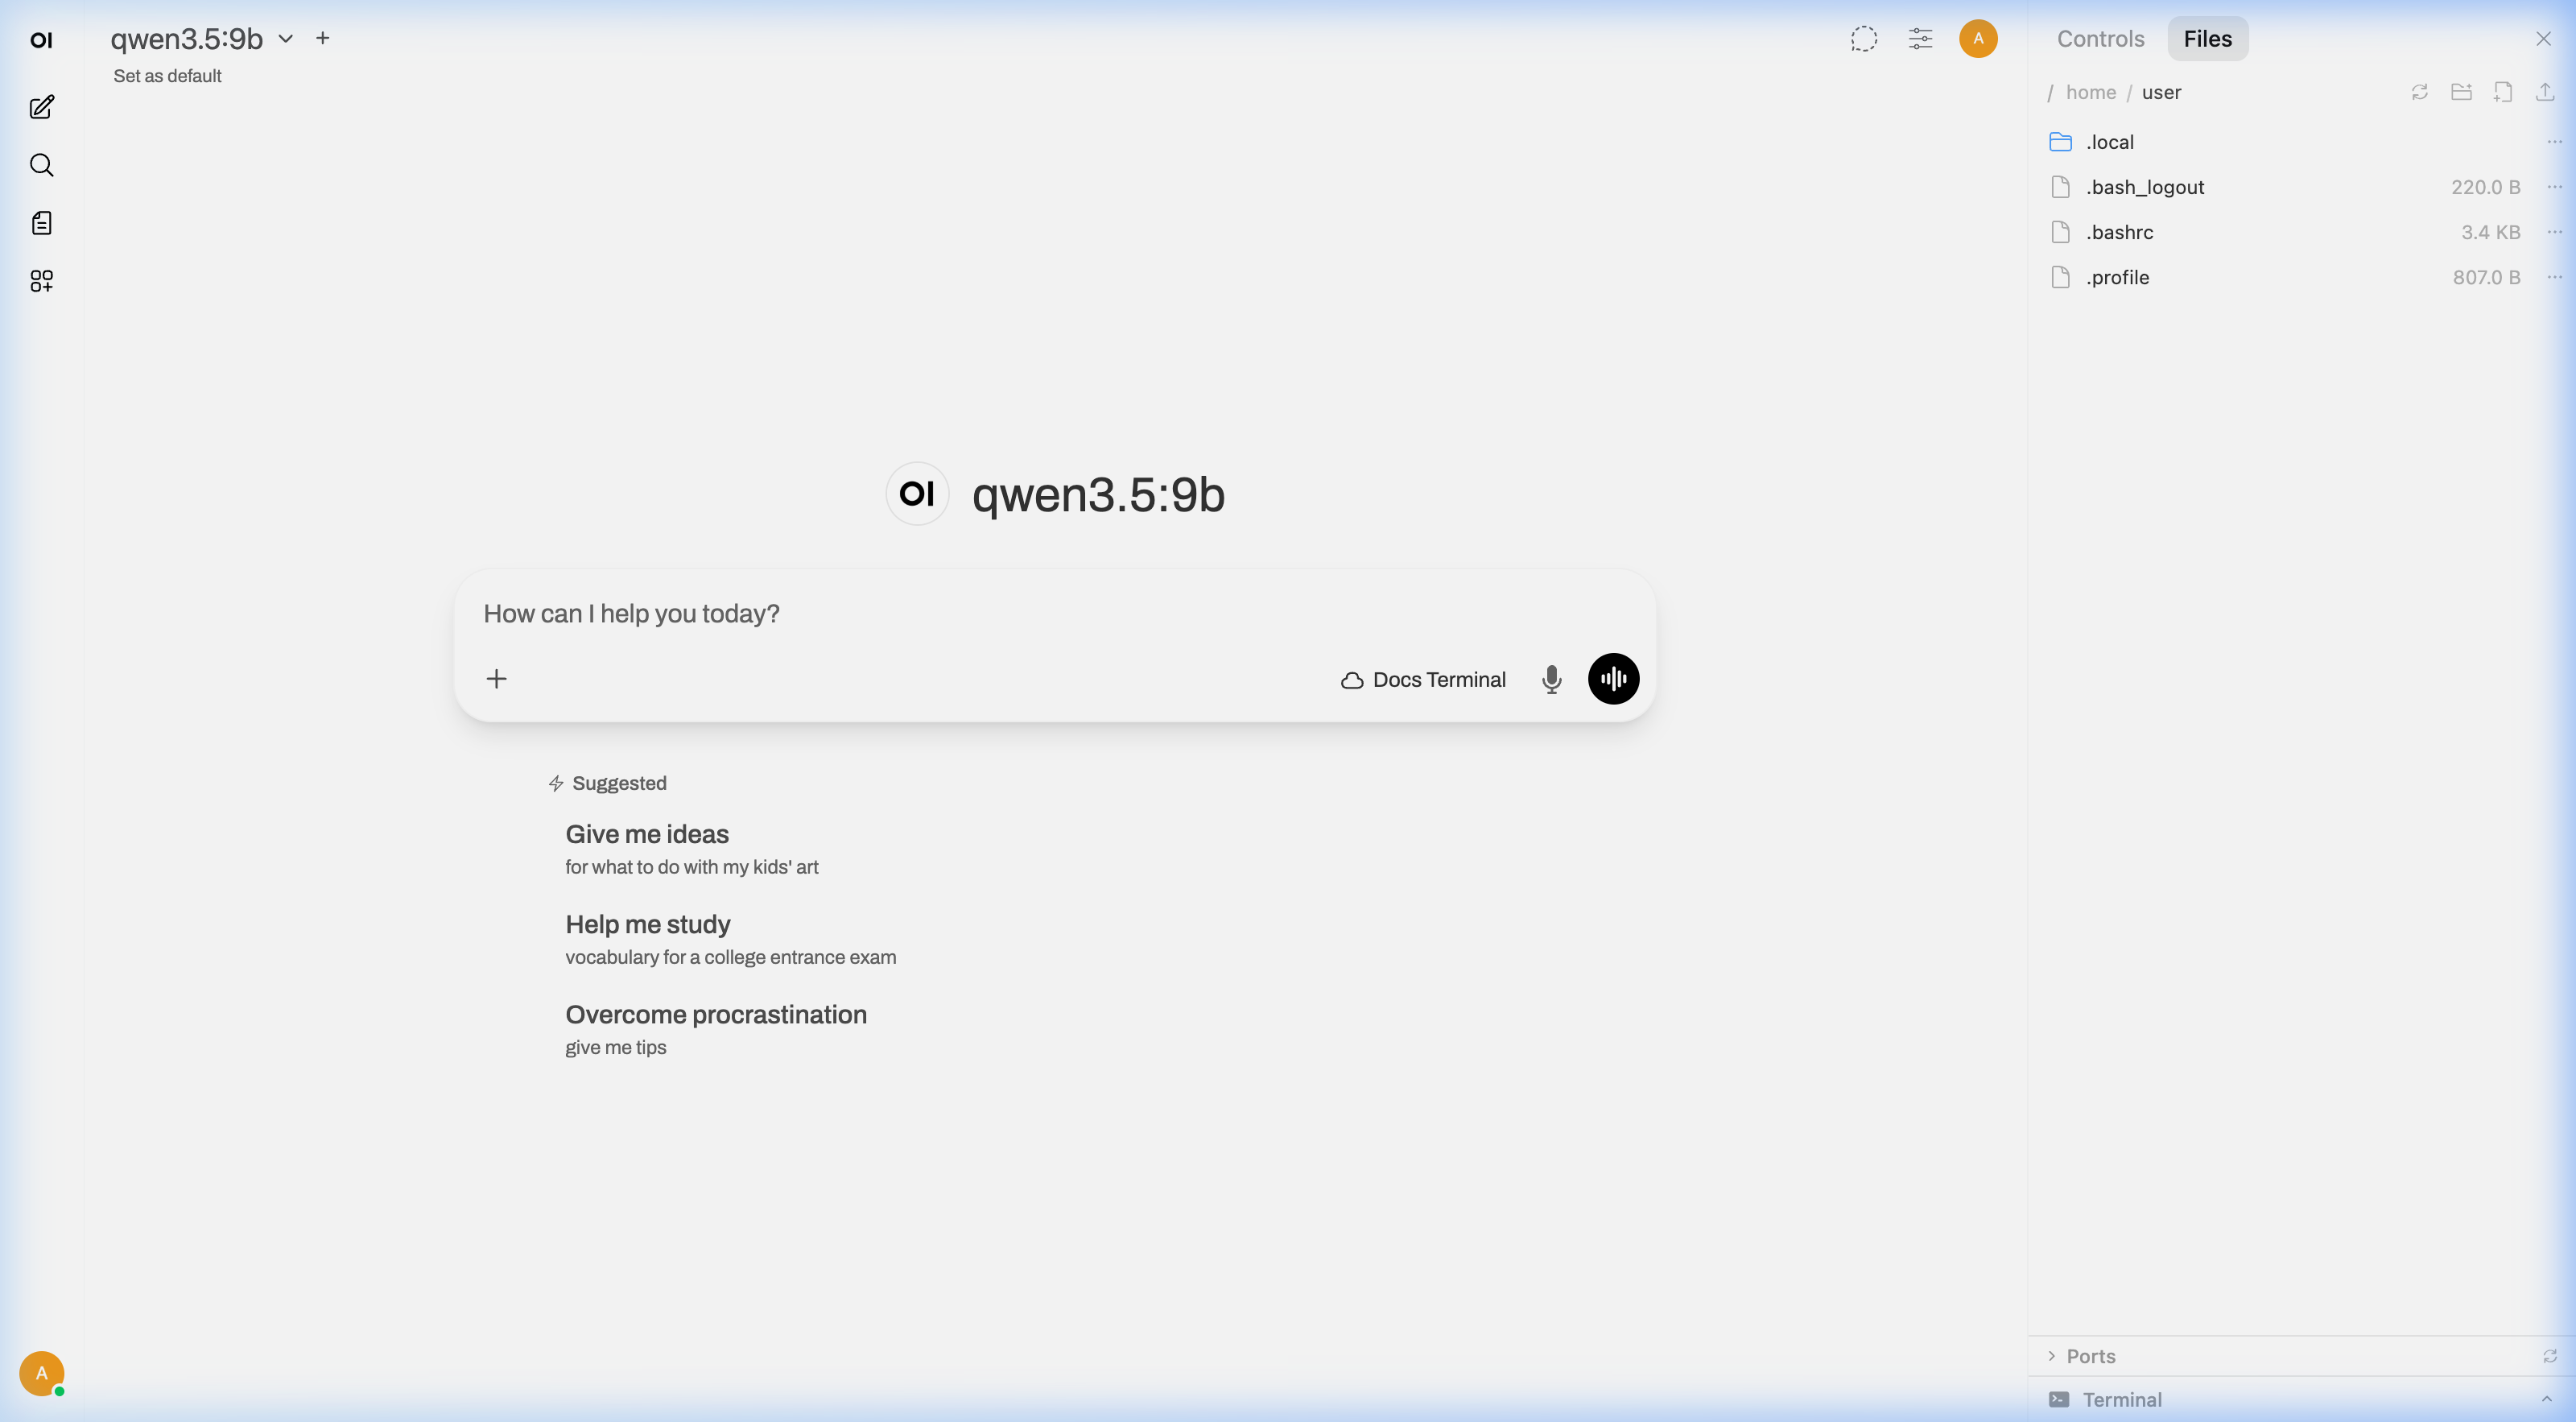
Ses fonctionnalités comprennent les pièces jointes de fichiers et d’images, le RAG, la recherche sur le Web, l’exécution de code, les outils, la mémoire, les conversations avec plusieurs modèles et la gestion des utilisateurs. Son principal inconvénient est sa complexité : chaque fonctionnalité activée ajoute des services, des autorisations et des chemins réseau potentiels qu’il faut maintenir.
- Idéal pour : les familles, les passionnés et les serveurs domestiques multi-utilisateurs.
- À choisir lorsque : vous voulez une interface de type ChatGPT opérationnelle dès maintenant et évolutive par la suite.
- À surveiller : la configuration réseau de Docker entre Open WebUI et un service Ollama hébergé sur un autre appareil.
2. LibreChat — Le meilleur pour les agents et les outils MCP
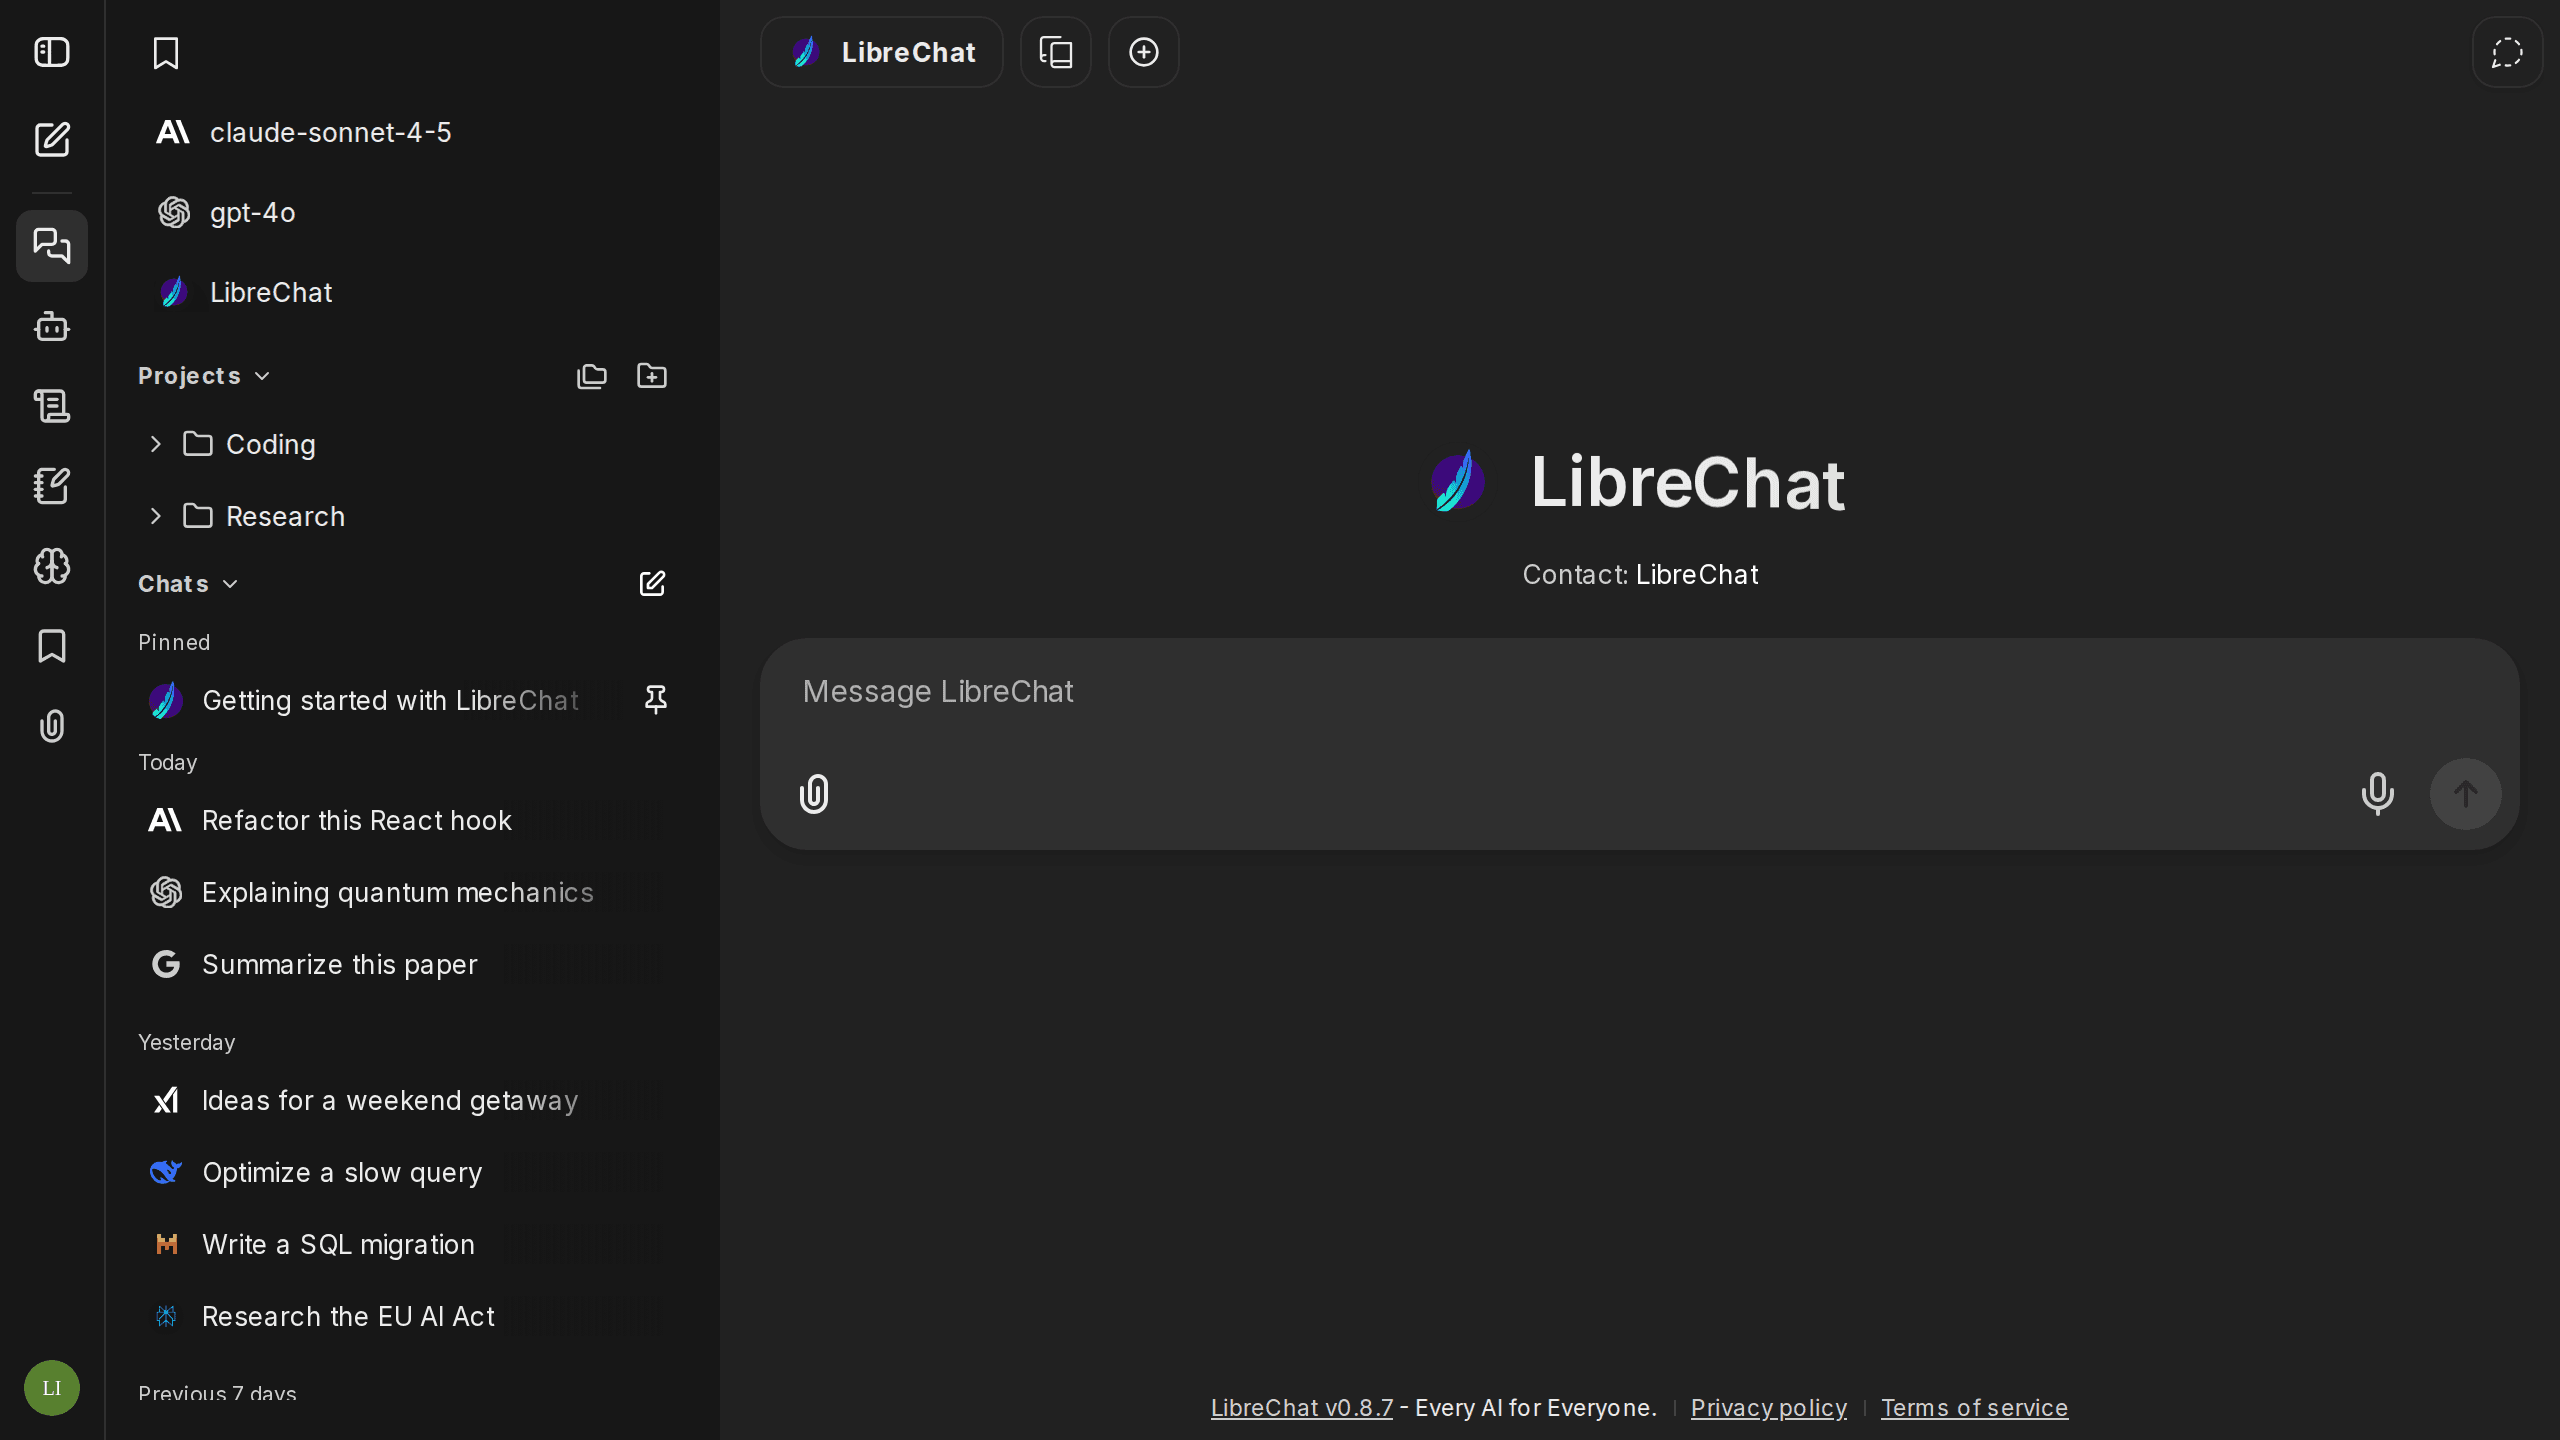
LibreChat convient parfaitement aux utilisateurs qui souhaitent réunir des modèles locaux et des modèles cloud dans une interface d’assistant complète. Ses fonctionnalités actuelles comprennent des agents, le RAG, le chat multimodal, l’exécution de code, des artefacts, la recherche sur le Web, une mémoire persistante et de nombreuses options d’authentification.
La fonctionnalité phare est l’intégration du Model Context Protocol. Les serveurs MCP peuvent être directement accessibles dans le chat ou associés à des agents spécifiques, ce qui est utile pour connecter un assistant privé à des fichiers, des bases de données, des outils d’automatisation ou des services internes de laboratoire domestique.
- Idéal pour : les créateurs d’agents, les développeurs et les installations avancées multi-utilisateurs.
- À choisir lorsque : les outils et la flexibilité des fournisseurs comptent davantage que la simplicité de configuration.
- À surveiller : une interface de configuration plus vaste que celle des interfaces de chat légères.
3. LobeHub — Le meilleur espace de travail IA personnel au design soigné
LobeHub, auparavant connu sous le nom de LobeChat, se distingue par son interface soignée et sa large prise en charge des fournisseurs de modèles. Son intégration d’Ollama permet d’afficher les modèles hébergés en local dans le même espace de travail moderne que les agents et les modèles fournis par des prestataires.
Il prend également en charge le téléversement de fichiers et les workflows de base de connaissances, mais le déploiement complet du serveur nécessite davantage d’infrastructure que celui d’une interface accessible uniquement par navigateur. Choisissez-le si la présentation, l’organisation des agents et un espace de travail personnel complet comptent davantage qu’un nombre minimal de conteneurs.
- Idéal pour : les utilisateurs qui privilégient la qualité de l’interface et des assistants IA bien organisés.
- Choisissez-le si : vous souhaitez accéder à Ollama en local sans renoncer à un espace de travail soigné.
- À surveiller : les différences entre les déploiements client simples et les fonctionnalités complètes reposant sur une base de données.
4. AnythingLLM — Le meilleur choix pour les documents privés et le RAG
AnythingLLM vise à transformer des fichiers privés en espaces de travail IA utiles. Il réunit l’ingestion de documents, les embeddings, le stockage vectoriel, le chat et les agents dans une seule application, réduisant le nombre de composants qu’un débutant doit assembler lui-même.
L’édition Docker prend en charge l’accès par navigateur, plusieurs utilisateurs, les autorisations des espaces de travail et les connexions aux LLM locaux. C’est un meilleur premier choix qu’une interface de chat généraliste lorsque le besoin principal est de poser des questions sur des manuels, des notes, des travaux de recherche ou des archives familiales.
- Idéal pour : les questions-réponses sur des documents et le RAG local clé en main.
- Choisissez-le si : les fichiers sont au cœur de votre flux de travail.
- À surveiller : les choix d’intégration et de base de données vectorielle, qui influent sur la qualité de la recherche indépendamment du modèle de chat.
5. text-generation-webui — Le meilleur choix pour contrôler les modèles et l’inférence
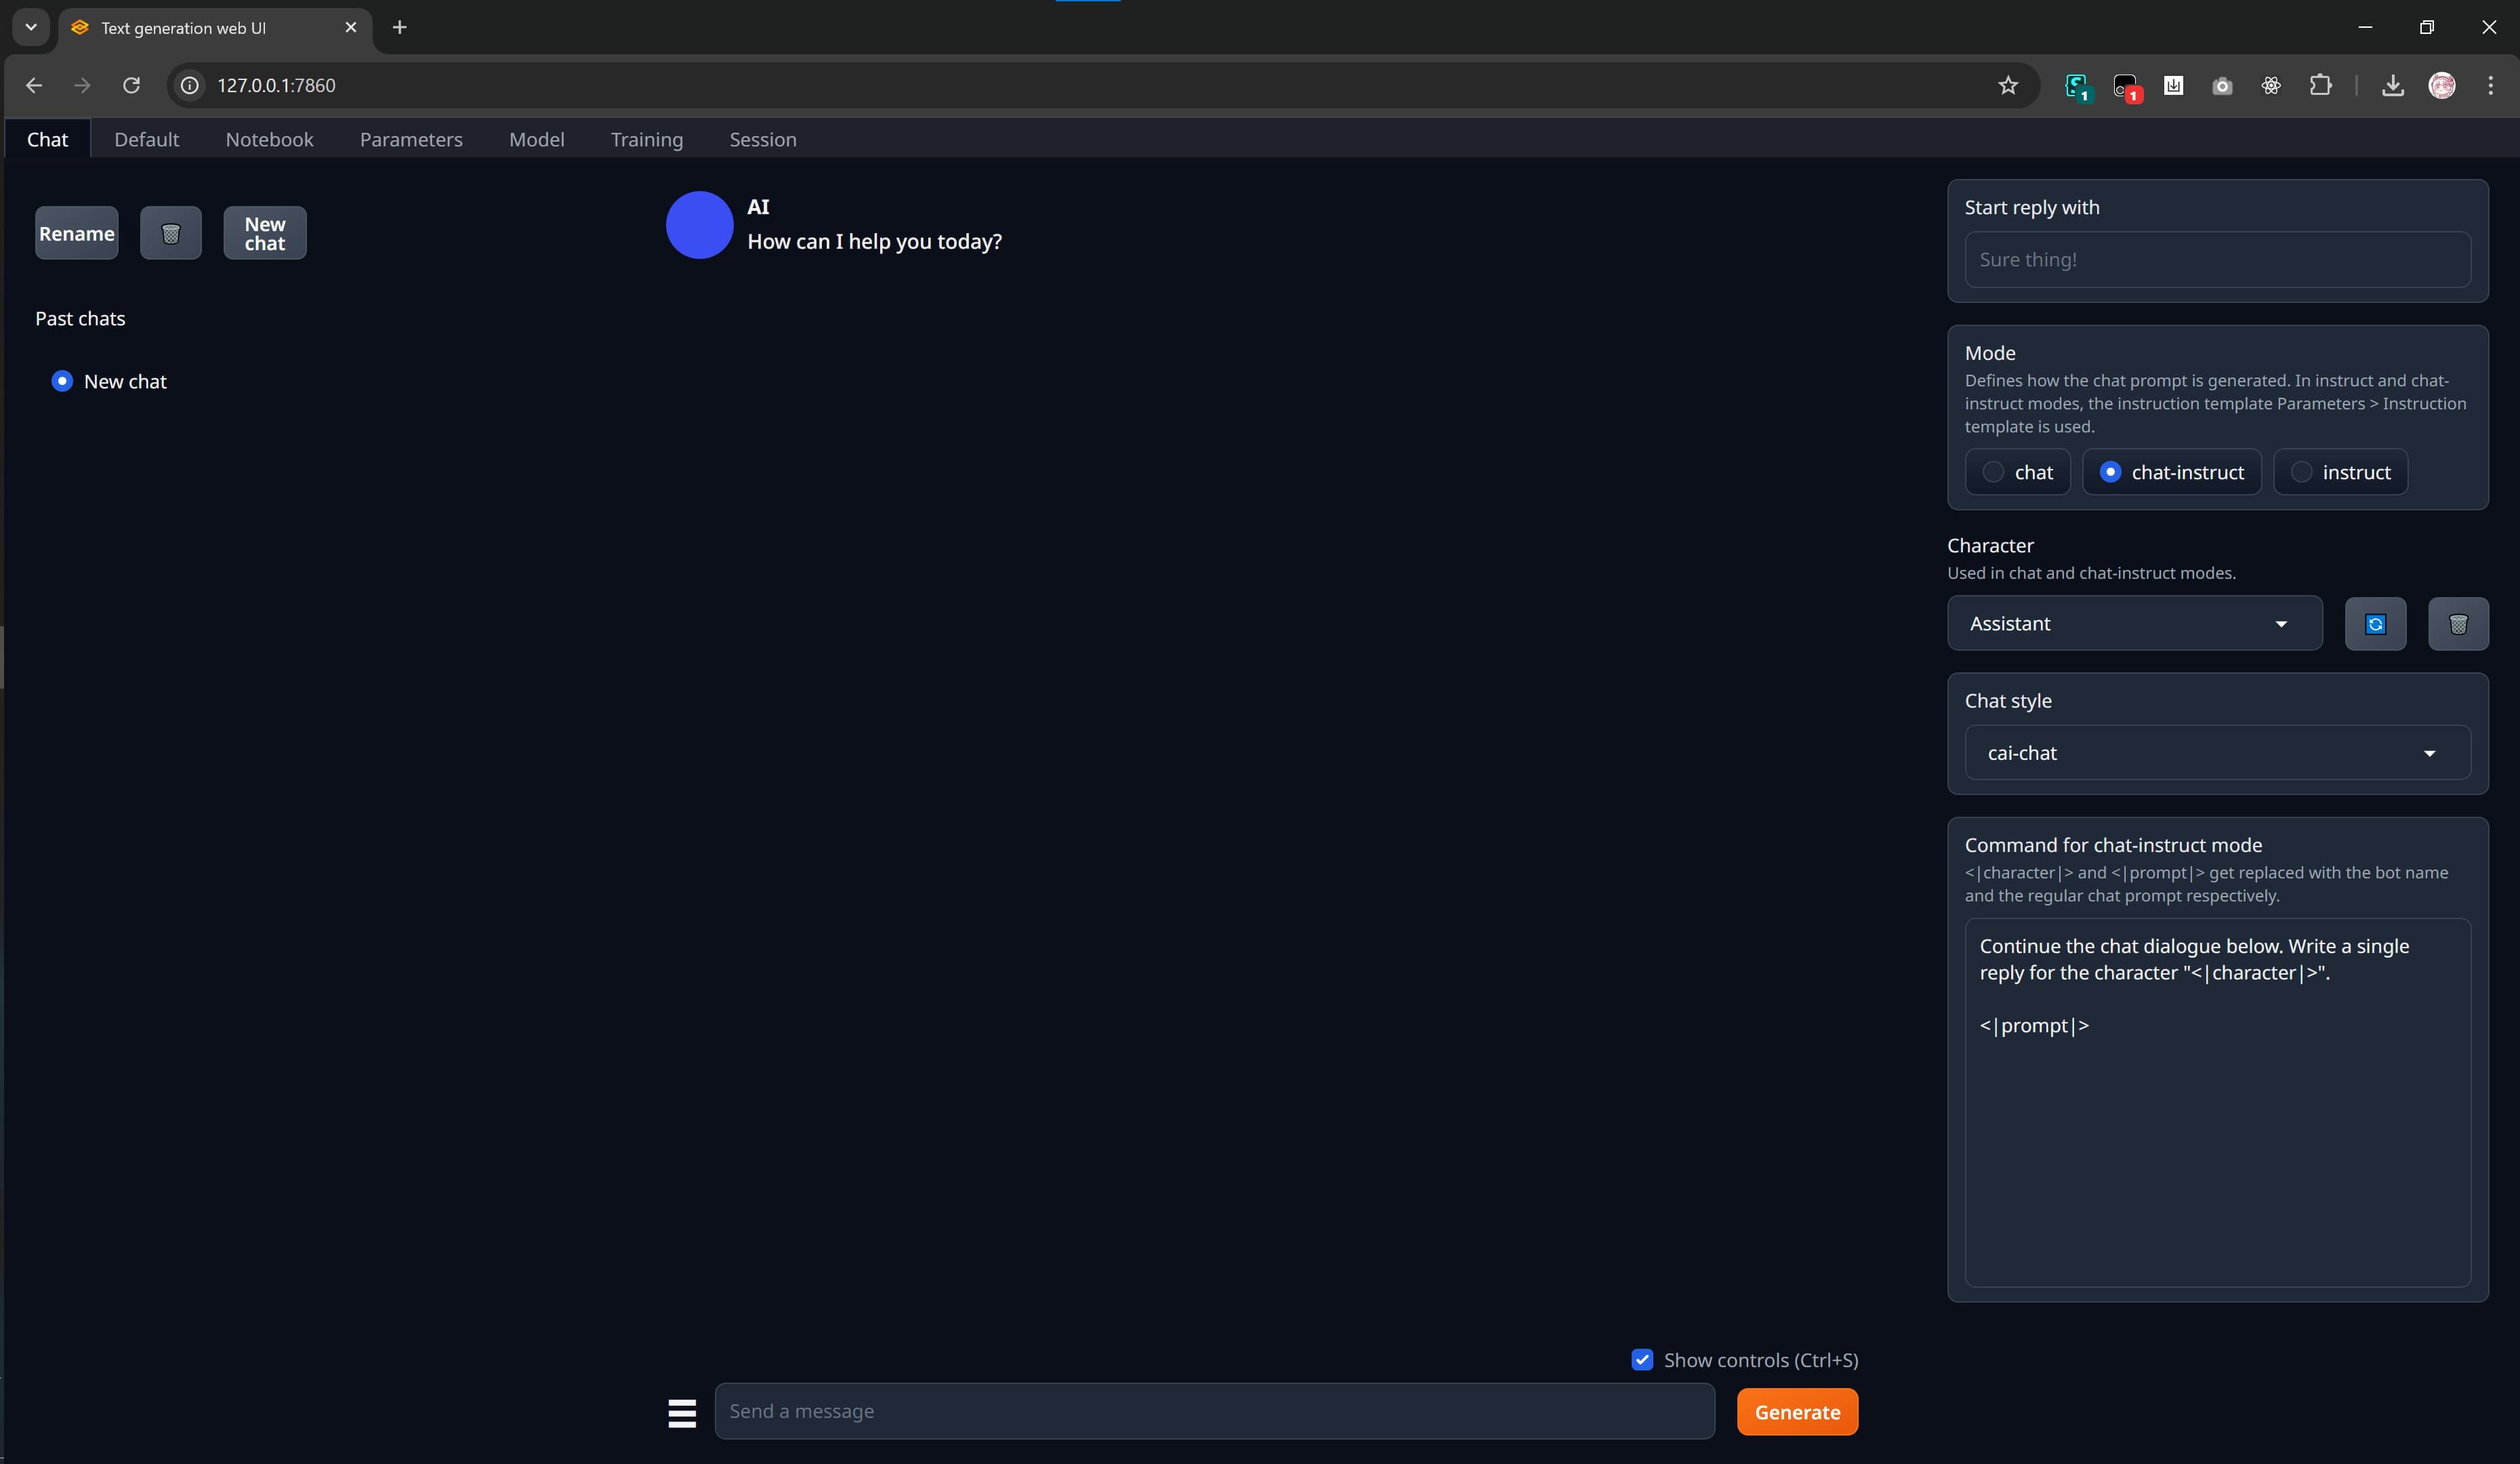
text-generation-webui est à la fois une interface navigateur et un environnement flexible d’inférence locale. Il prend en charge plusieurs backends, dont llama.cpp, Transformers, ExLlama et TensorRT-LLM, tout en donnant accès au chargement des modèles, à l’échantillonnage, aux modèles de prompt, aux extensions et à une API compatible avec OpenAI et Anthropic.
Cela le rend utile pour tester des quantifications ou ajuster le comportement de génération avant d’y ajouter une autre interface. Il convient moins à un portail familial, car l’administration multi-utilisateur et la gestion des connaissances clé en main ne sont pas ses principaux atouts.
- Idéal pour : les passionnés qui comparent les chargeurs, les formats et les paramètres de génération.
- Choisissez-le lorsque : le contrôle de l’inférence compte davantage qu’une expérience multi-utilisateur soignée.
- À surveiller : exposer une interface puissante de gestion des modèles au-delà du réseau local de confiance.
6. Big-AGI — Le meilleur choix pour comparer plusieurs modèles
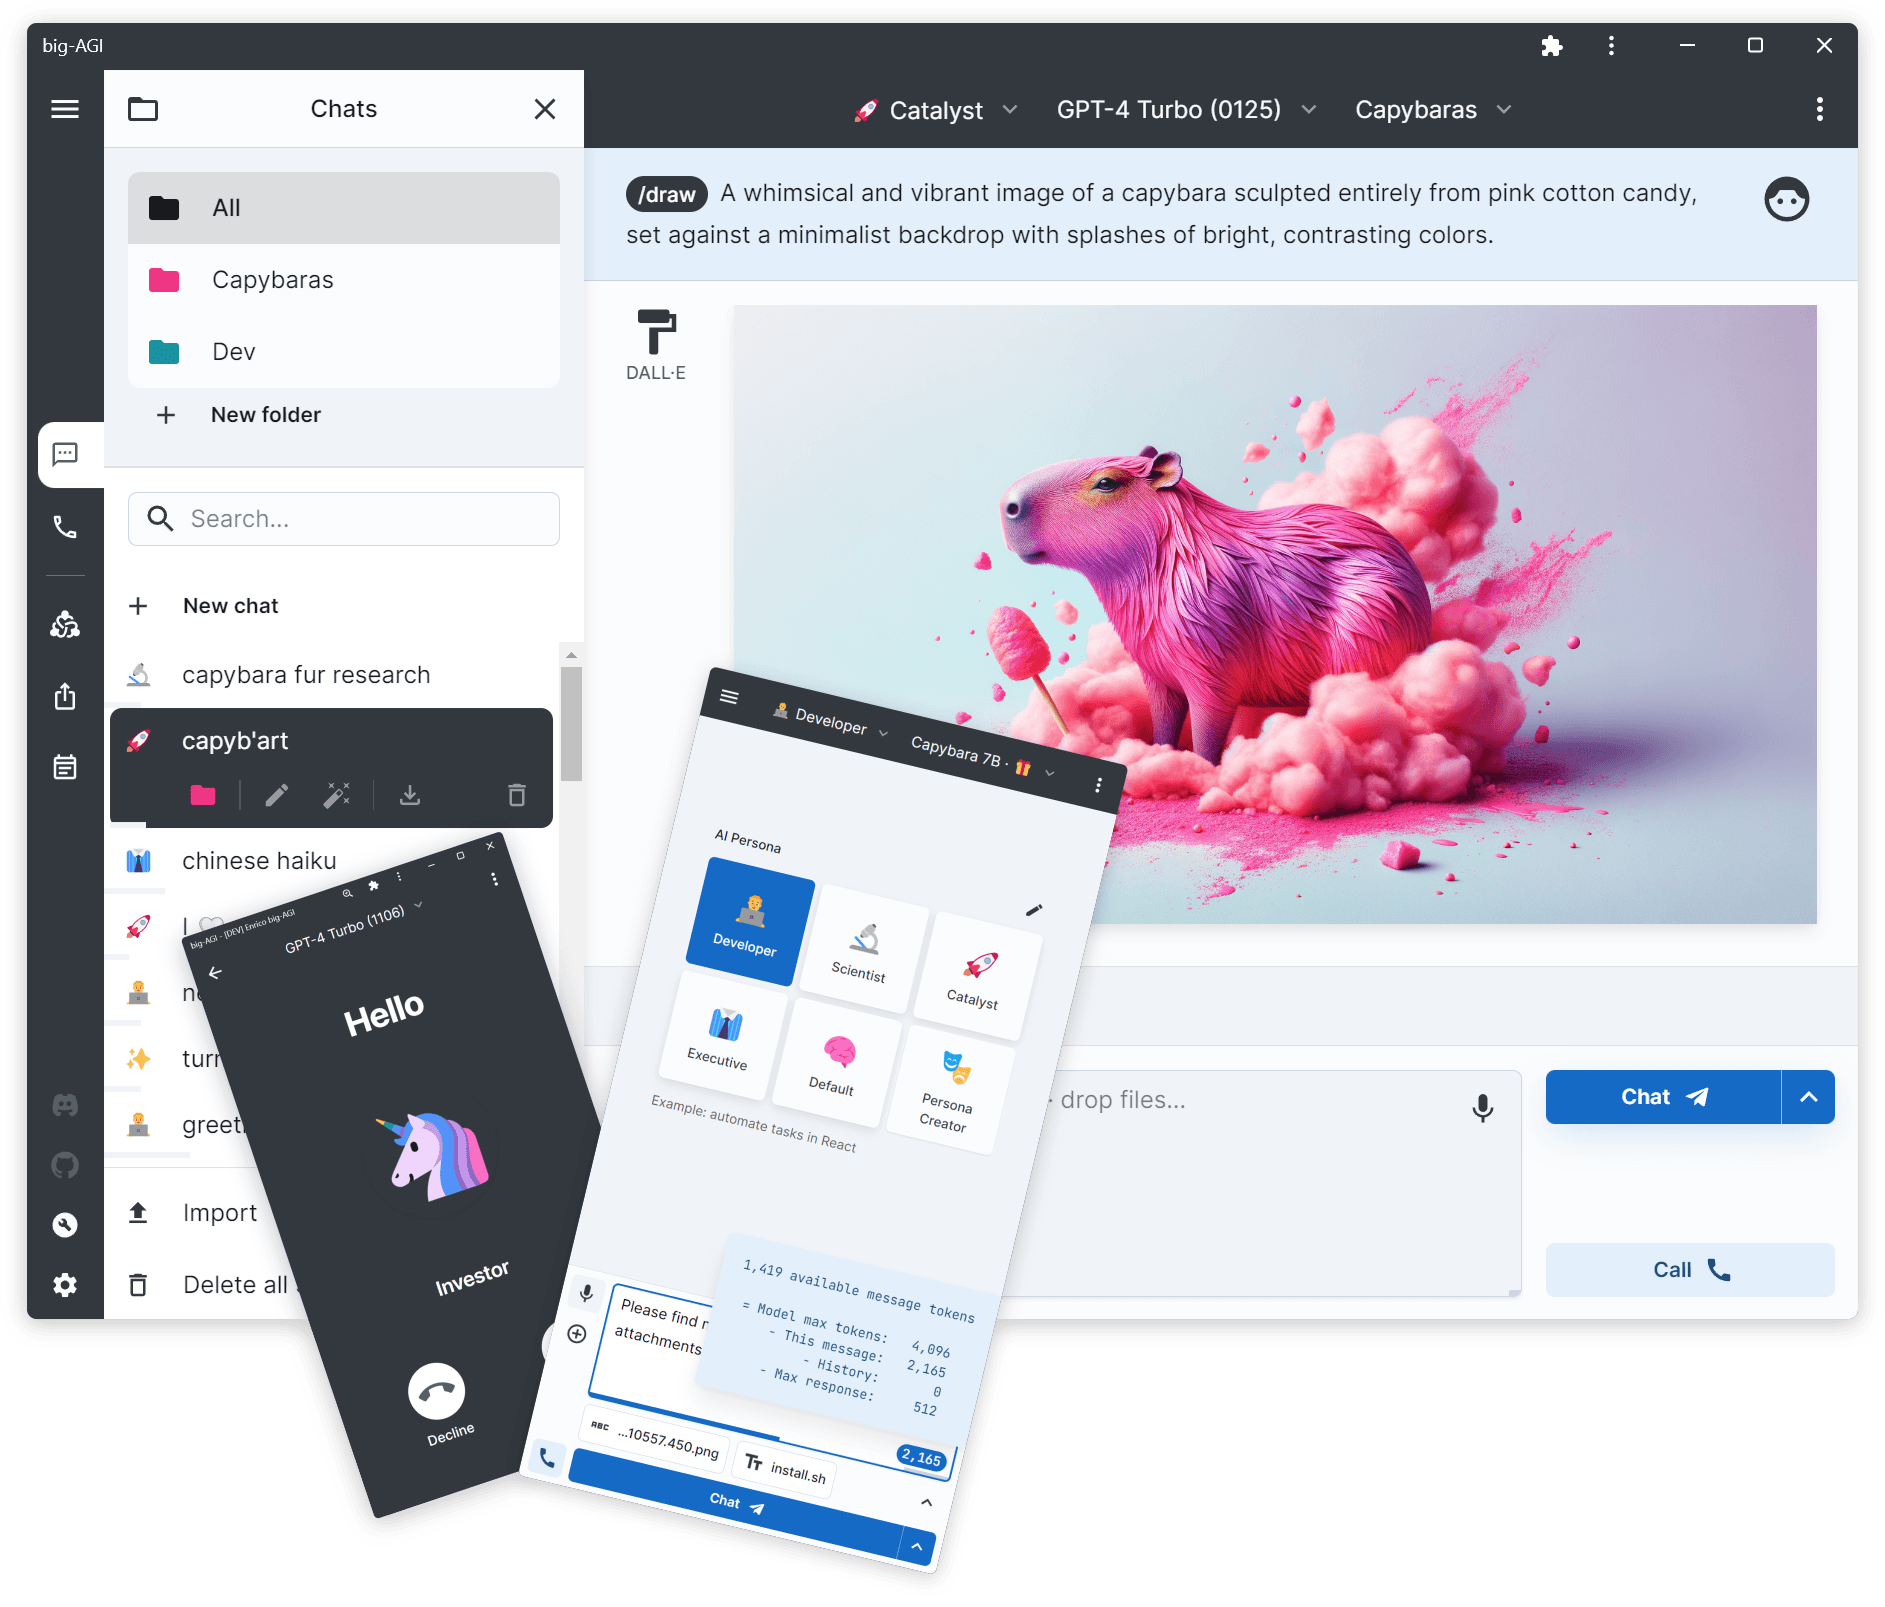
Big-AGI Open est conçu comme un espace de travail multi-modèles plutôt que comme une simple copie d’une interface de conversation dédiée à un seul fournisseur. Il peut se connecter à Ollama, LM Studio, LocalAI et à de nombreux fournisseurs hébergés, permettant aux réponses locales et cloud de coexister dans une interface orientée recherche.
Ses fonctionnalités de comparaison et de synthèse sont utiles si vous souhaitez que plusieurs modèles abordent le même problème. L’édition Open auto-hébergée ne comprend pas de comptes utilisateur natifs ; elle convient donc mieux à un chercheur individuel qu’à un déploiement partagé dans un foyer, sauf si l’accès est géré par un proxy inverse.
- Idéal pour : la recherche, la comparaison de modèles et le travail hybride local-cloud.
- Choisissez-le lorsque : changer de modèle ou les comparer est au cœur du flux de travail.
- À surveiller : les fournisseurs cloud qui interrompent un parcours de données autrement local.
7. NextChat — La meilleure interface d’IA locale légère

NextChat est une interface d’assistant légère, rapide et adaptative, qui peut être déployée avec Docker ou sous forme d’application web. Elle prend en charge les URL de base d’API personnalisées, les modèles déployés par vos soins via des points de terminaison compatibles, les masques de prompt, les réponses en continu, l’utilisation en PWA et la prise en charge facultative de MCP.
C’est un choix intéressant lorsque le serveur domestique doit consacrer ses ressources à l’inférence plutôt qu’à une pile frontend lourde. Son mécanisme de code d’accès est plus simple qu’une gestion complète des identités et des autorisations multi-utilisateurs ; utilisez donc un proxy inverse sécurisé si plusieurs personnes sont concernées ou si l’accès se fait à distance.
- Idéal pour : les conversations légères sur téléphones, tablettes et serveurs anciens.
- Choisissez-le lorsque : la rapidité et la simplicité comptent davantage qu’un RAG intégré.
- À surveiller : considérer un code d’accès partagé comme une protection de sécurité complète.
8. SillyTavern — Le meilleur choix pour les personas et le contrôle des prompts

SillyTavern est une interface de navigateur installée localement, destinée aux utilisateurs qui souhaitent contrôler en détail les personnages, les personas, la construction des prompts, les univers, les paramètres de génération, la synthèse vocale et les connexions à des générateurs d’images. Elle peut se connecter à un large éventail d’API locales de génération de texte.
Bien qu’il soit surtout connu pour le jeu de rôle et l’écriture créative, sa banque de données ajoute aux requêtes des connaissances fondées sur la récupération d’informations. Son interface demande un peu plus d’apprentissage et est principalement conçue pour un usage personnel, mais peu d’alternatives offrent un tel degré de contrôle sur les conversations et les personnages.
- Idéal pour : l’écriture créative, le jeu de rôle, les personnages et les instructions avancées.
- Choisissez-le si : il est essentiel de contrôler la façon dont les requêtes sont assemblées.
- À surveiller : la complexité de la configuration et les extensions tierces.
9. Dify — Idéal pour créer des applications d’IA auto-hébergées
Dify est plus lourd qu’une interface de chat classique, car il s’agit d’une plateforme d’applications d’IA. Elle fournit une orchestration visuelle, des bases de connaissances, des agents, des flux de travail, des extensions, des journaux et des applications Web publiables, compatibles avec des modèles locaux ou distants.
Le déploiement officiel avec Docker Compose lance de nombreux services essentiels et complémentaires. Dify convient donc mieux à un serveur domestique performant qu’à un petit système à carte unique. Choisissez-le si vous voulez concevoir des outils familiaux réutilisables ou des applications internes, et pas simplement remplacer une page de chat.
- Idéal pour : créer, tester et publier des applications d’IA.
- Choisissez-le si : les flux de travail, les pipelines de connaissances et les interfaces réutilisables justifient la complexité supplémentaire.
- À surveiller : le nombre de conteneurs, les sauvegardes de base de données, les mises à niveau et l’utilisation des ressources.
10. Flowise — Meilleure interface visuelle pour les flux de travail d’IA
Flowise est une plateforme visuelle permettant d’assembler des flux de chat, des flux d’agents, des outils, des composants de récupération et des connexions aux modèles. Elle prend en charge les déploiements auto-hébergés et isolés du réseau et peut se connecter à des modèles locaux grâce à des composants comme Ollama.
Flowise figure dans cette liste parce que son éditeur visuel et ses interfaces de chat intégrables sont utiles dans un home lab, mais ce n’est pas le meilleur client de chat polyvalent pour un usage quotidien. Il trouve sa place lorsque l’interface sert à concevoir la logique de l’assistant.
- Idéal pour : le prototypage visuel d’agents et de pipelines RAG.
- Choisissez-le si : vous voulez créer des flux sans développer toute l’application.
- À surveiller : la sécurisation des identifiants, des points de terminaison des flux et des autorisations des outils.
Quelle interface Web d’IA locale choisir ?
- Choisissez Open WebUI pour la meilleure expérience générale en home lab.
- Choisissez LibreChat pour les outils MCP, les agents et une utilisation avancée avec plusieurs fournisseurs.
- Choisissez LobeHub pour un espace de travail personnel soigné.
- Choisissez AnythingLLM si la confidentialité des documents et le RAG sont prioritaires.
- Choisissez text-generation-webui pour contrôler directement le chargement des modèles et l’inférence.
- Choisissez Big-AGI pour comparer des modèles locaux et cloud dans un même espace de travail.
- Choisissez NextChat pour une interface de chat légère.
- Choisissez SillyTavern pour les personnages, les jeux de rôle et l’ingénierie des prompts.
- Choisissez Dify ou Flowise pour créer une application ou un flux de travail d’IA.
Une architecture pratique pour un laboratoire domestique
Une configuration fiable sépare quatre couches : l’interface web, le serveur d’inférence, la couche de données et l’accès à distance. L’interface peut fonctionner dans un petit conteneur Docker, tandis qu’Ollama, llama.cpp ou un autre environnement d’exécution utilise l’hôte équipé d’un GPU. Les documents, fichiers de modèles, bases de données et sauvegardes peuvent rester sur un NAS, tandis qu’un proxy inverse ou un VPN privé contrôle l’accès par navigateur.
Cette séparation facilite les mises à niveau et évite qu’une panne de l’interface affecte les modèles stockés ou les fichiers privés. Elle permet également à un serveur basse consommation de rester en ligne en permanence, tandis qu’une machine équipée d’un GPU ne s’active que pour les inférences exigeantes. La comparaison entre un laboratoire IA compact et un NAS IA complet montre comment répartir ces rôles.
Exécuter une interface web d’IA locale sur du matériel Zima
ZimaBoard 2 est un hôte toujours actif idéal pour les interfaces web légères, les proxys inverses, l’authentification, les petites bases de données et l’orchestration. Il peut se connecter en réseau à Ollama ou à un autre serveur d’inférence équipé d’un GPU dédié. Des modèles légers peuvent fonctionner sur son processeur, mais son rôle principal est de coordonner les services plutôt que de remplacer une station de travail IA haut de gamme.
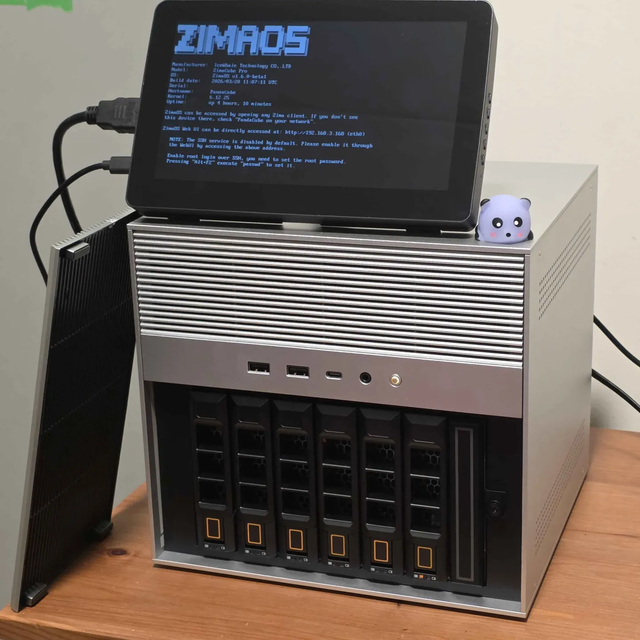
ZimaCube 2 offre un stockage extensible pour les poids des modèles, les bases de connaissances, les fichiers téléversés et les sauvegardes. C’est donc une couche de données idéale pour Open WebUI, AnythingLLM, LibreChat, Dify ou Flowise. Pour un exemple détaillé, découvrez comment un flux de travail NAS IA avec ZimaCube 2 associe le stockage à des fonctions de recherche et d’assistance privées.
Liste de contrôle de sécurité avant d’exposer l’interface utilisateur
- Ne redirigez pas directement le port de l’application vers Internet. Utilisez un VPN ou un proxy inverse avec TLS et une authentification forte.
- Créez des comptes utilisateur distincts lorsque c’est possible. Ne partagez pas une session administrateur au sein du foyer.
- Limitez l’accès aux modèles et aux outils. Ollama, les bases de données, les serveurs MCP et les services d’exécution de code doivent rester sur des réseaux de confiance.
- Conservez et sauvegardez les données de l’application. L’historique des conversations, les bases de données vectorielles, la configuration et les documents téléversés doivent être préservés lors du remplacement d’un conteneur.
- Vérifiez les connexions sortantes. Les modèles cloud, la recherche sur le Web, les fournisseurs de services vocaux, les plugins et la télémétrie peuvent envoyer des données hors de votre laboratoire à domicile.
- Effectuez les mises à jour avec précaution. Épinglez les versions de conteneurs dont la fiabilité est éprouvée, consultez les notes de migration et conservez une sauvegarde permettant de revenir en arrière.
Si vous hésitez entre les conteneurs et une installation directe, le guide comparatif de Docker et des applications d’IA locale installées nativement aborde l’isolation, l’accès au GPU, les mises à niveau et le dépannage.
Foire aux questions
Quelle est la meilleure interface web pour Ollama ?
Open WebUI est le meilleur choix par défaut pour la plupart des utilisateurs d’Ollama, car il offre une connexion simple, la gestion de plusieurs utilisateurs, le RAG, des outils, des pièces jointes et une interface adaptée à un usage quotidien. NextChat est plus léger, tandis que LibreChat est plus performant pour les agents et les intégrations MCP.
Une interface web d’IA locale peut-elle fonctionner sur une autre machine que celle qui héberge le modèle ?
Oui. L’interface web peut fonctionner sur un serveur domestique basse consommation et se connecter via le réseau local à Ollama, vLLM, LocalAI ou à un autre service d’inférence compatible exécuté sur une machine équipée d’un GPU. C’est souvent la configuration la plus efficace pour un laboratoire à domicile.
L’auto-hébergement de l’interface garantit-il la confidentialité ?
Non. La confidentialité dépend de chaque point de terminaison configuré. Une interface locale connectée à un modèle cloud ou à un fournisseur de recherche externe peut tout de même transmettre des prompts et des fichiers. Vérifiez les API des modèles, les embeddings, les outils, les services vocaux, les plugins et les journaux.
Quelle interface convient le mieux pour discuter avec des documents privés ?
AnythingLLM est la solution clé en main la plus spécialisée dans le RAG fondé sur des documents. Open WebUI et LibreChat conviennent mieux si le chat avec des documents n’est qu’une fonctionnalité parmi d’autres, tandis que Dify et Flowise sont adaptés aux pipelines de recherche personnalisés.
Ai-je besoin d’un GPU pour héberger l’interface web ?
Non. L’interface elle-même fonctionne généralement sur le processeur. Le serveur de modèles utilise le GPU et peut se trouver sur la même machine ou sur un autre système. Cette séparation permet à un serveur économe en énergie d’héberger l’interface en continu.
Verdict final
Open WebUI est le meilleur point de départ pour la plupart des laboratoires d’IA à domicile exécutant des modèles locaux, car il allie facilité d’utilisation, compatibilité avec les modèles locaux, RAG, outils et accès multi-utilisateur. Choisissez LibreChat pour les installations axées sur les agents, AnythingLLM pour les documents privés, text-generation-webui pour le contrôle de l’inférence, et Dify ou Flowise pour créer des applications. L’interface idéale est celle qui apporte les fonctionnalités dont vous avez besoin sans transformer un service privé à domicile en plateforme inutilement complexe.

Produits recommandés


Centre technologique et IA
À lire aussi
Verrouillage de version des embeddings : pourquoi les vecteurs de requête et de documents doivent rester compatibles
Une explication des mécanismes du verrouillage des versions d’intégration, de ses compromis en matière de ressources partagées, de trois FAQ sur la répartition des...
Stockage de modèles adressé par le contenu : comment les hachages empêchent les téléchargements de poids en double
Une explication axée sur les mécanismes du stockage de modèles adressé par le contenu, ses compromis en matière de ressources partagées, trois FAQ sur...
Actions de compensation des agents : comment les étapes réversibles limitent les défaillances partielles des flux de travail
Une explication axée sur les mécanismes des actions de compensation des agents, leurs compromis en matière de ressources partagées, trois FAQ sur la diffusion...


