
Liquid AI LFM3 expliqué : un modèle multimodal de 2B peut-il fonctionner en local ?


Oui, LFM3 peut être exécuté localement, mais commencez par choisir le bon checkpoint. Liquid AI a lancé la famille LFM3 à poids ouverts le 27 octobre 2026. Son modèle textuel, LFM3-1.7B, compte 1,73 milliard de paramètres et affiche une empreinte des poids d’environ 1 Go en 4 bits. Une version récente de llama.cpp peut exécuter son checkpoint GGUF sur un processeur local ou un GPU pris en charge. Cela ne signifie pas qu’un assistant complet doté de la parole et de la vision ne consomme que 1 Go.
Pour un PC ou un NAS domestique, le choix pratique consiste à sélectionner texte, vision, audio ou omni avant de dimensionner le matériel. Le fichier du modèle, l’encodeur/décodeur, les tampons du runtime, l’état du contexte, les entrées image ou audio et les requêtes simultanées utilisent tous des ressources. Pour un premier essai, choisissez le modèle textuel en 4 bits, un contexte de 4K à 8K et une seule requête ; mesurez la mémoire et la latence avant d’activer des entrées plus volumineuses ou d’autres services NAS.
| Question sur le déploiement local | Réponse courte |
|---|---|
| Les checkpoints officiels sont-ils disponibles ? | Oui. Liquid AI publie les poids et les fiches des modèles en accès libre. |
| Existe-t-il un seul modèle 2B doté de toutes les fonctionnalités ? | Non. LFM3 est une famille de checkpoints spécialisés partageant un même modèle de base. |
| Un serveur domestique peut-il exécuter l’inférence textuelle ? | Oui, si le modèle GGUF sélectionné et son runtime tiennent dans la RAM disponible. Le fonctionnement avec le processeur seul peut être lent. |
| 1 Go suffit-il pour la RAM totale en fonctionnement ? | Non. Cette valeur décrit l’empreinte des poids du modèle textuel approximative en 4 bits, et non le pic d’utilisation du processus. |
| Un contexte de 256 K est-il réaliste avec 8 Go de RAM ? | Ne le présumez pas. Le contexte, le nombre de requêtes et le backend modifient les besoins réels en mémoire. |
| Peut-il l’héberger ? | Un runtime Linux compatible est une piste plausible, mais cet article ne constitue pas une certification de compatibilité avec ZimaOS. |
Qu’a exactement lancé Liquid AI avec LFM3 ?
LFM3 est une collection de six modèles de classe 2B entraînés à partir du modèle de base LFM3-1.7B-Base : un modèle textuel, un modèle vision-langage, un modèle audio, un modèle omni et deux variantes axées sur la prise de décision. Liquid AI décrit cette famille comme adaptée aux applications spécialisées sur appareil. Le mot important est famille : télécharger LFM3-1.7B n’ajoute pas automatiquement un encodeur d’image, la prise en charge du microphone ou un décodeur vocal. Consultez l’annonce de lancement de LFM3 et la présentation de la famille de modèles.
| Checkpoint officiel | Entrée / sortie principale | Détail publié | Réserve concernant le déploiement local |
|---|---|---|---|
| LFM3-1.7B | Texte vers texte, réponses structurées et outils | 1,73 B de paramètres ; contexte de 256 K | Poids réduits, mais le contexte et la concurrence doivent être dimensionnés séparément. |
| LFM3-VL-2B | Texte, images et vidéo vers texte | 1,92 B au total ; contexte de 128 K | L’encodeur de vision, les tokens d’image et les images vidéo augmentent le coût. |
| LFM3-Audio-2B | Audio/texte vers texte ou parole | Environ 2B ; contexte de 32K ; 18 langues de parole prises en charge | Le frontend audio, le décodeur et la latence sont distincts des poids texte. |
| LFM3-Omni-2B | Entrée multimodale et sortie texte/parole | Parcours partagé pour la vision, l’audio et le texte | Nécessite le checkpoint spécifique à la version omni et un environnement d’exécution compatible. |
| d1-2B / d1-omni-2B | Sorties de décision calibrées | Spécialisé à partir des modèles VL/Omni | Évaluez le modèle pour la tâche de décision visée, et non pour la conversation générale. |
Les poids de LFM3 sont soumis à la licence LFM Open v1.0. « À poids ouverts » est la description exacte : consultez la licence elle-même pour déterminer les conditions de distribution et d’utilisation commerciale prévues, plutôt que de la considérer comme une licence de logiciel libre reconnue par l’OSI. Les fiches des modèles précisent les limites de chacun ; elles indiquent notamment que le modèle texte compact n’est pas recommandé pour les raisonnements complexes en plusieurs étapes ni pour le codage agentique.
Pourquoi l’architecture hybride à trois composants est-elle importante pour les appareils en périphérie ?
Selon la fiche officielle du modèle texte, le backbone texte de 1.73B comporte 24 couches : 13 couches à convolution courte avec mécanisme de gating, cinq couches d’attention à fenêtre glissante et six couches d’attention globale. Le mélange de ces opérations évite de devoir traiter chaque token dans chaque couche comme avec l’attention globale complète, tout en préservant une partie du contexte global. Il s’agit d’un choix de conception visant à réduire la latence et la consommation mémoire, et non d’une exemption au coût des longs prompts.
Liquid AI indique que l’entraînement a porté sur 22 billions de tokens et affirme que le modèle offre une meilleure qualité par paramètre que les précédents modèles LFM. Ces chiffres sont des résultats communiqués par le développeur ; ils ne doivent pas être interprétés comme des résultats de benchmarks indépendants sur NAS domestiques. Les gains architecturaux expliquent en partie pourquoi un modèle d’environ 2B de paramètres peut être utile pour l’extraction, les réponses à des questions simples et le routage vers des outils. Ses capacités dépendent toutefois toujours de la difficulté de la tâche, de la formulation des prompts et de la récupération d’informations externes.

De combien de RAM, de VRAM et de stockage avez-vous réellement besoin ?
Un calcul transparent aide à s’y retrouver : 1.73B × 4 bits / 8 ≈ 0.865 GB de poids bruts théoriques. Les métadonnées de quantification et l’empaquetage des fichiers augmentent ce chiffre, d’où la description par Liquid AI du modèle texte 4 bits comme occupant environ 1 GB. Mais le modèle a toujours besoin d’un état de contexte, de tampons d’exécution, d’allocateurs et de ressources supplémentaires pour l’application. Un système en cours d’exécution peut consommer bien plus que la taille du fichier.
Ces configurations prudentes sont proposées pour des essais ; elles ne constituent ni des exigences minimales officielles des modèles ni des objectifs garantis de tokens par seconde. Elles supposent un seul point de contrôle texte quantifié sur 4 bits, aucune charge de travail simultanée importante et un espace de stockage libre suffisant.
| Catégorie d’hôte | Premier test raisonnable | Limitation principale |
|---|---|---|
| 8 Go de RAM, CPU uniquement | GGUF texte ; contexte de 4K ; un utilisateur | Latence du CPU et concurrence avec les services NAS. |
| 16 Go de RAM, CPU ou accélérateur pris en charge | Commencez par le texte, puis faites des tests VL modestes | Le prétraitement multimodal et les contextes plus longs nécessitent des mesures. |
| Au moins 32 Go de RAM avec un GPU adapté | Explorez des pipelines VL/audio plus ambitieux | Pilote, backend, compatibilité du projecteur/décodeur et mémoire de pointe. |
| ZimaCube 2 ou un autre NAS partagé | Stockez les points de contrôle et les données de projet sur un espace de stockage dédié ; dimensionnez séparément l’inférence | La capacité du disque ne peut pas remplacer la RAM, la mémoire GPU ou la bande passante mémoire. |
Un contexte annoncé de 256K est une limite prise en charge par le modèle, pas un réglage de départ recommandé. Pendant le traitement de prompts volumineux et de sessions simultanées, l’environnement d’exécution peut mobiliser beaucoup plus de ressources. Consultez le guide ZimaSpace sur les besoins en RAM et en GPU des modèles locaux et l’explication du routage des modèles selon leur empreinte mémoire totale pour planifier en fonction des ressources réellement utilisées, et pas seulement du nombre de paramètres.
Quel modèle LFM3 choisir pour un NAS domestique ?
Pour le chat textuel local, l’étiquetage, l’extraction et le routage léger vers des outils, LFM3-1.7B est le test le plus simple. Pour les documents numérisés, les images fixes prises par caméra ou l’inspection visuelle, choisissez LFM3-VL-2B ; sa fiche de modèle indique un encodeur de vision de 164 M de paramètres et un projecteur de 25 M, en plus du modèle de langage de base. La fiche officielle du modèle de vision précise également l’échantillonnage vidéo et les limites de nombre d’images. Traiter une vidéo coûte plus cher que lire un court prompt en texte brut.
Pour les interactions vocales, LFM3-Audio-2B est un système spécialement conçu pour l’audio, et non une mise à niveau gratuite du GGUF texte. Il prend en charge la parole multilingue, la transcription et les réponses vocales, tandis que les performances en streaming dépendent de l’appareil. Choisissez LFM3-Omni-2B uniquement si le flux de travail combine réellement plusieurs modalités et que le backend utilisé prend précisément en charge cette combinaison. Un seul GPU hébergeant des pipelines de chat, de vision et d’audio doit disposer de suffisamment de mémoire pour les pics d’utilisation simultanée, comme l’explique notre guide sur les tâches multimodales exécutées sur un GPU domestique.
Comment exécuter LFM3-1.7B en local avec llama.cpp ?
Pour la partie environnement d’exécution de cette configuration, consultez notre guide de déploiement de llama.cpp 0.8.0, qui explique notamment la différence entre l’inférence de texte et la voix en temps réel expérimentale.
Pour une première vérification reproductible, commencez par le dépôt GGUF publié et utilisez llama.cpp v0.8.0 ou une version plus récente compatible avec LFM3. L’exemple utilise la variante officielle Q4_K_M et relie le serveur à l’interface de bouclage ; il n’expose pas d’API de modèle à Internet. Sur un hôte Linux disposant de Git, CMake et d’un compilateur compatible :
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout v0.8.0
cmake -S . -B build
cmake --build build --config Release -j --target llama-server
./build/bin/llama-server \
  -hf LiquidAI/LFM3-1.7B-GGUF:Q4_K_M \
  -c 4096 --host 127.0.0.1 --port 8080
Ouvrez http://127.0.0.1:8080 sur cette même machine, ou testez le serveur depuis son terminal :
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"local","messages":[{"role":"user","content":"Explique la quantification en trois phrases."}],"max_tokens":128}'
L’identifiant exact du modèle dans l’API compatible avec OpenAI peut varier selon la configuration du serveur. Si votre version rejette "local", interrogez d’abord /v1/models et utilisez l’ID renvoyé. Compiler le backend CPU par défaut constitue un bon point de départ ; l’accélération GPU nécessite de sélectionner et de tester un backend adapté. La fiche GGUF officielle propose d’autres options d’exécution, notamment Ollama et LM Studio. Considérez-les comme des environnements d’exécution alternatifs, et non comme la preuve que chaque paquet ZimaOS inclut déjà cette version exacte du modèle.
Pour tester la vision ultérieurement, utilisez le checkpoint GGUF LFM3-VL documenté et suivez le guide de démarrage rapide officiel pour la vision afin de charger le projecteur de vision correspondant. Ne remplacez pas le nom du modèle de texte dans une commande au hasard en supposant que l’entrée d’images fonctionnera.
Que faut-il vérifier avant de considérer le déploiement comme réussi ?
- Identité du modèle : vérifiez la variante GGUF sélectionnée et la version de l’environnement d’exécution, et pas seulement que le téléchargement est terminé.
- Plafond de ressources : relevez la RAM et la VRAM utilisées au repos, pendant le préremplissage et avec une invite plus longue ; vérifiez que ZimaOS et les autres applications du NAS disposent toujours d’une marge suffisante.
- Latence et qualité : évaluez le traitement des invites, le nombre de jetons générés par seconde, le respect des instructions et l’exactitude sur cinq tâches représentatives.
- Limites de confidentialité : gardez toute API locale sur l’interface loopback ou un réseau privé de confiance ; authentifiez et faites transiter l’accès par un proxy de manière délibérée si d’autres clients doivent y accéder.
- Persistance : stockez les fichiers de modèles téléchargés ailleurs que sur la partition de démarrage et séparez clairement les poids immuables de l’état modifiable de l’application. Consultez la page sur la séparation des fichiers de modèles et de l’état d’exécution ainsi que notre guide de déploiement sécurisé d’un LLM local.
Si un déploiement fonctionne sur un ordinateur de bureau, mais échoue sur un NAS, examinez toute la chaîne : taille du modèle quantifié, montage de volume correct, RAM disponible, choix du backend, compatibilité des instructions du processeur, projecteurs et longueur du contexte. La liste de vérification du stockage des modèles est un complément utile.
FAQ
LFM3 est-il entièrement open source ?
Liquid AI publie des poids ouverts sous la licence LFM Open License v1.0. Cela ne signifie pas automatiquement que ses modèles et ses composants d’entraînement répondent à toutes les définitions des logiciels open source ; lisez la licence avant de redistribuer un déploiement ou d’en tirer des revenus.
Puis-je exécuter LFM3 sur un PC ou un NAS sans GPU ?
Le petit modèle texte GGUF peut fonctionner via un backend CPU compatible de llama.cpp, si le système d’exploitation et la mémoire RAM disponible le permettent. Son caractère interactif dépend des performances du processeur, de la bande passante mémoire et de la longueur de l’invite. Considérez 8 Go comme un palier pratique pour les tests, et non comme un minimum officiel.
LFM3-1.7B prend-il en charge les images ou la parole en entrée ?
Pas à lui seul. Utilisez LFM3-VL pour les images et les vidéos, LFM3-Audio pour la parole, ou LFM3-Omni lorsque plusieurs modalités sont nécessaires. Chacun possède des points de contrôle et des dépendances d’exécution différents.
Un modèle quantifié sur 4 bits de 1 Go nécessite-t-il seulement 1 Go de RAM ?
Non. Ce chiffre correspond approximativement aux poids du modèle de texte quantifié. Le processus d’inférence utilise en plus de la mémoire d’état, des tampons d’exécution, des caches de jetons et des ressources du système d’exploitation. Les contextes longs et les utilisations simultanées peuvent faire une grande différence.
Le contexte de 256K est-il disponible pour chaque modèle LFM3 ?
Non. Le modèle de texte annonce une fenêtre de contexte de 256K ; celle du modèle de vision est de 128K et celle du modèle audio de 32K. Même une longueur maximale prise en charge ne garantit pas qu’un appareil de 8 Go donné puisse la gérer confortablement.
ZimaCube 2 ou ZimaOS peuvent-ils exécuter LFM3 aujourd’hui ?
Une pile d’inférence locale est techniquement envisageable si le matériel, le modèle et l’environnement d’exécution choisis sont compatibles. ZimaCube 2 convient aussi au stockage privé de modèles, de documents et de services applicatifs. Les vérifications ci-dessus ne signifient pas qu’une installation de LFM3 sur ZimaOS a été certifiée de façon indépendante ou que son débit a été mesuré.
En conclusion
LFM3 rend l’IA embarquée spécialisée de petite taille plus accessible, mais le choix du point de contrôle compte davantage que l’appellation accrocheuse « multimodal 2B ». Pour un serveur domestique, le premier choix le plus évident est le modèle de texte LFM3-1.7B quantifié sur 4 bits, avec un contexte court et une charge de travail maîtrisée. N’ajoutez la vision et la parole que si le point de contrôle concerné, la prise en charge par l’environnement d’exécution et la mémoire mesurée le justifient.
Pour une configuration ZimaSpace, considérez le stockage, l’inférence et l’accès aux applications comme des décisions distinctes. Un NAS domestique peut stocker les fichiers de modèles, protéger les documents personnels et coordonner des flux de travail locaux, même si une machine plus puissante exécute le modèle. Si votre intérêt se porte sur des systèmes à poids ouverts beaucoup plus volumineux, l’analyse du matériel requis pour exécuter Kimi K3 localement montre à quel point les besoins en mémoire évoluent avec le nombre de paramètres.
Sources et périmètre
Sources officielles consultées le 29 octobre 2026 : article de lancement de Liquid AI, présentation de la famille, fiche du modèle de texte, fiche du modèle de vision, fiche du modèle audio et version v0.8.0 de llama.cpp. Les performances annoncées sont attribuées aux développeurs ; les niveaux matériels et recommandations d’utilisation présentés ici sont des estimations éditoriales, et non des résultats de tests de référence ZimaSpace.
Image de couverture : Liquid AI, vignette vidéo officielle du lancement de LFM3.

Produits recommandés

Centre technologique et IA
À lire aussi
llama.cpp 0.8.0 : nouveaux modèles, voix en temps réel et fonctionnalités d’IA locale
llama.cpp 0.8.0 prend en charge LFM3 et d’autres architectures de modèles, propose des API audio en temps réel expérimentales, la synthèse vocale ainsi que...
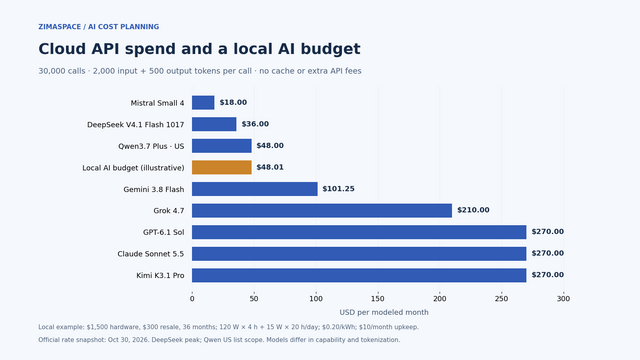
Tarifs des API d’IA cloud par rapport à l’IA locale : combien votre charge de travail vous coûte-t-elle vraiment ?
Comparez les coûts des jetons d’API cloud à ceux du matériel d’IA local, de l’électricité et de l’entretien. Passez en revue un exemple mensuel...

Le problème du secret initial : pourquoi un agent IA domestique a encore besoin d’une racine de confiance initiale
Une explication du problème du secret zéro axée sur son mécanisme, de ses compromis liés aux ressources partagées, de trois FAQ sur la diffusion...


