
Jakie czynniki powodują przesunięcie zakresów cytatów po konwersji dokumentu?


Niezawodne ustalanie rozbieżności w zakresach cytowań po konwersji dokumentu wymaga jawnego stanu, mierzalnych mechanizmów kontrolnych i obsługi odzyskiwania, a praktyczne ograniczenia wyznaczają zgodność i polityka.
W zastosowaniach serwera domowego rozbieżności w zakresach cytowań po konwersji dokumentu mogą wpływać zarówno na interaktywne działanie, jak i wykorzystanie zasobów w tle. Widoczny efekt pojawia się dopiero po przejściu żądania przez kilka etapów przetwarzania, więc jedna średnia wartość może ukryć, gdzie zaczęły się opóźnienie, utrata jakości lub awaria. Oddzielenie transportu, obliczeń, pamięci masowej i stanu aplikacji pozwala sprawdzić tę zależność przy niezmienionych pozostałych warunkach.
Jak rozbieżności w zakresach cytowań po konwersji dokumentu docierają do warstwy widocznej dla użytkownika
Efekt widoczny dla użytkownika jest następstwem tego warunku: trafienia można ocenić pod kątem tego, czy dokładnie potwierdzają dane twierdzenie, zanim zostanie złożony końcowy kontekst. Ten etap zmienia to, co otrzymuje następny komponent, więc zaobserwowanego wyniku nie można przypisać wyłącznie końcowemu interfejsowi lub modelowi. Utrzymanie stałych danych wejściowych i obciążenia pozwala dostrzec tę wczesną transformację.
Model generowania wspomaganego wyszukiwaniem daje konkretny sposób interpretacji tego etapu: trafienia można ocenić pod kątem tego, czy dokładnie potwierdzają dane twierdzenie, zanim zostanie złożony końcowy kontekst. Jego praktyczna wartość polega na oddzieleniu zmiennej, która uległa zmianie, od późniejszych efektów buforowania, planowania zadań, pamięci masowej lub renderowania, które mogą wywołać podobne objawy.
Gdy zmieni się pierwszy etap, wyrównywanie zakresów odrzuca obszerne fragmenty, których wysoki wynik wyszukiwania maskuje słabe dowody. W zależności od tematu artykułu konsekwencją mogą być opóźnienia, dokładność, zużycie energii, pojemność lub postrzegana płynność, ale ścieżka przyczynowa nadal zaczyna się przed wyświetleniem końcowego wyniku.
Powiązania między zasobami stojące za wynikiem
Powiązania między zasobami mają znaczenie, ponieważ wyrównywanie zakresów odrzuca obszerne fragmenty, których wysoki wynik wyszukiwania maskuje słabe dowody. Równoczesne zadania związane ze sztuczną inteligencją, pamięcią masową, multimediami lub automatyzacją mogą więc potęgować efekt, który w benchmarku z pojedynczym żądaniem wydaje się niewielki. Zachowanie w ogonie rozkładu ma większe znaczenie niż średnia dla bezczynnego systemu.
Mechanizm oceny wyszukiwania łączy warstwę współdzielonych zasobów z wynikiem: wyrównywanie zakresów odrzuca obszerne fragmenty, których wysoki wynik wyszukiwania maskuje słabe dowody. Oddzielny pomiar tej warstwy zapobiega myleniu przepustowości, trafień w pamięci podręcznej, potwierdzeń odbioru lub optymistycznych aktualizacji statusu z ukończoną pracą widoczną dla użytkownika.
Interakcja jest kontynuowana, ponieważ konwersja i dzielenie na fragmenty mogą przesuwać przesunięcia lub rozdzielać zdanie stanowiące uzasadnienie. Dlatego dwa serwery domowe z takim samym głównym sprzętem lub przepustowością sieci mogą działać odmiennie, gdy różnią się głębokością kolejki, układem danych, stanem pamięci podręcznej lub polityką.
Przypadki, w których rozbieżności w zakresach cytowań po konwersji dokumentu nie są rozstrzygające
Deklarowany efekt nie ma uniwersalnego zastosowania. W tym przypadku aplikacja nie udostępnia cytowań ani twierdzeń opartych na dowodach. Inne wąskie gardło może wyznaczyć górny limit, zanim zmiana dotycząca dryfu zakresów cytowań po konwersji dokumentu stanie się mierzalna.
Zależność od jakości wyszukiwania pomaga odróżnić oczekiwany mechanizm od konkurencyjnego wyjaśnienia. Kontrolowany test musi utrzymywać stałe dane źródłowe, sprzęt, współbieżność, stan pamięci podręcznej i wersje oprogramowania, zmieniając wyłącznie zmienną wskazaną w tytule. Ta zależność powinna być widoczna w powtarzalnym teście na serwerze domowym.
Granica awarii zostaje osiągnięta, gdy aplikacja nie udostępnia cytowań ani twierdzeń opartych na dowodach. Po jej przekroczeniu bardziej agresywne dostrajanie może zwiększyć koszty, ryzyko lub niestabilność bez poprawy rezultatu obiecanego w tytule.

FAQ dotyczące dryfu zakresów cytowań po konwersji dokumentu
Czy dryf zakresów cytowań po konwersji dokumentu jest głównym wąskim gardłem?
Nie automatycznie. To główne wąskie gardło tylko wtedy, gdy jego zmiana wpływa na wynik, a wyrównanie zakresów usuwa obszerne fragmenty, których wysoki wynik pobierania ukrywa słabe dowody, przy niezmienionych pozostałych warunkach. Jeśli wynik nie reaguje, górny limit wyznacza inny etap.
Czy buforowanie może ukryć efekt dryfu zakresów cytowań po konwersji dokumentu?
Tak. Rozgrzane pamięci podręczne, zachowane sesje, modele rezydujące w pamięci, buforowane multimedia i optymistyczne aktualizacje interfejsu mogą ominąć badany etap. Wyniki prób na zimno i na ciepło należy podawać osobno. Wynik trzeba oceniać niezależnie od sąsiednich etapów potoku.
Która miara dryfu zakresów cytowań po konwersji dokumentu ma największe znaczenie?
Przydatne pomiary to precyzja zakresów, współczynnik potwierdzenia, dryf przesunięć i pokrycie odpowiedzi. Średnie wartości należy zestawiać z opóźnieniem w ogonie rozkładu, błędami, jakością lub kosztem zasobów, aby wynik, który wygląda na płynniejszy, nie został błędnie uznany za lepszy system.
Przeprowadź kontrolowany test dryfu zakresów cytowań po konwersji dokumentu
Przygotuj reprezentatywne obciążenie i przed zmianą dryfu zakresów cytowań po konwersji dokumentu zapisz precyzję zakresów, współczynnik potwierdzenia, dryf przesunięć oraz pokrycie odpowiedzi. Przeprowadź próby na zimno i na ciepło, uwzględnij realistyczną współbieżność i zachowaj te same dane, wersje, sprzęt oraz kryterium sukcesu widoczne dla użytkownika we wszystkich porównaniach.
Wykorzystaj powiązany mechanizm w dryfie zakresów cytowań po konwersji dokumentu, aby przed testem określić oczekiwany kierunek. Zmieniaj jedną zmienną naraz, zapisuj medianę i wartości skrajne, a nieudany lub pogorszony przypadek zachowaj, aby wynik uwzględniał granice operacyjne.
Wprowadź zmianę tylko wtedy, gdy zmierzona korzyść utrzymuje się w kolejnych próbach, a określona granica pozostaje akceptowalna. Jeśli dominuje inny etap, pozostaw bez zmian dryf zakresów cytowań po konwersji dokumentu i przetestuj to konkurencyjne wąskie gardło zamiast wnioskować o związku przyczynowym na podstawie korelacji.

Polecane produkty

Centrum technologii i AI
Więcej do przeczytania
Ataki ransomware na NAS-y Synology: C3RB3R, luki w zabezpieczeniach DSM i potwierdzone informacje
Przeanalizuj doniesienia z 2026 roku o ransomware atakującym urządzenia Synology NAS, sprzeczne twierdzenia o wektorze wejścia C3RB3R, zalecenia dotyczące DSM, luki w aktualizacjach oraz...
Jakie komponenty umożliwiają bezpieczne transakcyjnie przepływy pracy z narzędziami?
Wyjaśnienie przepływów pracy z narzędziami, które zapewniają bezpieczeństwo transakcji, skupiające się na mechanizmach, związanych z nimi kompromisach przy współdzielonych zasobach, trzech często zadawanych pytaniach...
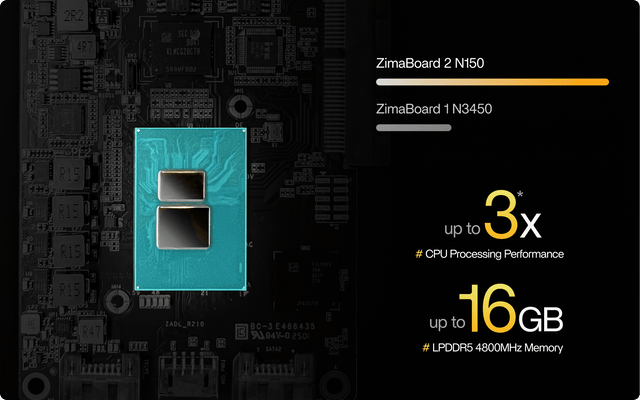
Jakie funkcje umożliwiają deterministyczne odtwarzanie działania samodzielnie hostowanego agenta AI?
Wyjaśnienie deterministycznego odtwarzania działania samodzielnie hostowanego agenta AI, skupiające się na mechanizmie, kompromisach związanych ze współdzielonymi zasobami, trzech odpowiedziach na często zadawane pytania o...


