
Katalogi punktów przywracania: jak manifesty zależności odtwarzają prywatny stos AI


Obserwowalny efekt zwykle pojawia się dlatego, że wpisy katalogu wiążą wersje modelu, indeksu, metadanych, konfiguracji i sekretów, a współdzielone zasoby i czas działania decydują o jego praktycznej skali.
W środowisku domowego serwera katalogi punktów przywracania mogą wpływać zarówno na interakcję z systemem, jak i na wykorzystanie zasobów w tle. Widoczny efekt pojawia się dopiero po przejściu żądania przez kilka etapów przetwarzania, dlatego jedna wartość średnia może ukryć, gdzie zaczęły się opóźnienie, spadek jakości lub awaria. Rozdzielenie transportu, mocy obliczeniowej, pamięci masowej i stanu aplikacji pozwala sprawdzić tę zależność w identycznych warunkach.
Jak katalogi punktów przywracania wpływają na warstwę widoczną dla użytkownika
Efekt widoczny dla użytkownika pojawia się w dalszej części procesu: wpisy katalogu wiążą wersje modelu, indeksu, metadanych, konfiguracji i sekretów. Ten etap zmienia to, co otrzymuje kolejny komponent, więc obserwowanego wyniku nie można przypisać wyłącznie interfejsowi końcowemu lub modelowi. Utrzymanie stałych danych wejściowych i obciążenia pozwala dostrzec tę wczesną transformację.
Model wykrywania MTU ścieżki daje konkretny sposób interpretacji tego etapu: wpisy katalogu wiążą wersje modelu, indeksu, metadanych, konfiguracji i sekretów. W praktyce pozwala oddzielić zmienną, która uległa zmianie, od późniejszych efektów buforowania, planowania zadań, pamięci masowej lub renderowania, które mogą dawać podobne objawy.
Gdy zmieni się pierwszy etap, manifesty zależności wybierają zgodne artefakty podczas odtwarzania. Skutek może objawić się opóźnieniem, dokładnością, zużyciem energii, pojemnością lub płynnością działania — zależnie od tematu artykułu — ale związek przyczynowy nadal zaczyna się przed wyświetleniem wyniku końcowego.
Powiązania między zasobami stojące za wynikiem
Powiązania między zasobami mają znaczenie, ponieważ manifesty zależności wybierają zgodne artefakty podczas odtwarzania. Jednoczesne zadania AI, pamięci masowej, multimediów lub automatyzacji mogą więc nasilić efekt, który w teście porównawczym z pojedynczym żądaniem wydaje się niewielki. Zachowanie w skrajnych przypadkach ma większe znaczenie niż średnia przy bezczynności systemu.
Mechanizm wykrywania rozmiaru pakietu łączy warstwę współdzielonych zasobów z wynikiem: manifesty zależności wybierają zgodne artefakty podczas odtwarzania. Osobny pomiar tej warstwy zapobiega myleniu przepustowości, trafień w pamięci podręcznej, potwierdzeń lub optymistycznych aktualizacji statusu z ukończeniem pracy widocznym dla użytkownika.
Interakcja jest kontynuowana, ponieważ poprawność katalogu zależy od przetestowania wskazanych obiektów przed awarią. Dlatego dwa serwery domowe z tym samym deklarowanym sprzętem lub przepustowością sieci mogą działać inaczej, gdy różnią się głębokością kolejki, układem danych, stanem pamięci podręcznej lub zasadami działania.
Przypadki, w których katalog punktów przywracania nie jest rozstrzygający
Deklarowany efekt nie występuje w każdych warunkach. W tym przypadku cały stos jest odtwarzany ze źródła bez ograniczeń dotyczących czasu odzyskiwania. Inne wąskie gardło może wyznaczyć limit, zanim zmiana w katalogach punktów przywracania stanie się mierzalna.
Powiązanie z przetwarzaniem komunikatów DNS pomaga odróżnić oczekiwany mechanizm od konkurencyjnego wyjaśnienia. W kontrolowanym teście dane źródłowe, sprzęt, współbieżność, stan pamięci podręcznej i wersje oprogramowania muszą pozostać niezmienione; zmieniać należy wyłącznie zmienną z tytułu.
Granica awarii zostaje osiągnięta, gdy cały stos jest odtwarzany ze źródła bez ograniczeń dotyczących czasu odzyskiwania. Po jej przekroczeniu bardziej agresywne strojenie może zwiększać koszt, ryzyko lub niestabilność, nie poprawiając rezultatu obiecanego w tytule.

Często zadawane pytania o katalogi punktów przywracania
Czy katalogi punktów przywracania są głównym wąskim gardłem?
Niekoniecznie. To główne wąskie gardło tylko wtedy, gdy jego zmiana wpływa na wynik, a manifesty zależności wybierają zgodne artefakty podczas ponownej kompilacji, przy niezmienionych pozostałych warunkach. Jeśli wynik nie reaguje, limit wyznacza inny etap.
Czy buforowanie może maskować wpływ katalogów punktów przywracania?
Tak. Ciepłe pamięci podręczne, utrzymane sesje, modele rezydujące w pamięci, buforowane multimedia i optymistyczne aktualizacje interfejsu mogą ominąć badany etap. Wyniki prób na zimno i na ciepło należy raportować osobno. Ta zależność powinna być widoczna w powtarzalnym teście serwera domowego.
Która metryka katalogów punktów przywracania ma największe znaczenie?
Przydatne pomiary to pokrycie katalogów, brakujące obiekty, RPO i RTO. Średnie wartości należy zestawiać z opóźnieniami skrajnymi, błędami, jakością lub kosztem zasobów, aby nie uznać wyniku, który tylko wygląda na równiejszy, za lepszy dla systemu. Wynik należy ocenić niezależnie od sąsiednich etapów potoku.
Przeprowadź kontrolowany test katalogów punktów przywracania
Przed wprowadzeniem zmian w katalogach punktów przywracania przygotuj reprezentatywne obciążenie i zapisz pokrycie katalogów, brakujące obiekty, RPO i RTO. Przeprowadź próby na zimno i na ciepło, uwzględnij realistyczną współbieżność i zachowaj te same dane, wersje, sprzęt oraz kryterium sukcesu widoczne dla użytkownika we wszystkich porównaniach.
Przed testowaniem wykorzystaj powiązany mechanizm w katalogach punktów przywracania, aby określić oczekiwany kierunek zmian. Zmieniaj jedną zmienną naraz, zapisuj medianę i wartości skrajne, a nieudaną lub gorszą próbę zachowaj, aby wynik uwzględniał granice operacyjne.
Zastosuj zmianę tylko wtedy, gdy zmierzona korzyść utrzymuje się w kolejnych próbach, a określona granica pozostaje akceptowalna. Jeśli dominuje inny etap, pozostaw katalogi punktów przywracania bez zmian i przetestuj ten konkurencyjny wąskie gardło, zamiast wyciągać wnioski o przyczynowości na podstawie korelacji.

Polecane produkty

Centrum technologii i AI
Więcej do przeczytania
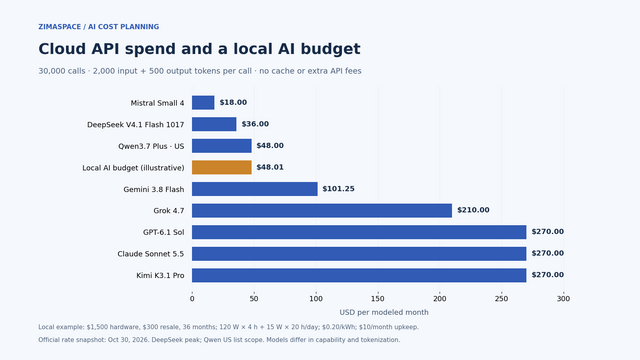
Cloud AI API Pricing vs Local AI: What Does Your Workload Really Cost?
Compare cloud API token charges with local AI hardware, electricity and upkeep. Work through a monthly example and use the free ZimaSpace cost calculator.

Problem tajemnicy zero: dlaczego domowy agent AI nadal potrzebuje początkowego korzenia zaufania
Wyjaśnienie problemu sekretu zerowego, skoncentrowane na mechanizmie, kompromisów związanych ze współdzielonymi zasobami, odpowiedzi na trzy często zadawane pytania dotyczące rozsyłania zapytań oraz praktyczny protokół...
Federacja tożsamości obciążeń: jak usługi lokalne unikają współdzielonych kluczy API
Wyjaśnienie federacji tożsamości obciążeń oparte na mechanizmach, kompromisów związanych ze współdzielonymi zasobami, odpowiedzi na trzy często zadawane pytania dotyczące rozsyłania zapytań oraz praktyczny protokół...


