
Wyjaśnienie modelu Laya: otwartoźródłowy model decyzyjny, który możesz uruchomić lokalnie


Laya nie jest kolejnym małym modelem językowym, który próbuje stać się tańszym ChatGPT. Nie generuje akapitów token po tokenie. Zamiast tego przyjmuje stan - taki jak wiadomość e-mail, zgłoszenie do działu wsparcia, ślad działania agenta lub obiekt JSON - i zwraca ustrukturyzowane decyzje wraz z prawdopodobieństwami.
Dzięki temu Laya należy do tej samej rozwijającej się kategorii co Jev firmy TypeSafe, ale różni się od niego pod jednym zasadniczym względem: wagi Laya są dostępne na licencji Apache 2.0, a model może działać całkowicie na lokalnym sprzęcie. W przypadku lokalnej AI sprawia to, że Laya jest ciekawsza niż kolejny szybki klasyfikator. Rodzi to szersze pytanie: czy powtarzalne decyzje AI w ogóle powinny być przekazywane modelowi frontierowemu?
Czym jest Laya?
Laya to otwartowagowy, nieautoregresyjny model decyzyjny opracowany przez Convai Innovations.
Główny angielski checkpoint wykorzystuje ModernBERT-large jako bazę i zawiera około 421 mln parametrów. Zamiast generować dowolny język, aplikacja przekazuje stan oraz jedno lub więcej typowanych pytań.
| Typ decyzji | Co zwraca Laya | Przykład |
|---|---|---|
wybór |
Prawdopodobieństwo dla zdefiniowanych opcji | rozliczenia / wsparcie / sprzedaż |
wynik |
Oczekiwana wartość w uporządkowanej skali | pilność w skali 0–4 |
nowe |
P(prawda) | Czy ta wiadomość e-mail to phishing? |
Jeśli ten interfejs brzmi znajomo, to dlatego, że Jev wykorzystuje podobny model typowanych decyzji. Nasz wcześniejszy przewodnik po modelach decyzyjnych dla agentów AI wyjaśnia, dlaczego ta kategoria modeli w ogóle zyskuje na znaczeniu.
Laya jest lepiej rozumiana jako wyuczony silnik decyzyjny
Model generatywny może otrzymać:
„Przeczytaj to zgłoszenie do działu wsparcia i wyjaśnij, czego chce klient.”
Laya została zaprojektowana do węższych pytań:
- Do którego działu należy to skierować?
- Czy to pilne?
- Czy to wygląda jak phishing?
- Czy inny model powinien to sprawdzić?
| Model generatywny | Laya |
|---|---|
| Tworzy dowolną odpowiedź | Wybiera spośród zdefiniowanych wyników |
| Generuje tokeny sekwencyjnie | Bezpośrednio ocenia opcje |
| Przydatne do pisania i rozumowania | Przydatne do routingu i klasyfikacji |
| Długość wyjścia wpływa na opóźnienia | Brak długiej sekwencji wyjściowej |
Najważniejsze rozróżnienie nie dotyczy „inteligentnego modelu kontra prosty model”. Chodzi o to, czy aplikacja rzeczywiście potrzebuje generowania języka.
Jeśli oprogramowanie musi tylko wiedzieć, czy chodzi o rozliczenia, kwestie techniczne czy sprzedaż, generowanie akapitu i ponowne analizowanie go w celu uzyskania wartości enum jest zbędną pracą.
Jak Laya podejmuje decyzje bez generowania tekstu?
Zgodnie z oficjalną dokumentacją architektury Laya łączy koder ModernBERT-large z około 395 mln parametrów z dwuwarstwową głowicą decyzyjną, ocenianiem znaczników opcji oraz komponentem działania/escalacji.
Ponieważ ModernBERT jest dwukierunkowy, Laya może analizować stan, pytanie i dostępne opcje jednocześnie, zamiast przewidywać wynik po jednym tokenie.
Ta różnica architektoniczna sprawia, że mały model decyzyjny może być atrakcyjny w zadaniach takich jak:
- kierowanie agentami;
- sortowanie wiadomości e-mail;
- moderacja;
- trafność dokumentu;
- wykrywanie intencji;
- mechanizmy bezpieczeństwa;
- eskalacja w przepływie pracy.
Są to dokładnie te rodzaje rutynowych zadań, w przypadku których przydatne staje się hybrydowe kierowanie zadań AI: powtarzalną pracę pozostaw tańszej warstwie lokalnej, a większy model rezerwuj na trudne przypadki.
Czy Laya rzeczywiście „nie ma halucynacji”?
Dokumentacja projektu stwierdza, że ponieważ Laya nie generuje tekstu, eliminuje błędy parsowania i halucynacje.
To stwierdzenie wymaga jednego ważnego zastrzeżenia.
Laya może eliminować takie błędy jak:
- nieprawidłowy JSON;
- wymyślone wartości wyliczeniowe;
- dodatkowy tekst wokół ustrukturyzowanej odpowiedzi;
- twierdzenia wygenerowane w formie swobodnej;
Mimo to może podjąć błędną decyzję.
Model może zwrócić:
billing: 0.92
nawet jeśli zgłoszenie powinno było trafić do pomocy technicznej.
Typowany wynik zapobiega nieprawidłowym odpowiedziom. Nie gwarantuje jednak poprawności ocen.
To rozróżnienie ma kluczowe znaczenie, jeśli wynik steruje agentem, przepływem bezpieczeństwa, procesem finansowym lub zautomatyzowanym działaniem.
Dlaczego kalibracja jest ważniejsza niż liczba określająca pewność
Laya jest trenowana przy użyciu RLCD, czyli uczenia ze wzmocnieniem na potrzeby skalibrowanych decyzji (Reinforcement Learning for Calibrated Decisions). Celem nie jest jedynie wybór prawidłowej odpowiedzi, lecz także zapewnienie użyteczności raportowanego prawdopodobieństwa.
System produkcyjny może następnie używać poziomu pewności do sterowania eskalacją:
| Pewność | Możliwe działanie |
|---|---|
| Bardzo wysokie | Obsłuż decyzję niskiego ryzyka automatycznie |
| Średnie | Zapytaj większy model |
| Niskie | Poproś o weryfikację przez człowieka |
Własna dokumentacja Laya pokazuje jednak, dlaczego nie należy ślepo ufać tym prawdopodobieństwom. Projekt informuje o znacznej poprawie kalibracji po dopasowaniu temperatury i zaleca kalibrowanie modelu w docelowej domenie wdrożenia.
Innymi słowy, model zaprojektowany do skalibrowanych decyzji nadal wymaga kalibracji pod kątem rzeczywistego obciążenia.
Najważniejszy wynik Laya nie dotyczy jej szybkości
Opublikowane przez Laya wyniki opóźnień robią wrażenie. Projekt podaje, że krótkie decyzje są podejmowane w ciągu kilkudziesięciu milisekund na karcie Tesla T4, natomiast niezależny port Laya-MLX raportuje około 13,4 ms dla modelu angielskiego i 7,4 ms dla wielojęzycznego checkpointu na układzie M3 Max.
Pomiary te potwierdzają, że Laya należy do zupełnie innej klasy wdrożeń niż generatywny model liczący miliardy parametrów.
Jednak bardziej wymowny jest fakt, jak silnie wydajność zależy od specjalizacji.
W przeprowadzonej przez projekt ewaluacji decyzji typowanych bazowy model Laya w trybie zero-shot osiąga wyniki tylko nieznacznie lepsze od losowego punktu odniesienia. Po dostrojeniu do konkretnego zadania wyspecjalizowany checkpoint znacznie poprawia wyniki.
| Ewaluacja decyzji typowanych | Zgłaszana dokładność |
|---|---|
| Losowy punkt odniesienia | ~0,318 |
| Bazowa Laya, zero-shot | ~0,36 |
| Dostrojona Laya do decyzji typowanych | ~0,766 |
Zmienia to sposób, w jaki należy rozumieć Layę.
Nie jest to koniecznie uniwersalny model rozumowania o 421 mln parametrów, który magicznie rozumie każdy nowy problem decyzyjny.
Największą zaletą Laya jest to, że mały model można wyspecjalizować do obsługi stabilnej powierzchni decyzyjnej, skalibrować, a następnie uruchamiać niezwykle tanio przy dużej liczbie zadań.
Dostrajanie może być ważniejsze niż model bazowy
Projekt publikuje narzędzia do trenowania i dostrajania modeli wraz z checkpointami. Jest to istotne, ponieważ wiele decyzji produkcyjnych jest silnie zależnych od konkretnej domeny.
Rozważ:
- Który wewnętrzny zespół wsparcia zajmuje się tą sprawą?
- Czy ten dokument pasuje do naszej prywatnej taksonomii?
- Czy ta automatyzacja domowa powinna zostać wykonana?
- Który agent powinien otrzymać to zadanie?
- Czy ten lokalny plik wymaga głębszej analizy AI?
Model ogólnego przeznaczenia może odpowiadać na te pytania, ale może wielokrotnie zużywać moc obliczeniową dużego modelu na odtwarzanie granicy decyzyjnej, która prawie się nie zmienia.
Wyspecjalizowany checkpoint Laya może zamiast tego nauczyć się bezpośrednio tej granicy.
Wpisuje się to w szerszy trend dotyczący modeli otwartych i AI klasy frontier: najbardziej zaawansowany model nie zawsze jest najbardziej wydajnym rozwiązaniem dla powtarzalnego, dobrze zdefiniowanego obciążenia.
Gdzie Laya nadal jest słaba
Opublikowane wyniki również pokazują wyraźne ograniczenia.
Duże przestrzenie etykiet są trudne. Dokumentacja Laya zaleca ograniczenie liczby opcji w pytaniach wyboru do około 20 lub mniej. Dostępne opcje dzielą stały budżet tokenów, więc bardzo duże płaskie taksonomie mogą pogarszać wydajność.
Hierarchiczna ścieżka często ma więcej sensu:
| Etap | Przykład |
|---|---|
| Pierwsza decyzja | Rozliczenia / Produkt / Bezpieczeństwo / Konto |
| Druga decyzja | Wybierz jedną z kilku podkategorii |
Ocena porządkowa to kolejny słabszy obszar. Poproszenie modelu o wybranie kategorii jest często łatwiejsze niż niezawodne rozróżnianie blisko powiązanych poziomów, takich jak poziomy frustracji od 1 do 5.
Kontekst jest również ograniczony w porównaniu z nowoczesnymi modelami LLM. Angielski checkpoint wykorzystuje budżet wejściowy wynoszący 512 tokenów, podczas gdy inne warianty Laya zwiększają go do 1024 tokenów.
Oznacza to, że Laya znacznie lepiej nadaje się do wyselekcjonowanych dowodów niż do umieszczania w modelu całego długiego dokumentu.
Laya a Jev: lokalny model otwarty czy zarządzane API decyzyjne?
Laya jest często opisywana jako open-source’owa alternatywa dla Jev, ale sprowadzenie porównania do wyników benchmarków pomija ważniejszą różnicę architektoniczną.
| Laya | Jev | |
|---|---|---|
| Główna rola | Decyzje typowane | Decyzje typowane |
| Otwarte wagi | Tak | Obecnie brak publicznie dostępnych wag |
| Samodzielne hostowanie | Tak | Hostowana usługa |
| Dostrajanie | Dostępne | Brak równoważnego publicznego lokalnego procesu |
| Lokalna ścieżka danych | Możliwe | Żądanie trafia do hostowanej usługi |
| Obciążenie operacyjne | Użytkownik zarządza modelem i kalibracją | Dostawca zarządza wnioskowaniem |
Wyspecjalizowany checkpoint Laya wykazuje wyższą dokładność niż Jev w jednym opublikowanym benchmarku decyzji typowanych, podczas gdy Jev wykazuje lepszą kalibrację w części tego samego porównania. To za mało, by uznać jeden model za uniwersalnie lepszy.
Większa różnica dotyczy kontroli.
Jev zapewnia programistom zarządzaną usługę decyzyjną. Laya udostępnia im wagi modelu, które można dostrajać, testować porównawczo, przypinać do konkretnej wersji i wdrażać obok prywatnych danych.
Czy Layę można uruchamiać całkowicie lokalnie?
Tak. To najważniejsza praktyczna zaleta Layi.
Oficjalny model działa przez PyTorch i Transformers. Projekty społecznościowe rozszerzyły już wdrażanie na inne środowiska uruchomieniowe:
Główny checkpoint 421M zajmuje mniej niż 1 GB w opublikowanej reprezentacji wag, co plasuje go w zdecydowanie niższej klasie wymagań pamięciowych niż większość użytecznych generatywnych LLM-ów.
Dzięki temu Laya jest istotna w praktycznym problemie kierowania modeli według zapotrzebowania na pamięć. System nie musi utrzymywać aktywnego dużego modelu generatywnego tylko po to, by klasyfikować każde przychodzące żądanie.
Dlaczego lokalne uruchamianie warstwy decyzyjnej ma znaczenie
Lokalne wnioskowanie nie polega wyłącznie na unikaniu opłat za API.
Dane wejściowe modeli decyzyjnych często są poufne:
- e-maile;
- zgłoszenia do pomocy technicznej;
- prywatne dokumenty;
- dane klientów;
- dane źródłowe;
- ślady agenta;
- lokalne wyniki wyszukiwania.
Hostowany interfejs API do podejmowania decyzji może być niedrogi, ale aplikacja nadal musi wysłać stan gdzieś w celu klasyfikacji.
Laya umożliwia inną architekturę:
| Warstwa lokalna | Warstwa eskalacji |
|---|---|
| Pobieraj prywatne pliki | Złożone rozumowanie |
| Klasyfikuj i oceniaj lokalnie | Model frontierowy |
| Wykrywaj poufne treści | Złożona synteza |
| Kieruj rutynowe zadania | Niejednoznaczne przypadki brzegowe |
To ten sam powód, dla którego lokalne przetwarzanie AI w pobliżu przechowywanych danych ma znaczenie. Przeniesienie decyzji pierwszego etapu obok danych może ograniczyć zarówno ekspozycję sieciową, jak i niepotrzebne wnioskowanie w chmurze.
Laya może stać się filtrem przed dużym modelem
Najlepsza architektura może wykorzystywać Layę zamiast LLM-a.
Może to być:
| Warstwa | Zadanie |
|---|---|
| Zasady | Obsługuj deterministyczne przypadki |
| Lokalna Laya | Obsługa powtarzalnych, nieprecyzyjnych decyzji |
| Duży model | Obsługa trudnego rozumowania lub generowania |
| Zasady / człowiek | Zatwierdzanie działań o dużym wpływie |
Wyobraź sobie prywatny system dokumentów z 10 000 lokalnych rekordów. Model frontierowy nie musi dogłębnie analizować wszystkich 10 000.
Mały lokalny model może najpierw zapytać:
- Czy to jest istotne?
- Do której kategorii należy?
- Czy zawiera poufne informacje?
- Czy poziom pewności jest wystarczająco niski, aby eskalować?
Tylko trudny podzbiór wymaga kosztownego wnioskowania.
Prywatny asystent AI na serwerze NAS to oczywiste środowisko dla tego wzorca, ponieważ przechowywanie, pobieranie, klasyfikacja i dane osobowe mogą pozostać lokalne, podczas gdy trudniejsze żądania są selektywnie przekazywane dalej.
Co właściwie zmienia Laya
Przez kilka lat architektura AI zmierzała w kierunku coraz bardziej ogólnych modeli: jednego modelu, który potrafi rozumować, programować, pisać, klasyfikować, wyszukiwać i wywoływać narzędzia.
Laya reprezentuje przeciwną koncepcję.
Niektóre zadania mogą być wykonywane lepiej, gdy modele stają się bardziej wyspecjalizowane, a nie bardziej ogólne.
Jeśli system potrzebuje milionów ocen, takich jak:
istotne czy nieistotne?
bezpieczne czy niebezpieczne?
przekierować do A, B czy C?
kontynuować czy eskalować?
wtedy lokalny model decyzyjny o 421 mln parametrów może zajmować zupełnie inną warstwę ekonomiczną i prywatności niż frontierowy LLM.
Dlatego ważne pytanie nie brzmi, czy Laya może pokonać Jev, Claude, Gemini lub GPT we wszystkim.
Nie może.
Bardziej przydatne pytanie brzmi:
ile decyzji w procesie AI od początku nie wymagało modelu generatywnego?
Jeśli odpowiedź brzmi „bardzo wiele”, małe lokalne modele decyzyjne mogą stać się jedną z brakujących warstw praktycznej infrastruktury AI.
Często zadawane pytania dotyczące Laya
Czym jest model Laya?
Laya to nieautoregresyjny model podejmowania decyzji z otwartymi wagami, stworzony przez Convai Innovations. Otrzymuje stan i pytania o określonym typie, a następnie zwraca wybory, wyniki lub prawdopodobieństwa wartości logicznych zamiast generować tekst w swobodnej formie.
Czy Laya jest open source?
Wagi modelu są opublikowane na licencji Apache 2.0, a projekt udostępnia publiczne zasoby do wnioskowania, ewaluacji i dostrajania.
Czy Laya może działać lokalnie?
Tak. Oficjalna implementacja działa z PyTorch, a środowiska społecznościowe obsługują ONNX w Node.js oraz MLX na układach Apple Silicon. Po pobraniu modelu hostowane API wnioskowania nie jest wymagane.
Czy Laya jest lepsza od Jev?
Nie uniwersalnie. Laya oferuje otwarte wagi, możliwość hostowania lokalnego i dostrajania, podczas gdy Jev zapewnia zarządzaną usługę podejmowania decyzji hostowaną w chmurze. Opublikowane benchmarki pokazują różne mocne strony w zależności od rodzaju zadania i kalibracji.
Do czego najlepiej używać Laya?
Laya najlepiej nadaje się do powtarzalnych decyzji w zamkniętym zakresie, takich jak routing, moderacja, ocena trafności, wykrywanie intencji, sortowanie wiadomości e-mail, kontrole bezpieczeństwa i decydowanie, kiedy zadanie powinien przejąć większy model lub człowiek.

Polecane produkty

Centrum Technologii i Sztucznej Inteligencji
Więcej do przeczytania

10 najlepszych asystentów programowania AI typu open source w 2026 roku
Porównaj 10 asystentów programowania AI typu open source do IDE, terminali, modeli lokalnych, samodzielnego hostingu, przepływów pracy Git i autonomicznego tworzenia oprogramowania.
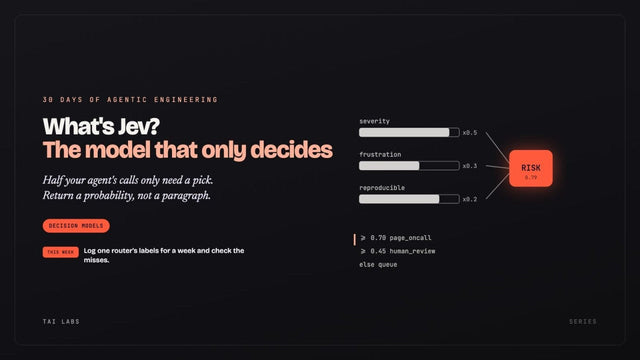
Przykłady zastosowań Jev: 7 rzeczy, które ludzie już budują za pomocą modelu decyzyjnego TypeSafe
Siedem rzeczywistych kompilacji Jev pokazuje, gdzie pasują modele decyzyjne: routing, działania w przeglądarce, ocenianie, filtrowanie, gry, analiza treści i selekcja materiałów badawczych.

Dlaczego domowe systemy NVR z AI przechodzą w 2026 roku od wykrywania klatek do rozumienia zdarzeń?
Dowiedz się, jak ścieżki stają się zdarzeniami, dlaczego kontekst czasowy ogranicza powtarzające się alerty oraz w jakich sytuacjach sztuczna inteligencja analizująca obraz z uwzględnieniem...


