
Progi pamięci GPU: jak wczesne sygnały ostrzegawcze zapobiegają błędom alokacji


Obserwowalny efekt pojawia się zwykle dlatego, że miękkie i twarde progi sygnalizują presję, zanim alokacja zasobów akceleratora się nie powiedzie. O jego skali w praktyce decydują współdzielone zasoby i czas.
W przypadku serwera domowego progi pamięci GPU mogą zmieniać zarówno interaktywne działanie systemu, jak i wykorzystanie zasobów w tle. Widoczny efekt pojawia się dopiero po przejściu żądania przez kilka etapów przetwarzania, dlatego pojedyncza średnia może ukryć, gdzie zaczęły się opóźnienia, spadek jakości lub awaria. Rozdzielenie stanu transmisji, obliczeń, pamięci masowej i aplikacji pozwala sprawdzić tę zależność w identycznych warunkach.
Mechanizm działania progów pamięci GPU
Mechanizm nie ogranicza się do końcowej aplikacji. Miękkie i twarde progi sygnalizują presję, zanim alokacja zasobów akceleratora się nie powiedzie. Ten etap zmienia dane odbierane przez kolejny komponent, więc zaobserwowanego wyniku nie można przypisać wyłącznie interfejsowi końcowemu lub modelowi. Utrzymanie stałych danych wejściowych i obciążenia pozwala uwidocznić tę wczesną transformację.
Model sterowania zasilaniem GPU pozwala konkretnie zinterpretować ten etap: miękkie i twarde progi sygnalizują presję, zanim alokacja zasobów akceleratora się nie powiedzie. W praktyce pozwala to oddzielić zmieniony parametr od późniejszych efektów buforowania, planowania, przechowywania danych lub renderowania, które mogą powodować podobne objawy.
Gdy zmieni się pierwszy etap, planista usuwa dane z pamięci podręcznej, zmniejsza rozmiar partii lub odrzuca zadania po przekroczeniu kolejnych progów. W zależności od pytania poruszanego w artykule skutkiem mogą być opóźnienia, spadek dokładności, większe zużycie energii, ograniczona wydajność lub odczuwalny brak płynności. Ścieżka przyczynowa nadal zaczyna się jednak przed wyświetleniem wyniku końcowego.
Dlaczego efekt nasila się pod obciążeniem
Pod obciążeniem bardziej widoczna staje się kolejna zależność, ponieważ gdy przekroczone zostają kolejne progi, planista usuwa dane z pamięci podręcznej, zmniejsza rozmiar partii lub odrzuca zadania. Równoległe zadania związane ze sztuczną inteligencją, pamięcią masową, multimediami lub automatyzacją mogą więc nasilać efekt, który w teście porównawczym z pojedynczym żądaniem wydaje się niewielki. Ważniejsze są skrajne opóźnienia niż średnia przy bezczynności systemu.
Mechanizm planowania wnioskowania na GPU łączy warstwę współdzielonych zasobów z wynikiem: gdy przekroczone zostają kolejne progi, planista usuwa dane z pamięci podręcznej, zmniejsza rozmiar partii lub odrzuca zadania. Osobny pomiar tej warstwy zapobiega myleniu przepustowości, trafień w pamięć podręczną, potwierdzeń lub optymistycznych aktualizacji statusu z faktycznie wykonaną pracą widoczną dla użytkownika.
Interakcja trwa, ponieważ fragmentacja może pozostawić zbyt mało ciągłej pamięci ponad próg wyrażony w bajtach. Dlatego dwa serwery domowe o tych samych deklarowanych parametrach sprzętu lub przepustowości sieci mogą działać inaczej, gdy różnią się głębokością kolejki, układem danych, stanem pamięci podręcznej lub zasadami zarządzania.
Czego nie wyjaśniają progi pamięci GPU
Zależność opisana w nagłówku przestaje być miarodajna w jednym ważnym przypadku: każde żądanie ma stałą, niewielką alokację, a rezerwa jest wystarczająca. Inne wąskie gardło może wyznaczać limit, zanim zmiana progów pamięci GPU stanie się mierzalna.
Zależność od planowania iteracji pomaga odróżnić oczekiwany mechanizm od konkurencyjnego wyjaśnienia. W kontrolowanym teście dane źródłowe, sprzęt, współbieżność, stan pamięci podręcznej i wersje oprogramowania muszą pozostać niezmienione; zmieniać należy tylko parametr wskazany w tytule. Zależność ta powinna być widoczna w powtarzalnym teście na serwerze domowym.
Granica niepowodzenia zostaje osiągnięta, gdy każde żądanie ma stałą, niewielką alokację, a rezerwa jest wystarczająca. Po jej przekroczeniu bardziej agresywne dostrajanie może zwiększyć koszty, ryzyko lub niestabilność, nie poprawiając rezultatu obiecanego w tytule.

Często zadawane pytania dotyczące progów pamięci GPU
Czy progi pamięci GPU są głównym wąskim gardłem?
Nie automatycznie. To główne wąskie gardło tylko wtedy, gdy zmiana tego parametru wpływa na wynik, podczas gdy harmonogramy eksmitują pamięci podręczne, zmniejszają rozmiar partii lub odrzucają zadania po przekroczeniu poszczególnych progów, a pozostałe warunki pozostają niezmienione. Jeśli wynik nie reaguje, limit wyznacza inny etap.
Czy buforowanie może ukryć wpływ progów pamięci GPU?
Tak. Rozgrzane pamięci podręczne, utrzymywane sesje, rezydentne modele, buforowane multimedia i optymistyczne aktualizacje interfejsu mogą ominąć badany etap. Wyniki prób na zimno i na ciepło należy przedstawiać osobno. Rezultat trzeba oceniać niezależnie od sąsiednich etapów potoku.
Który wskaźnik progów pamięci GPU ma największe znaczenie?
Przydatne pomiary to liczba wolnych bajtów, wielkość największego bloku, liczba eksmisji oraz nieudanych alokacji. Średnie wartości należy zestawiać z opóźnieniami skrajnymi, błędami, jakością lub kosztem zasobów, aby nie uznać pozornie płynniejszego działania za lepszą pracę systemu.
Przeprowadź kontrolowany test progów pamięci GPU
Przed zmianą progów pamięci GPU utwórz reprezentatywne obciążenie i zarejestruj liczbę wolnych bajtów, wielkość największego bloku, liczbę eksmisji oraz nieudanych alokacji. Przeprowadź próby na zimno i na ciepło, uwzględnij realistyczną współbieżność i zachowaj te same dane, wersje, sprzęt oraz kryterium powodzenia widoczne dla użytkownika we wszystkich porównaniach.
Przed testowaniem określ oczekiwany kierunek, korzystając z powiązanego mechanizmu opisanego w progach pamięci GPU. Zmieniaj jedną zmienną naraz, rejestruj medianę i wartości skrajne, a także zachowaj nieudany lub gorszy przypadek, aby wynik uwzględniał jego granice operacyjne.
Zastosuj zmianę tylko wtedy, gdy zmierzona korzyść utrzymuje się w powtarzanych próbach, a określona granica pozostaje akceptowalna. Jeśli dominuje inny etap, pozostaw progi pamięci GPU bez zmian i przetestuj ten konkurencyjny wąski gardło, zamiast wnioskować o przyczynowości na podstawie korelacji.

Polecane produkty

Centrum technologii i AI
Więcej do przeczytania
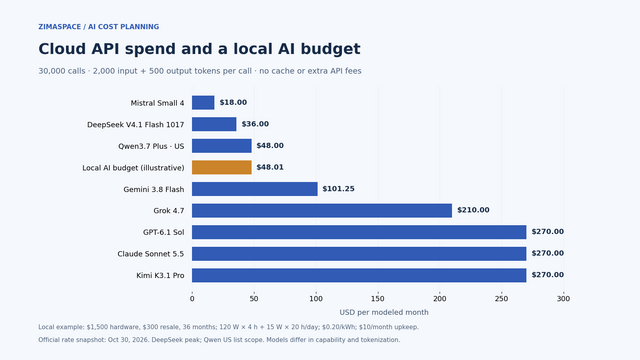
Cennik chmurowych API AI a lokalna AI: ile naprawdę kosztuje Twoje obciążenie?
Porównaj opłaty za tokeny API w chmurze z kosztami lokalnego sprzętu AI, energii elektrycznej i utrzymania. Przeanalizuj miesięczny przykład i skorzystaj z bezpłatnego kalkulatora...

Problem tajemnicy zero: dlaczego domowy agent AI nadal potrzebuje początkowego korzenia zaufania
Wyjaśnienie problemu sekretu zerowego, skoncentrowane na mechanizmie, kompromisów związanych ze współdzielonymi zasobami, odpowiedzi na trzy często zadawane pytania dotyczące rozsyłania zapytań oraz praktyczny protokół...
Federacja tożsamości obciążeń: jak usługi lokalne unikają współdzielonych kluczy API
Wyjaśnienie federacji tożsamości obciążeń oparte na mechanizmach, kompromisów związanych ze współdzielonymi zasobami, odpowiedzi na trzy często zadawane pytania dotyczące rozsyłania zapytań oraz praktyczny protokół...


