
Cosa fa sì che un array RAID resti degradato dopo l’aggiunta di un disco sostitutivo?


Un array RAID rimane degradato quando il disco sostitutivo è visibile ma non è ancora diventato un membro valido per la ricostruzione. Tra le cause più comuni ci sono dimensioni errate, metadati esterni, stato non supportato, mancata assegnazione manuale o un altro disco sorgente guasto.
Non inizializzare il disco sostitutivo né importare a caso una configurazione esterna. Innanzitutto identifica l'array esatto, il ruolo mancante, il numero di serie del disco sostitutivo, lo stato del controller e l'idoneità alla ricostruzione. L'obiettivo è collegare un'unità di destinazione vuota e idonea senza modificare la configurazione sorgente considerata affidabile.
Conferma che il controller corretto rilevi il disco sostitutivo
Un disco può comparire nel sistema operativo pur restando non disponibile al controller RAID, oppure comparire al controller in uno slot del dispositivo di archiviazione diverso da quello previsto. Confronta il numero di serie fisico, l'alloggiamento, la porta del controller e il numero di settori riportato.
Se il nuovo disco non è visibile a livello RAID, controlla l'alimentazione, il backplane, il cavo, la modalità HBA e la mappatura del dispositivo di archiviazione prima di modificare i metadati dell'array. Inserirlo ripetutamente senza verificarne il numero di serie può portare a intervenire sul membro sbagliato.
Ready, Unconfigured e Spare non indicano che la ricostruzione è in corso
Molti controller hardware collocano un nuovo disco in uno stato neutro, come Ready o Unconfigured Good. L'array rimane degradato finché il disco non viene assegnato come sostituto, disco di riserva dedicato o hot spare globale idoneo, secondo la procedura del controller.
Un nuovo disco nello stato Ready è un esempio utile: la sola presenza non riempie il ruolo RAID mancante. Verifica se è necessario l'inserimento a caldo, la sostituzione manuale o l'assegnazione come disco di riserva.
Il RAID software di solito richiede un'aggiunta esplicita
Gli array md di Linux non riaggiungono necessariamente un disco scomparso solo perché un dispositivo a blocchi è ricomparso nello stesso percorso. Il vecchio membro potrebbe essere ancora contrassegnato come rimosso, mentre il disco sostitutivo potrebbe essere presente solo come dispositivo inutilizzato.
Il comportamento di riaggiunta manuale con mdadm riflette un limite di sicurezza: fidarsi automaticamente di un dispositivo che è scomparso in precedenza può essere peggio che richiedere a un amministratore di verificarlo e aggiungerlo deliberatamente.
I metadati estranei possono bloccare il disco sostitutivo
Un disco riutilizzato può contenere firme RAID di un altro array. I controller lo contrassegnano come estraneo perché importarlo potrebbe modificare la configurazione attiva. Anche un disco nuovo può contenere metadati di fabbrica, di test o di un utilizzo precedente che ne impediscono l'idoneità automatica.
Non importare una configurazione estranea da un disco destinato a essere una sostituzione vuota. In un caso di disco sostitutivo con configurazione estranea, il passaggio appropriato era modificare lo stato del nuovo disco in Buono non configurato, non importare la vecchia definizione dell'array.
La capacità e la geometria dei settori devono rispettare i requisiti minimi dell'array
Il disco sostitutivo deve offrire almeno tanti settori utilizzabili quanti ne aveva il disco guasto. Un disco con la stessa capacità nominale può essere leggermente più piccolo. Alcuni controller rifiutano anche differenze nel formato dei settori logici o fisici, nel tipo di interfaccia, nella compatibilità del firmware o nelle funzionalità di crittografia.
Confronta la capacità esatta e il formato dei settori, non solo l'etichetta sulla confezione. Se il controller segnala che il nuovo disco non è supportato o è troppo piccolo, non forzarne la messa online: scegli un disco sostitutivo compatibile e più capiente.
Un altro disco sorgente potrebbe impedire la ricostruzione
La ricostruzione richiede dati leggibili dai dischi superstiti. Se un altro disco presenta settori irrecuperabili, timeout ripetuti o si scollega dall'array, il controller può interrompere l'operazione, mantenere il disco sostitutivo come riserva o lasciare l'array in stato degradato dopo un tentativo di ricostruzione fallito.
Esamina il registro degli eventi dal momento in cui il disco originale si è guastato fino al tentativo di sostituzione. L'avviso più recente può riferirsi al disco di destinazione, mentre il vero ostacolo potrebbe essere un errore di lettura su un altro disco sorgente.
Usa un ordine di risoluzione dei problemi basato sullo stato
| Stato della sostituzione | Significato probabile | Controllo successivo |
|---|---|---|
| Non rilevato | Problema di connessione o del percorso del controller | Alimentazione, cavo, alloggiamento, HBA, mappatura seriale |
| Pronto / Buono non configurato | Visibile ma non assegnato | Assegnazione come sostituzione o riserva |
| Estraneo | Metadati RAID precedenti presenti | Verifica l’identità; cancella i metadati solo dalla nuova destinazione |
| Troppo piccolo / non supportato | Errore di idoneità | Settori esatti, formato, supporto del controller |
| Unità di riserva, non in ricostruzione | Nessun avvio o errore della sorgente | Ruolo mancante, criteri, registri dei membri ancora funzionanti |
| Ricostruzione interrotta | La sorgente o il percorso non hanno potuto completare l’operazione | Errori di lettura, timeout, secondo guasto |
Un’assegnazione manuale della ricostruzione specifica per il controller potrebbe usare un’azione di unità hot spare per avviare il ripristino. Usa la transizione di stato documentata per la piattaforma, invece di comandi generici copiati da un altro stack RAID.
Verifica l’avvio della ricostruzione prima di lasciare il sistema
Una volta assegnato il ricambio, controlla abbastanza a lungo da confermare che il numero di blocchi elaborati aumenti e che il numero di serie previsto sia quello della destinazione. Una transizione di stato che inizia e si interrompe immediatamente lascia comunque l’array in stato di degrado, anche se il pannello di controllo ha mostrato brevemente la ricostruzione.
Salva il primo errore dopo un’interruzione. Spesso individua l’effettivo ostacolo meglio del riepilogo finale, soprattutto quando un disco sorgente ancora funzionante va in timeout o il controller rifiuta la geometria della destinazione.
Domande frequenti
Devo inizializzare prima il disco sostitutivo?
Di solito no. L’inizializzazione può scrivere metadati e risultare distruttiva se si seleziona il disco sbagliato. Prepara solo la destinazione vuota confermata, usando la procedura di sostituzione del controller.
Perché la sostituzione a freddo ha lasciato inutilizzato il nuovo disco?
Alcuni controller rilevano e associano i ricambi in modo diverso durante l’inserimento a caldo. La sostituzione a freddo può lasciare un ruolo mancante e un disco pronto separato, da assegnare manualmente.
Posso forzare l’unità online?
Le azioni di forzatura online sono destinate a specifiche situazioni di ripristino e possono promuovere dati obsoleti. Per un nuovo ricambio vuoto, assegnalo come destinazione della ricostruzione o come unità di riserva, invece di fingere che contenga i dati aggiornati dell’array.
L’array diventa integro solo dopo le modifiche ai membri
Un ricambio visibile non rimuove lo stato di degrado. Deve essere idoneo, assegnato al ruolo mancante, ricostruito a partire da sorgenti leggibili e promosso a membro attivo e sincronizzato.

Assistenza e consigli
Altre letture
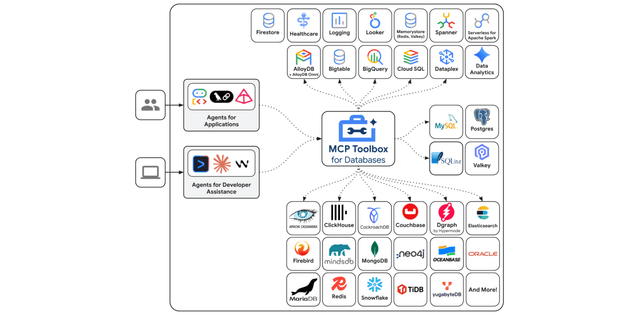
Vulnerabilità di Google MCP Toolbox: cosa dovrebbero controllare gli utenti di IA self-hosted
Scopri l’accesso ai file di MCP Toolbox con il contesto verificato della release, i limiti pratici del flusso di lavoro, la gestione dei file...
Come verificare i requisiti di memoria e runtime prima di eseguire LFM2.5-24B-A2B
Verifica il formato dei pesi di LFM2.5-24B-A2B, l’overhead di memoria, le versioni del runtime, il contesto e la compatibilità con gli strumenti prima di...
Come testare Granite Speech 5.0 con file audio in inglese archiviati sul tuo NAS
Prova Granite Speech 5.0 con una breve registrazione in inglese dal tuo NAS. Verifica la revisione del checkpoint, il runtime, la frequenza di campionamento,...


