
Une note de Zima
Merci, Ted, de documenter le ZimaCube 2 comme un système qui évolue par couches plutôt que comme un appareil terminé. Votre projet Pioneer consigne les mises à niveau réussies, les benchmarks du stockage, la migration d’Immich et les éléments qui ont résisté — notamment une solution Thunderbolt qui a finalement laissé place à une solution OCuLink. En publiant les mesures, les solutions de contournement, les erreurs et l’évolution des choix matériels au fil du projet, vous offrez à la communauté quelque chose de plus utile qu’une simple fiche technique finale : le témoignage de l’évolution d’un homelab ZimaOS réel.
— Zima
Découvrez ted-knight
Ted-knight documente l’une des configurations de ZimaCube 2 les plus méthodiques du Pioneer Program. Son projet ZimaCube 2 ne s’articule pas autour d’une configuration finale unique. Le projet est plutôt divisé en phases, chaque couche étant testée avant l’ajout de la suivante.
L’objectif de cette configuration est simple : créer un NAS capable de protéger des données importantes dès aujourd’hui, tout en laissant suffisamment de marge pour l’auto-hébergement, les médias, l’IA locale et d’autres charges de travail à l’avenir. Cela a conduit ted à explorer l’architecture de stockage, ZFS, les mises à niveau de la RAM et des SSD NVMe, l’extension OCuLink, les benchmarks, l’intégration de ZimaOS, la migration d’Immich et une feuille de route de plus en plus détaillée pour l’évolution future de la machine.
Il a commencé avec le ZimaCube 2 Standard : un système équipé d’un Intel Core i3-1215U, de 8 Go de DDR5 et d’un disque système NVMe de 256 Go. La configuration d’origine n’est pas restée inchangée bien longtemps.
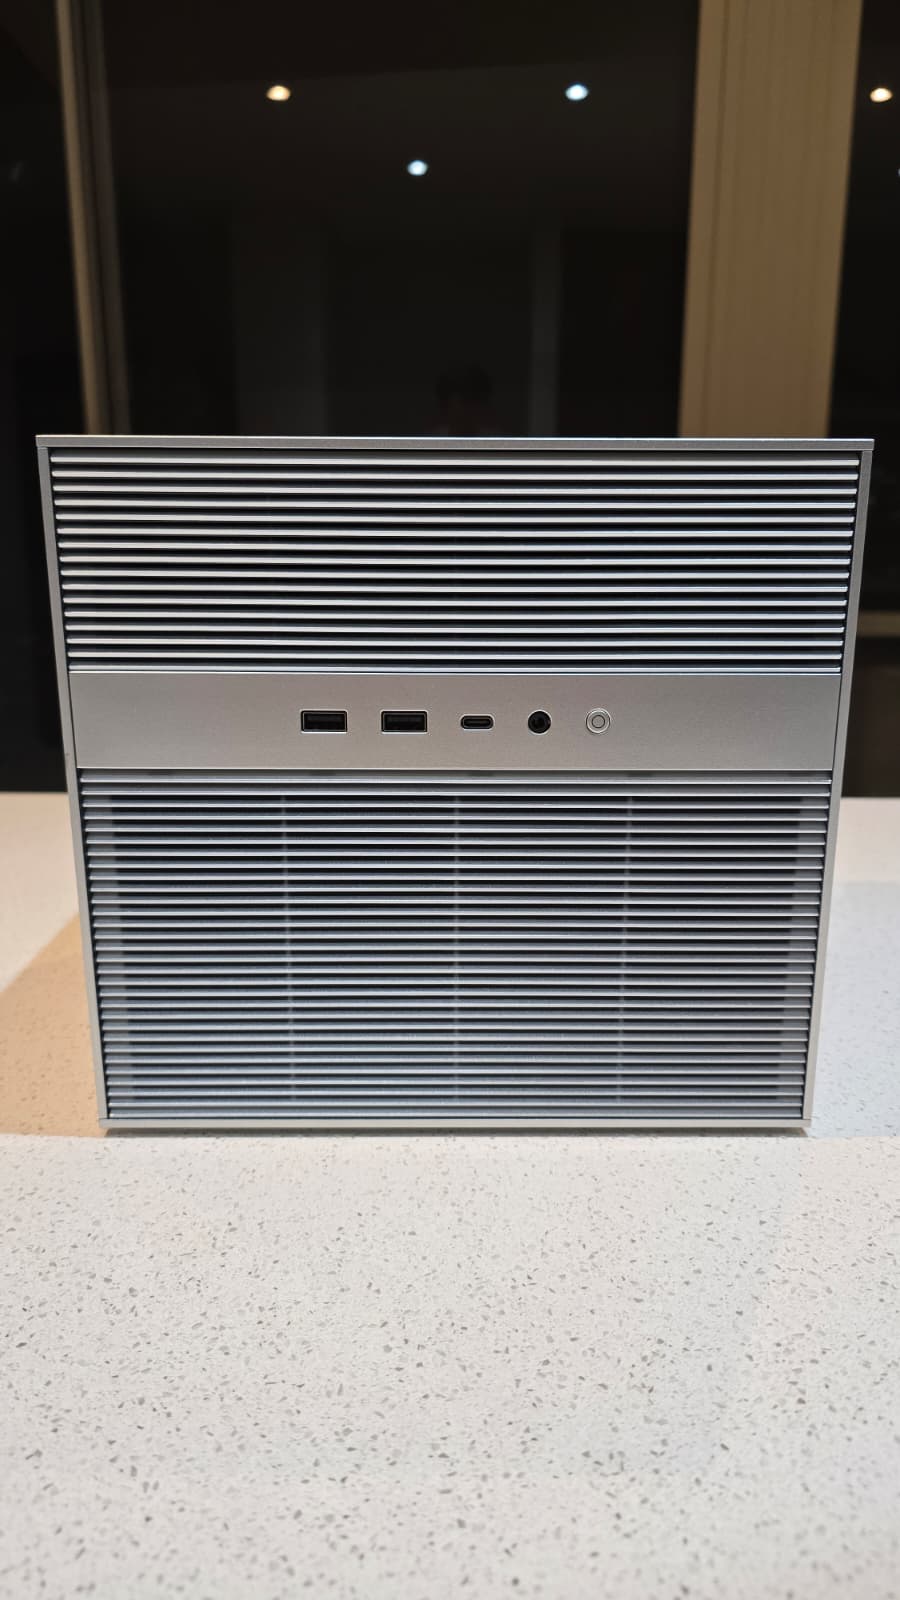
Construire les fondations du stockage avant d’ajouter d’autres services
La première priorité de Ted n’était pas de remplir le serveur d’applications, mais de décider où chaque type de données devait être stocké.
Le système qui en résulte utilise plusieurs niveaux de stockage, chacun ayant un rôle volontairement différent. ZimaOS reste installé sur son propre SSD NVMe Kingston de 256 Go. Un Crucial P510 NVMe de 2 To est devenu Arctic-Storage, un niveau btrfs destiné aux données d’application, aux images Docker, aux bases de données et aux autres charges de travail actives. Quatre SSD NVMe de 2 To forment glacier, un pool ZFS RAIDZ1 offrant environ 5,5 To d’espace utilisable. Plus tard, quatre disques Seagate IronWolf de 4 To ont constitué un pool btrfs RAID5 de 12 To destiné aux médias en masse et aux données moins fréquemment utilisées.
L’architecture consiste moins à faire fonctionner tous les disques de la même manière qu’à adapter le stockage à la charge de travail. Les bases de données fortement sollicitées en E/S aléatoires ont leur place sur le P510 rapide. Les charges séquentielles plus importantes et les données qui bénéficient des sommes de contrôle et de la redondance ZFS peuvent être stockées sur glacier. Les médias en vrac peuvent être déplacés vers le niveau IronWolf de plus grande capacité.
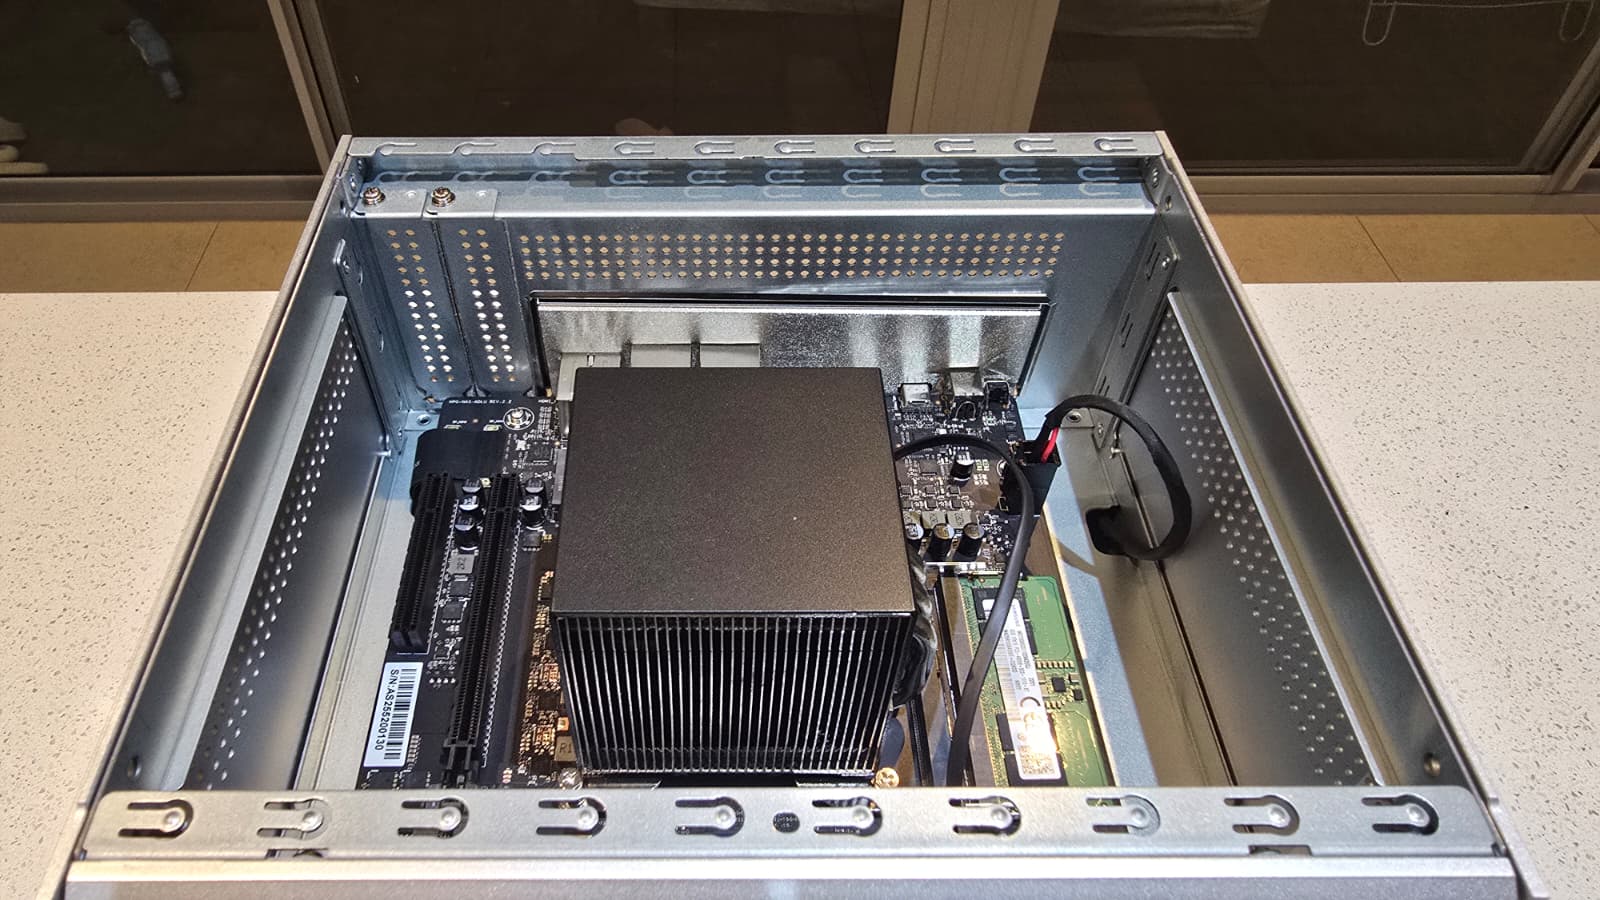
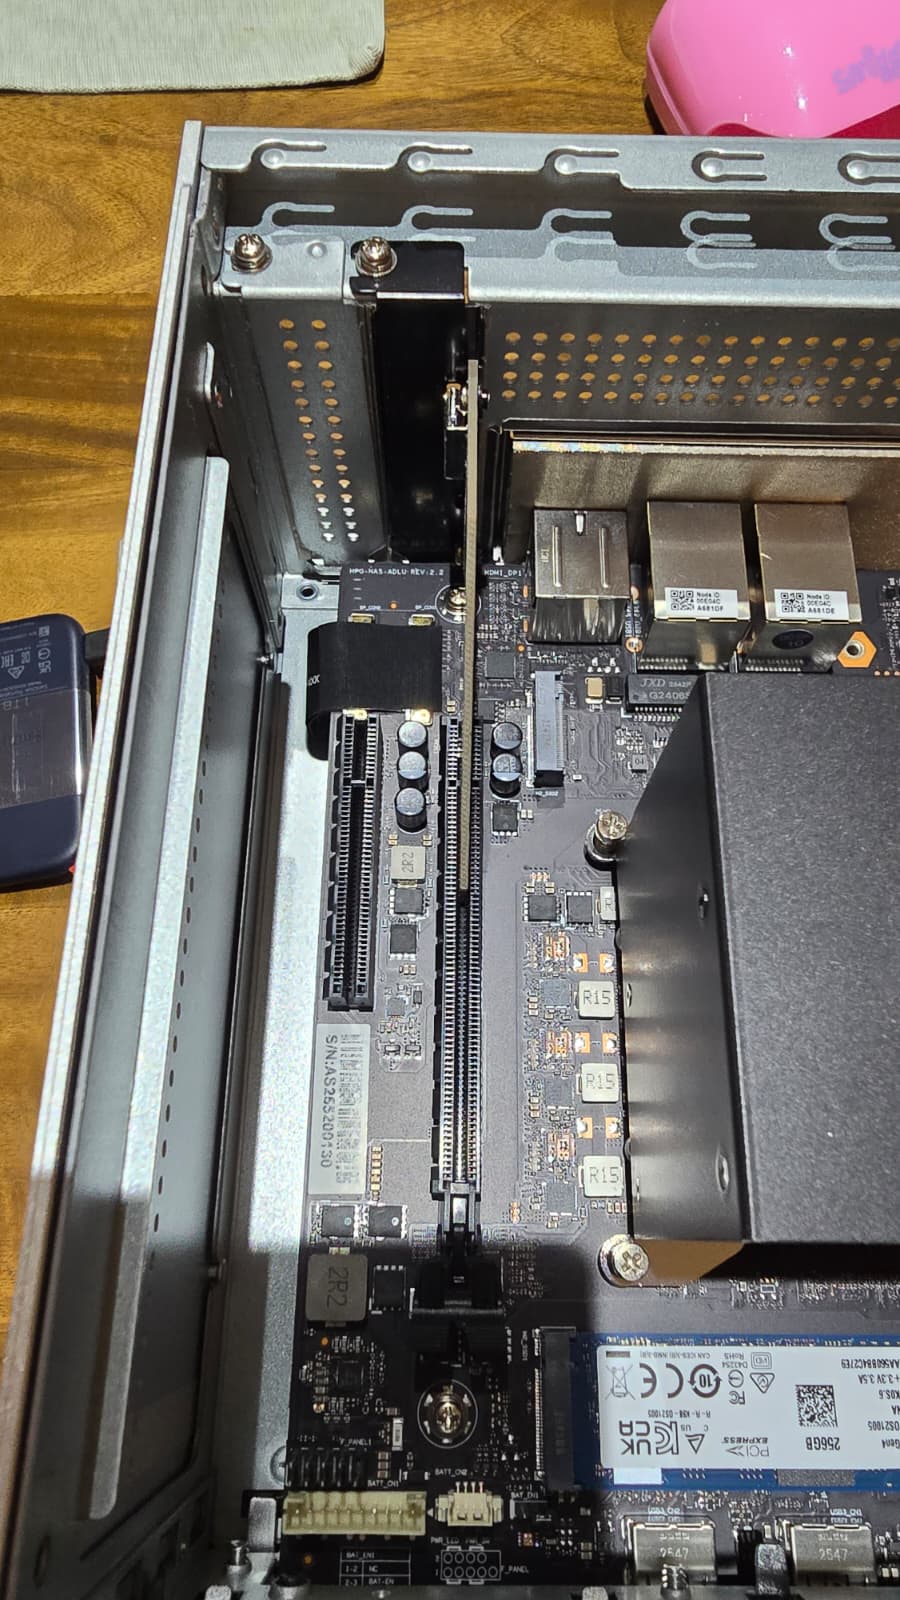
Quand Thunderbolt 4 n’a pas fonctionné, l’architecture a changé
L’un des aspects les plus utiles du projet de ted est que les expériences infructueuses restent documentées.
Le plan initial consistait à connecter un boîtier Aoostar TB4S-OC à quatre NVMe au ZimaCube 2 via Thunderbolt 4. Ted a testé différents câbles 40 Gbit/s, les deux ports Thunderbolt, l’alimentation externe et le comportement du noyau sous-jacent, mais le boîtier ne parvenait toujours pas à établir une connexion PCIe stable.
L’enquête a finalement mis en évidence l’interaction entre la configuration Thunderbolt de ZimaOS et le contrôleur ASMedia ASM2462PDX intégré au boîtier. Au lieu de continuer à imposer le plan initial, ted a modifié l’architecture.
Un adaptateur PCIe x4 vers OCuLink a été installé dans le slot 1. Le boîtier Aoostar est passé de Thunderbolt à une connexion OCuLink directe. Les quatre disques NVMe sont apparus dès le premier démarrage, sans les problèmes de tunneling et d’autorisation qui avaient bloqué la configuration Thunderbolt.
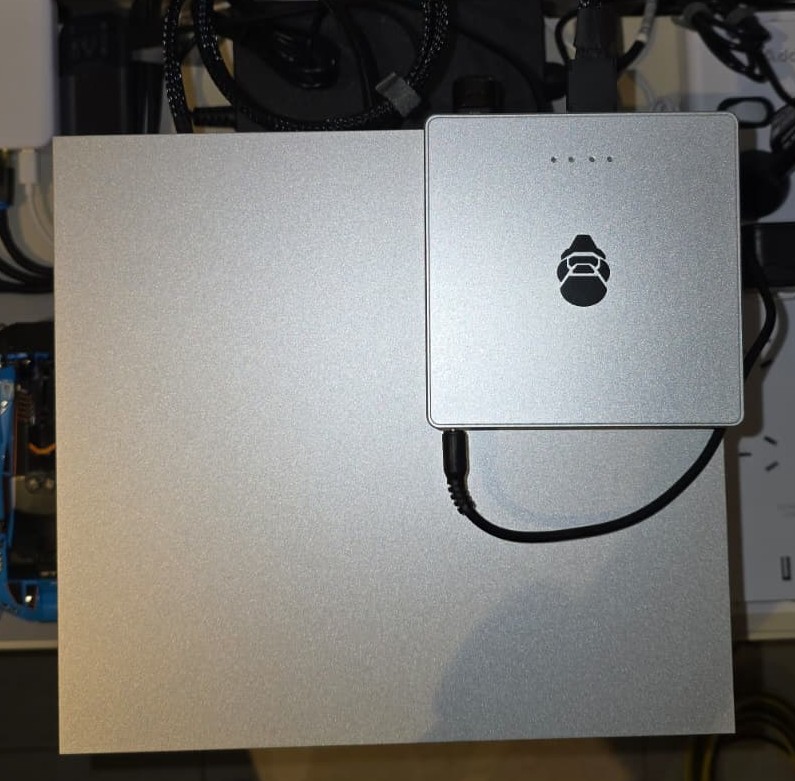
Le changement a également influé sur les plans ultérieurs. Le slot 1 est désormais occupé par le stockage, tandis que les deux ports Thunderbolt restent disponibles pour de futures expériences, comme la mise en réseau directe ou une autre configuration d’eGPU. Une connexion échouée n’est pas simplement devenue une note de bas de page consacrée au dépannage ; elle a modifié la feuille de route de toute la machine.
Évaluer les performances du stockage au lieu de supposer quel niveau était le plus rapide
Une fois le stockage en place, ted l’a mesuré.
Son travail de phase 1.5 utilise zpool pour comparer le pool glacier ZFS RAIDZ1 à Arctic-Storage, plutôt que de considérer « NVMe » comme une seule catégorie de performances. Le benchmark à froid a montré que glacier atteignait 1 726 Mo/s en écriture séquentielle et 2 591 Mo/s en lecture séquentielle, tandis que le niveau Arctic à disque unique était nettement plus performant en E/S aléatoires, atteignant 205 588 IOPS en lecture aléatoire 4K à son emplacement initial.
Le résultat le plus intéressant est apparu lorsque le cache ARC de ZFS est entré en jeu. Les lectures répétées depuis glacier pouvaient être servies par la RAM plutôt que de solliciter à nouveau les disques NVMe. Avec la configuration mémoire précédente de 16 Go, les lectures aléatoires à chaud ont atteint environ 83 929 IOPS, contre 14 781 IOPS à froid.
Cette constatation a ensuite influencé une autre décision matérielle. Ted a fait passer la machine à 32 Go en utilisant deux modules DDR5 de 16 Go, passant de la mémoire monocanal à la mémoire bicanal. Après la mise à niveau, les lectures aléatoires ARC à chaud ont encore augmenté pour atteindre 126 816 IOPS, soit une amélioration mesurée de 51 % par rapport au résultat précédent.
Les benchmarks ont également remis en question l’emplacement initial du Crucial P510. Dans la 7e baie du modèle Standard, le débit séquentiel était limité par le pont. Ted a déplacé le disque vers l’emplacement M.2 intégré et a mesuré une hausse des lectures séquentielles, de 874 Mo/s à 1 677 Mo/s, tandis que les performances en lecture aléatoire 4K sont passées de 205 588 à 403 078 IOPS.
La leçon n’était pas simplement qu’un emplacement était plus rapide. Les mesures ont modifié la répartition des charges de travail et indiqué quelles mises à niveau valaient réellement la peine.
Faire fonctionner ZFS aux côtés de ZimaOS
Cette configuration révèle également une limite intéressante entre ce que ZimaOS gère nativement et ce qu’un utilisateur expérimenté peut ajouter en dessous.
Ted utilise délibérément btrfs pour Arctic-Storage et le pool IronWolf, car ces volumes s’intègrent naturellement à ZimaOS. Le pool glacier est différent. Il a été créé en ZFS RAIDZ1 depuis la ligne de commande, ce qui fournit à Ted des jeux de données ZFS, des sommes de contrôle, la mise en cache ARC, des instantanés et un modèle de stockage mieux adapté à certains de ses usages prévus.
Cette flexibilité a toutefois un inconvénient : les pools ZFS créés en ligne de commande n’apparaissent pas comme des volumes de stockage natifs de ZimaOS dans l’interface.
La solution de Ted est simple et pratique. Il expose les jeux de données ZFS individuels via des liens symboliques sous /DATA, il permet à des chemins tels que les documents glacier, les médias, les sauvegardes et le stockage des machines virtuelles d’apparaître dans l’application Fichiers de ZimaOS, tandis que le pool sous-jacent reste géré par ZFS.
Il a constaté un autre problème de visibilité lié à la mémoire. ZimaOS peut signaler qu’une grande partie de la RAM est « utilisée » lorsque le cache ARC de ZFS remplit une mémoire autrement inutilisée. En examinant btop et les statistiques ARC racontent une histoire plus utile : le cache consomme de la mémoire parce qu’elle est disponible, et ZFS peut la libérer lorsque les applications en ont besoin.
C’est le type de retour qui compte dans une configuration Pioneer. Ted ne montre pas seulement ce qui fonctionne dans ZimaOS ; il documente également les limites actuelles de l’interface lorsqu’une configuration de stockage avancée les atteint, ainsi que ce qu’il fait dans ce cas.
Déplacer une bibliothèque Immich existante sans perdre son historique
L’architecture de stockage devient beaucoup plus significative dès que des données irremplaçables commencent à y être déplacées.
Pour ted, ce test concernait Immich. Il disposait déjà d’une instance Immich exécutée sur un ancien serveur ZimaOS DIY et souhaitait la déplacer vers le ZimaCube 2 sans repartir de zéro.
La migration concernait 14 505 photos et 925 vidéos, soit 134 Gio au total. Mais les données importantes ne se limitaient pas aux fichiers image. Les albums, les personnes, la reconnaissance faciale, les souvenirs, les liens partagés et d’autres métadonnées étaient stockés dans PostgreSQL.
À l’aide de l’application Fichiers de ZimaOS sur le réseau local, ted a copié les deux /DATA/Gallery/immich ainsi que l’intégralité de /DATA/AppData/immich le répertoire, notamment pgdata. L’instance Immich source a été arrêtée avant la copie afin de préserver la cohérence des données PostgreSQL.
Après la migration, le compte, les albums, les informations sur les visages, les souvenirs et la bibliothèque sont restés intacts, sans aucune perte de données signalée. Ted a ensuite vérifié directement la base de données PostgreSQL au lieu de supposer qu’une connexion réussie signifiait que tout avait été conservé.
Si vous envisagez le même type de migration, notre guide de migration d’Immich vers le ZimaCube 2 explique la même distinction essentielle : déplacer uniquement la bibliothèque multimédia ne suffit pas — la base de données doit être déplacée avec elle.
D’une migration de 134 Gio à 725 Gio de photos et vidéos auto-hébergées
La phase Immich ne s’est pas terminée lorsque la migration de l’ancien serveur a réussi.
Ce qui avait commencé comme le déplacement d’une bibliothèque ZimaOS existante est devenu un changement beaucoup plus important : iCloud n’était plus le lieu de stockage principal des photos et vidéos de ted. Son iPhone a commencé à transférer la bibliothèque iCloud d’origine vers Immich, exécuté sur le ZimaCube 2.
À la fin de cette phase, le serveur contenait 63 665 éléments totalisant 725 Gio : 55 604 photos et 8 061 vidéos. Le transfert depuis iCloud représentait à lui seul environ 655 Go, les vidéos 4K étant responsables de la majeure partie de cet espace de stockage.
L’objectif n’était pas de prétendre que tous les services cloud d’Apple pouvaient être remplacés. Ted a tout de même identifié les sauvegardes d’appareils, les messages et d’autres données propres à iOS qu’il est pertinent de conserver dans une formule iCloud moins coûteuse. Le changement était plus ciblé : déplacer la vaste photothèque et vidéothèque vers un stockage qu’il contrôle, tout en conservant les services cloud qui restent utiles.
Cette décision a également créé une nouvelle responsabilité. Une photothèque auto-hébergée ne devient plus sûre qu’une copie dans le cloud que si elle est correctement sauvegardée. Les notes de migration de Ted s’étendent donc à une seconde copie sur TrueNAS, jetant les bases de la vaste phase de sauvegarde 3-2-1 qui reste sur la feuille de route.
Construire autour de ce que ZimaOS simplifie — et mesurer le reste
Plusieurs aspects du projet tirent parti de cet équilibre. L’outil intégré de migration d’AppData a déplacé les données des applications Docker hors du disque système vers Arctic-Storage, sans devoir reconstruire chaque application. L’application Fichiers a fourni le flux de travail LAN utilisé pour la migration vers Immich. Les outils natifs, notamment
fio zpool, zfs, nvme, et, iostat a permis de mesurer et de gérer l’architecture de stockage sous la couche graphique.
D’autres éléments montrent que l’expérience est encore moins intégrée à certains endroits. Le stockage ZFS créé en ligne de commande nécessite la solution de contournement par lien symbolique. L’ARC rend le chiffre standard de la RAM facile à mal interpréter. Le comportement de Thunderbolt a imposé une refonte matérielle.
Ces observations rendent le projet plus intéressant qu’une démonstration où chaque expérience fonctionne du premier coup. Ted documente la frontière entre une expérience ZimaOS simple et le travail de homelab plus approfondi qui commence lorsque l’on décide de la franchir.
Ce qui est déjà construit — et ce qui reste sur la feuille de route
Le titre du dépôt de ted décrit la destination comme un NAS modeste alimenté par l’IA, mais le projet est volontairement construit par phases.
Les fondations sont déjà bien réelles. Le stockage par niveaux est opérationnel. Le pool ZFS RAIDZ1 glacier est fonctionnel. Arctic-Storage a été déplacé vers le slot M.2 intégré. La mémoire atteint 32 Go en double canal. Le pool IronWolf en RAID5 existe. Les benchmarks de stockage sont terminés. La migration vers Immich et la consolidation plus large des photos iCloud sont terminées.
La couche multimédia continue de se développer. Le pool IronWolf a été créé pour les contenus multimédias volumineux, tandis que Jellyfin et l’ensemble de la pile *arr restent inclus dans le travail actuel de la phase 2.
Les couches d’IA sont encore à venir. La feuille de route de Ted prévoit actuellement des tests d’Ollama fonctionnant uniquement sur le CPU en phase 4a, suivis d’une solution eGPU avec RTX 4090 en phase 4b, puis d’une recherche sémantique dans le stockage local en phase 5.
Cette distinction est importante. Le ZimaCube 2 est déjà préparé pour l’IA locale grâce au positionnement du stockage, à la capacité mémoire, aux choix PCIe et à la planification des charges de travail, mais le projet n’a pas encore atteint le stade où l’inférence GPU devrait être présentée comme un résultat achevé.
Pour les lecteurs qui explorent dès maintenant cette orientation future, notre guide sur l’IA locale sur le ZimaCube 2 examine comment Ollama, la mémoire, l’extension PCIe et les futures mises à niveau GPU peuvent s’intégrer à une feuille de route de homelab similaire.
Une construction qui évolue lorsque les données évoluent
Le schéma le plus constant du projet de ted ne concerne ni ZFS, ni Immich, ni un composant matériel particulier. Il réside dans sa volonté de modifier une décision après avoir mesuré ce qui s’est réellement produit.
Le boîtier Thunderbolt ne fonctionnait pas ; le chemin de stockage a donc été basculé vers OCuLink.
Le P510 ne pouvait pas exploiter son potentiel dans la 7e baie ; il a donc été déplacé vers le logement M.2 intégré.
L’ARC de ZFS s’est montré plus performant que prévu ; la mémoire est donc devenue une amélioration des performances plutôt qu’une simple capacité supplémentaire.
Une migration Immich de 134 Gio s’est déroulée sans perte de la base de données, si bien que l’expérience s’est étendue au déplacement de plusieurs centaines de gigaoctets supplémentaires hors d’iCloud.
Chaque phase laisse derrière elle des mesures, des commandes, des erreurs et des hypothèses mises à jour pour la phase suivante. Le dépôt est ainsi utile même à ceux qui ne construisent jamais exactement la même configuration de stockage.
L’histoire est encore en train de s’écrire
L’histoire de ted-knight et de Zima est encore en train de s’écrire. Le ZimaCube 2 a commencé comme un modèle Standard de 8 Go et est déjà devenu un système de stockage multiniveau avec btrfs, ZFS RAIDZ1, une extension NVMe via OCuLink, 32 Go de mémoire en double canal, une archive IronWolf en RAID5 et une bibliothèque Immich auto-hébergée contenant des centaines de gigaoctets de contenus personnels.
Les prochaines phases restent volontairement ouvertes : Jellyfin et la pile multimédia, des processus de sauvegarde plus robustes, l’IA locale fonctionnant uniquement sur le CPU, une future voie GPU, la recherche sémantique et tout ce que les mesures amèneront ted à reconsidérer en cours de route.
Si vous souhaitez suivre la construction au fil du passage de ces phases de la feuille de route aux résultats concrets, suivez la construction ZimaCube 2 de ted-knight sur GitHub.



