
Checklist d’un serveur IA local avant d’acheter un GPU


N'achetez un GPU local pour l'IA qu'après avoir défini les modèles ciblés, la taille du contexte, l'adéquation de la VRAM, la prise en charge par le runtime, l'alimentation, le refroidissement, le niveau sonore et les performances de référence mesurées du CPU.
Définissez la charge de travail avant le GPU
Indiquez les modèles, la quantification, la longueur du contexte, le nombre d'utilisateurs simultanés, les fonctionnalités d'image ou audio et l'objectif de latence. L'inférence, le fine-tuning, la génération d'images et les charges vidéo sollicitent différemment la mémoire et la puissance de calcul.
Exécutez d'abord le logiciel prévu sur le CPU ou un GPU disponible. Notez le nombre de tokens par seconde, le délai avant le premier token, le temps de chargement du modèle et l'utilisation de la RAM système. Un achat doit répondre à un écart mesuré.
- Le plus grand modèle et la quantification que vous exécuterez chaque semaine.
- Le contexte maximal et le nombre de sessions simultanées.
- Le runtime et la prise en charge du système d'exploitation requis.
- Le temps de réponse, le niveau sonore et le coût d'électricité acceptables.
Dimensionnez la VRAM pour l'ensemble de travail
Les poids du modèle ne sont qu'un point de départ. Le cache de contexte, la surcharge du runtime, les composants multimodaux, le traitement par lots et les autres utilisateurs du GPU consomment également de la mémoire. Prévoyez une marge plutôt que de viser exactement la capacité annoncée.
Les recommandations indépendantes concernant l'IA locale soulignent que la VRAM est une contrainte d'adéquation prioritaire, car le transfert de couches vers la mémoire système peut réduire les performances interactives, même lorsque le GPU offre une puissance de calcul élevée.
Choisissez le plus petit GPU qui maintient la charge de travail courante en mémoire avec une marge suffisante. N'achetez pas pour un modèle rare si la location ou un déport plus lent vers le CPU convient à ce cas particulier.
Vérifiez la compatibilité logicielle et matérielle
| Vérification | Éléments à vérifier | Signal d'arrêt |
|---|---|---|
| Runtime | Backend et précision pris en charge | Une solution communautaire est la seule possibilité |
| Emplacement | Longueur, hauteur, largeur et câblage des lignes | Bloque le HBA ou la NIC requis |
| Alimentation | Capacité du bloc d'alimentation et connecteurs | Les adaptateurs dépassent les limites de sécurité |
| Refroidissement | Arrivée d'air frais et évacuation | Recyclage de l'air ou boîtier fermé |
| Hôte | Resizable BAR/IOMMU si nécessaire | Le firmware ne peut pas exposer la fonctionnalité requise |
La compatibilité dépend du runtime exact et de la génération de la carte. Vérifiez les applications que vous déploierez, et pas seulement le tableau générique de prise en charge d'un framework.
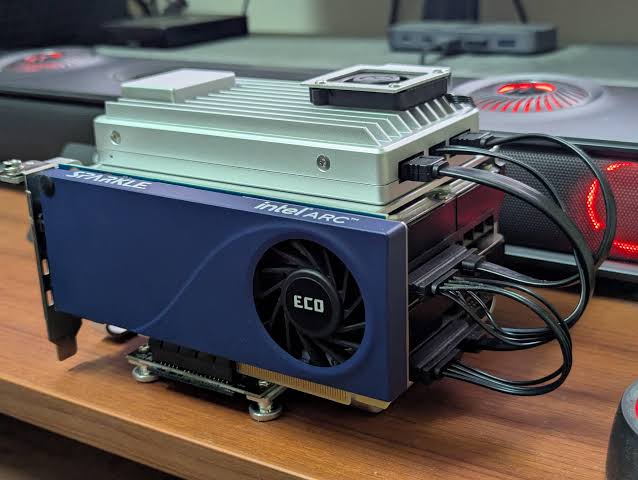
Un accélérateur d'occasion peut nécessiter un refroidissement non standard ou une vitesse de ventilation élevée. Une V100 modifiée a atteint un niveau sonore extrême malgré une valeur intéressante pour l'inférence, ce qui montre pourquoi le prix par VRAM ne suffit pas à prendre une décision pour un serveur.

Prévoyez l'alimentation, la chaleur, le stockage et le coût au repos
Mesurez la consommation au secteur avant la mise à niveau, puis estimez l'énergie consommée au repos et en charge selon votre cycle d'utilisation hebdomadaire réel. Une carte qui consomme beaucoup au repos peut coûter davantage à long terme que ne le laisse penser son faible prix d'achat.
Prévoyez un flux d'air suffisant pour le GPU, le CPU, la mémoire et le stockage voisin simultanément. Testez la température de la pièce et le boîtier prévus, et non un banc ouvert.
Conservez les fichiers des modèles et les caches sur un stockage local rapide disposant d'une marge suffisante. Ne laissez pas les téléchargements ou les sorties générées remplir le volume système qui contient le runtime et les journaux.
Utilisez un seuil d'achat, d'attente ou de location
Achetez lorsque la charge de travail courante tient dans la VRAM, que le runtime est pris en charge, que le boîtier et le bloc d'alimentation sont conformes et que l'utilisation mesurée est suffisamment fréquente pour justifier la propriété. Privilégiez une période de retour assez longue pour tester le serveur complet.
Attendez lorsque les exigences des modèles évoluent encore ou que la configuration de référence du CPU répond déjà à l'objectif de latence. Louez les tâches plus importantes occasionnelles plutôt que de concevoir votre installation domestique autour du maximum rare.
Avant le déploiement, consultez le guide des systèmes d'exploitation pour serveurs domestiques afin de décider si le runtime d'IA doit être installé directement sur le matériel, dans une machine virtuelle ou sur un hôte de conteneurs. Ne laissez pas l'achat du GPU décider accidentellement de toute l'architecture.
Foire aux questions
La VRAM est-elle plus importante que la vitesse brute du GPU pour l'IA locale ?
Souvent, car le modèle et son contexte doivent tenir en mémoire avant que la puissance de calcul puisse être exploitée efficacement. Comparez l'ensemble de travail complet, puis utilisez la vitesse pour départager les cartes qui conviennent.
Un ancien GPU de centre de données peut-il fonctionner dans un serveur domestique ?
Parfois, mais vérifiez les pilotes, les connecteurs d'alimentation, le refroidissement, le comportement de l'affichage, la consommation au repos et le niveau sonore. Un faible prix d'achat peut cacher des coûts d'intégration importants.
Dois-je acheter deux GPU plus petits plutôt qu'une seule carte plus puissante ?
Uniquement lorsque le runtime peut répartir efficacement la charge de travail ciblée et que l'hôte dispose d'assez de lignes, de puissance, de flux d'air et d'espace entre les emplacements. La VRAM cumulée n'est pas toujours transparente pour une application.
Conclusion
N'achetez que lorsque toutes les exigences incontournables sont satisfaites dans la pièce et sur le réseau réels ; sinon, attendez, réduisez la portée de la conception ou choisissez une plateforme plus simple.

Produits recommandés

Guide d'achat
Plus à lire

Liste de contrôle du stockage du serveur de conteneurs avant la création d’un grand pool unique
Une liste de contrôle de conception du stockage qui empêche qu’un pool de conteneurs pratique ne devienne un unique domaine partagé de capacité et...

Liste de contrôle du mélange des disques NAS avant de combiner les capacités
Une liste de contrôle préalable à l’achat et au déploiement pour des disques NAS mixtes, qui évite la perte de capacité cachée et les...
Checklist d'achat d'un serveur d'occasion pour un lab domestique silencieux
Un contrôle pratique avant achat pour le matériel de homelab d’occasion, qui privilégie l’acoustique, la consommation d’énergie, la facilité d’entretien et une propriété récupérable.


