
Las 10 mejores interfaces web de IA local para laboratorios domésticos en 2026


Una buena interfaz web de IA local convierte un servidor de modelos de línea de comandos en un servicio privado que cualquiera en casa puede usar. Las mejores opciones también conservan el historial de chats, gestionan modelos y permiten añadir documentos o herramientas sin obligar a cada usuario a entender la infraestructura que hay detrás.
Open WebUI es la mejor opción general para la mayoría de los laboratorios domésticos, pero no es automáticamente la mejor interfaz para todos los usos. LibreChat ofrece más posibilidades para agentes y herramientas MCP, AnythingLLM prioriza RAG basado en documentos, text-generation-webui ofrece controles de inferencia más avanzados y Dify o Flowise tienen más sentido cuando el objetivo es crear aplicaciones en lugar de simplemente chatear. La siguiente comparativa parte de las necesidades prácticas para que puedas elegir la interfaz más sencilla que resuelva tu caso de uso real.
Comparativa de interfaces web de IA local
| Clasificación | Interfaz web | Ideal para | Conexión con modelos locales | Varios usuarios | Nivel de configuración |
|---|---|---|---|---|---|
| 1 | Open WebUI | La mejor interfaz general para laboratorios domésticos | Ollama y API compatibles con OpenAI | Sí | Fácil-moderado |
| 2 | LibreChat | Agentes, MCP y usuarios avanzados | Ollama y varios puntos de conexión de API | Sí | Moderado |
| 3 | LobeHub | Espacio de trabajo de IA personal y pulido | Ollama y amplia compatibilidad con proveedores | Con implementación en servidor | Moderado |
| 4 | AnythingLLM | Documentos privados y RAG listo para usar | Proveedores de LLM locales y en la nube | Sí, en la edición Docker | Fácil-moderado |
| 5 | text-generation-webui | Control de carga e inferencia de modelos | Backends de inferencia integrados | Limitado | Moderado-avanzado |
| 6 | Big-AGI | Comparación de varios modelos e investigación | Ollama, LM Studio, LocalAI, API | Sin cuentas nativas en la edición Open | Moderado |
| 7 | NextChat | Chat ligero y ágil | Puntos de conexión compatibles con OpenAI y LocalAI | Código de acceso básico | Fácil |
| 8 | SillyTavern | Interpretación de roles, personajes y control de instrucciones | Amplia variedad de API para modelos locales | Principalmente para uso personal | Moderado |
| 9 | Dify | Creación y publicación de aplicaciones de IA | Modelos locales mediante proveedores/plugins | Sí | Avanzado |
| 10 | Flowise | Agentes visuales y flujos de trabajo con LLM | Ollama y otros nodos de modelos | Controles de acceso disponibles | Avanzado |
La valoración de configuración abarca la interfaz y los servicios que la respaldan, no la inferencia del modelo. Ejecutar un modelo local grande puede requerir mucha más RAM o capacidad de GPU que la propia interfaz web.
Cómo clasificamos estas interfaces de IA locales
Priorizamos la utilidad para laboratorios domésticos por encima de la cantidad de funciones. Evaluamos cada interfaz según su compatibilidad con modelos locales, compatibilidad con Docker o autoalojamiento, facilidad de uso desde otros dispositivos de la LAN, funciones RAG y de agentes, gestión de usuarios, carga de mantenimiento y claridad de la documentación del proyecto sobre su implementación.
La privacidad también depende de la configuración. Una interfaz autoalojada puede seguir enviando instrucciones a API en la nube, servicios de búsqueda, puntos de conexión de telemetría o herramientas externas si los habilitas. Para una pila verdaderamente local, mantén el punto de conexión del modelo, los embeddings, la base de datos vectorial, los servicios de voz y el almacenamiento dentro de tu red. La guía de ZimaSpace sobre LLM locales privados explica toda la ruta de los datos.
1. Open WebUI — La mejor interfaz web general para IA local
Open WebUI es la opción predeterminada más segura para un laboratorio doméstico, ya que combina una experiencia de chat sencilla con suficiente profundidad para seguir siendo útil a medida que crece la configuración. Se conecta directamente a Ollama y a API compatibles con OpenAI, puede funcionar sin conexión y admite varios modelos sin vincular la interfaz a un único motor de inferencia.
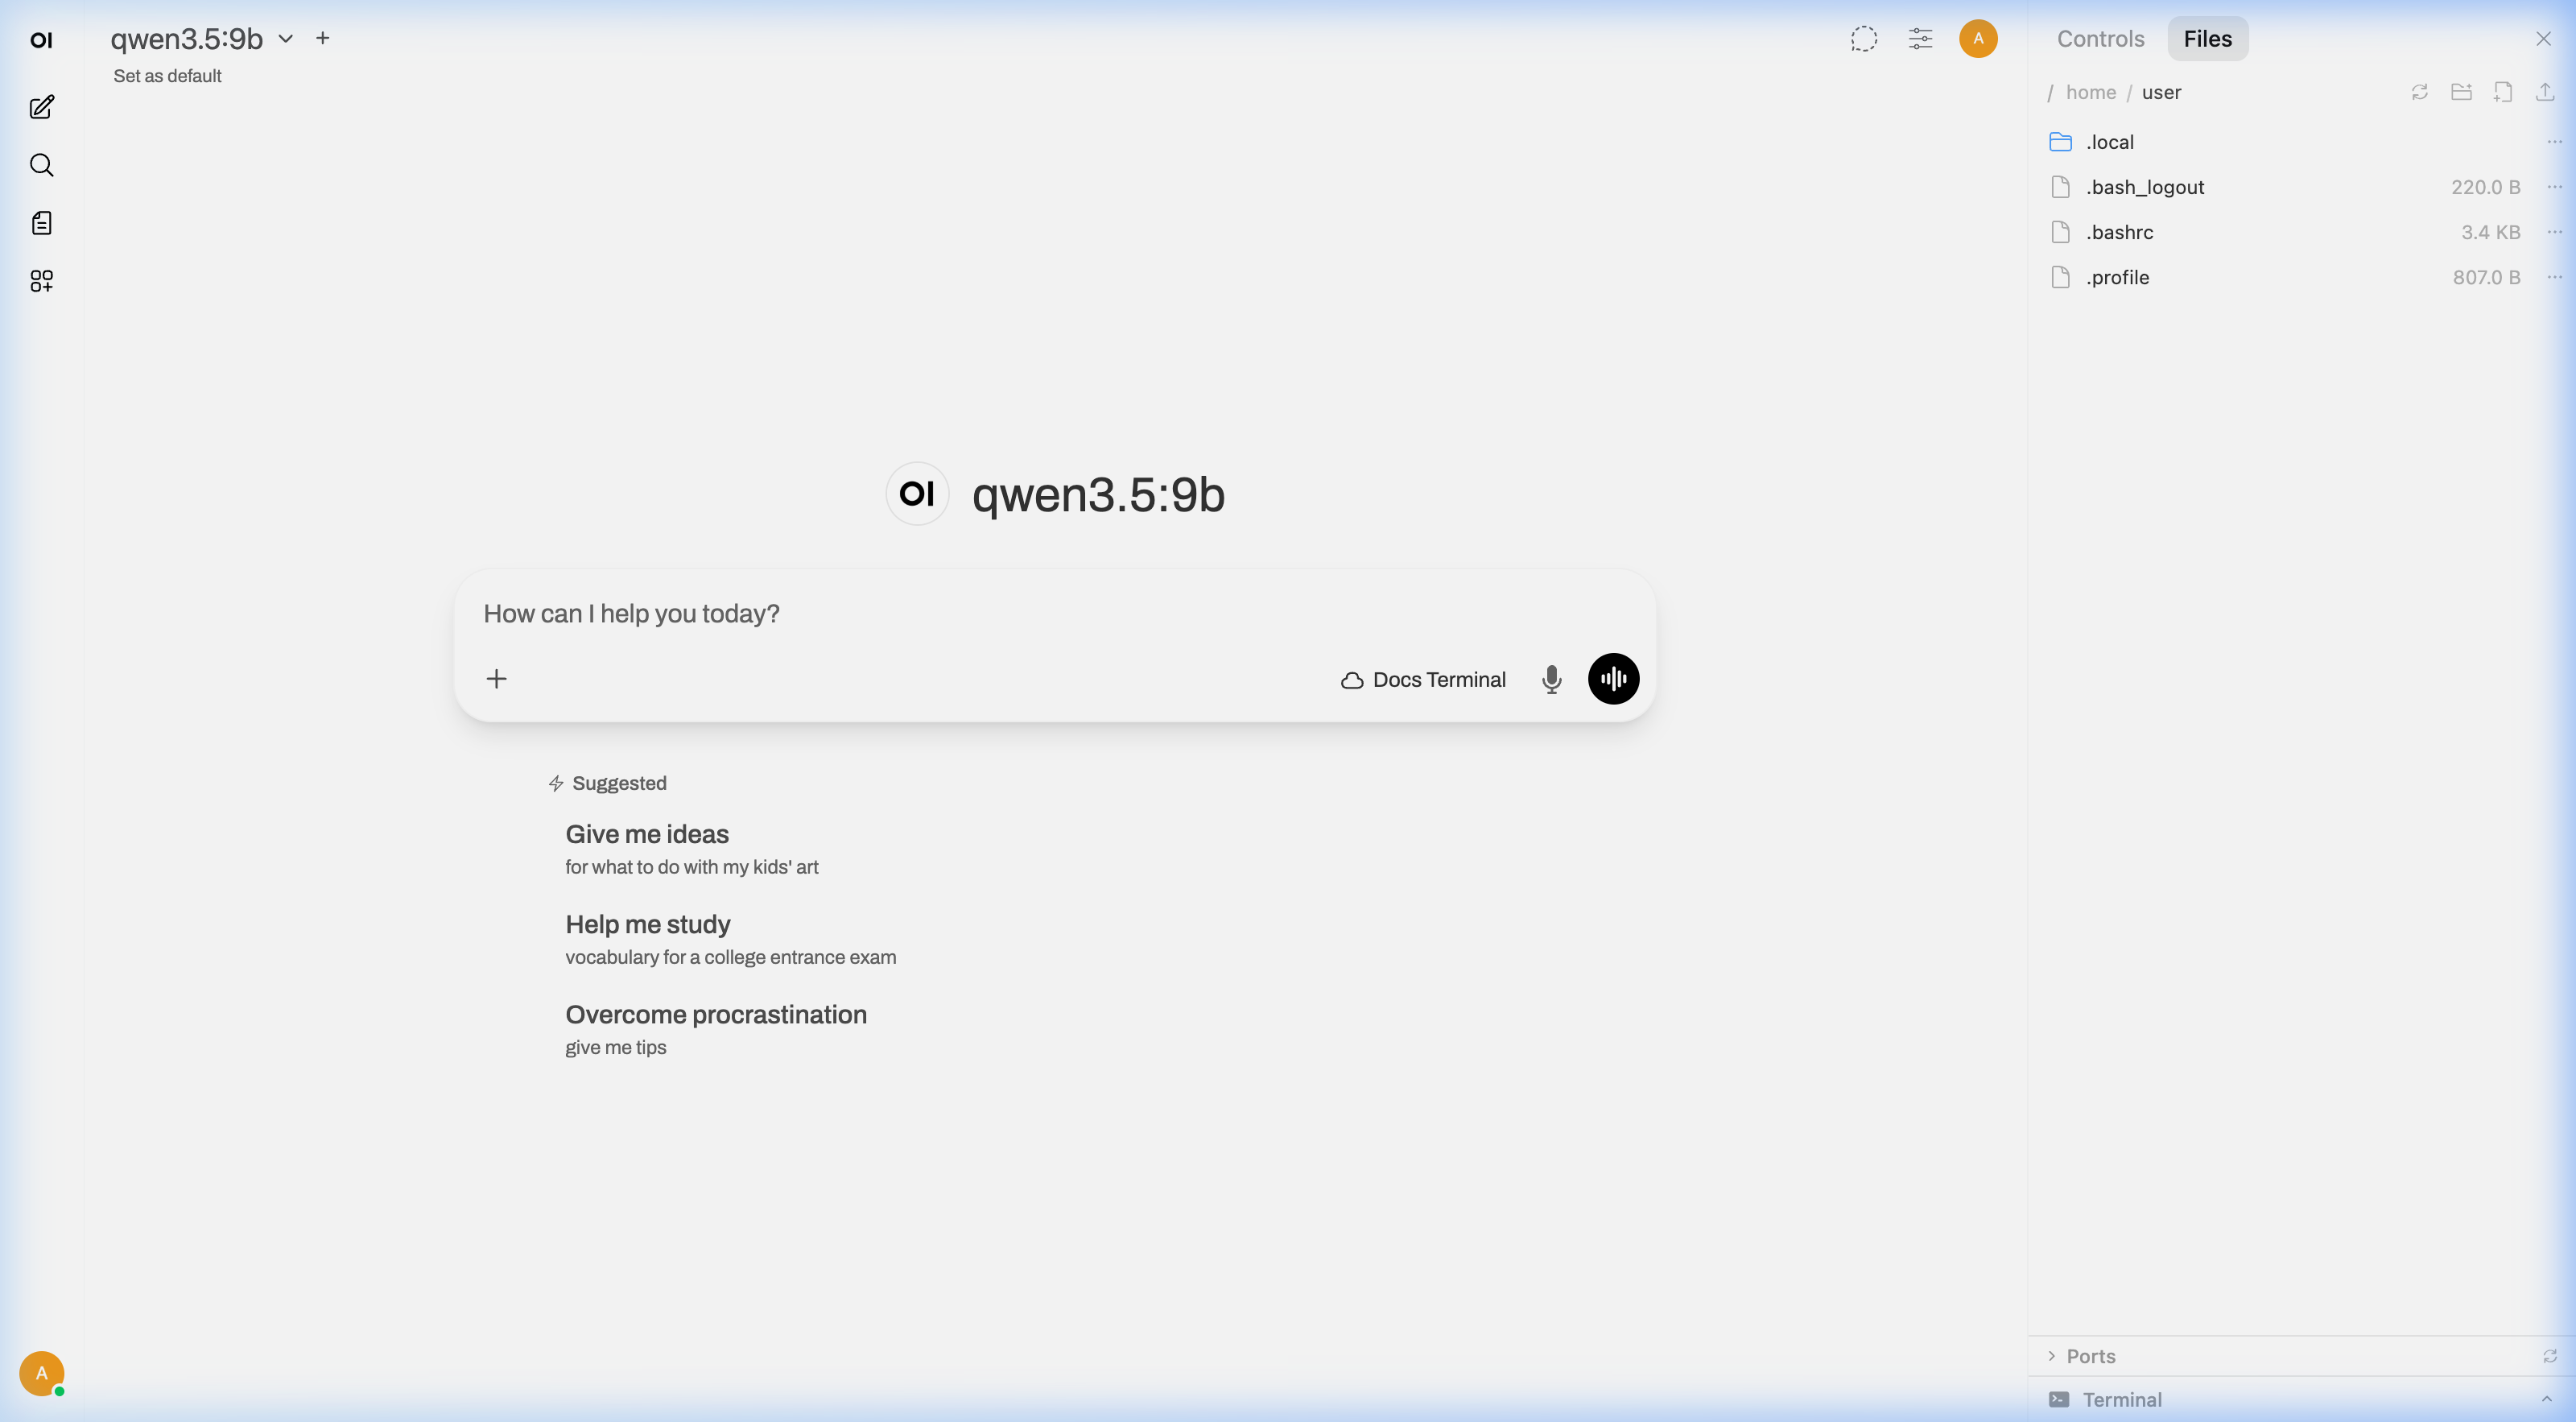
Sus funciones incluyen archivos e imágenes adjuntos, RAG, búsqueda web, ejecución de código, herramientas, memoria, chats con varios modelos y gestión de usuarios. Su principal inconveniente es la complejidad: cada función activada añade servicios, permisos y posibles rutas de red que hay que mantener.
- Ideal para: familias, aficionados particulares y servidores domésticos para varios usuarios.
- Elígelo cuando: quieras una interfaz similar a ChatGPT que funcione desde el primer momento y pueda ampliarse más adelante.
- Ten en cuenta: la configuración de red de Docker entre Open WebUI y un servicio Ollama en otro equipo.
2. LibreChat — El mejor para agentes y herramientas MCP
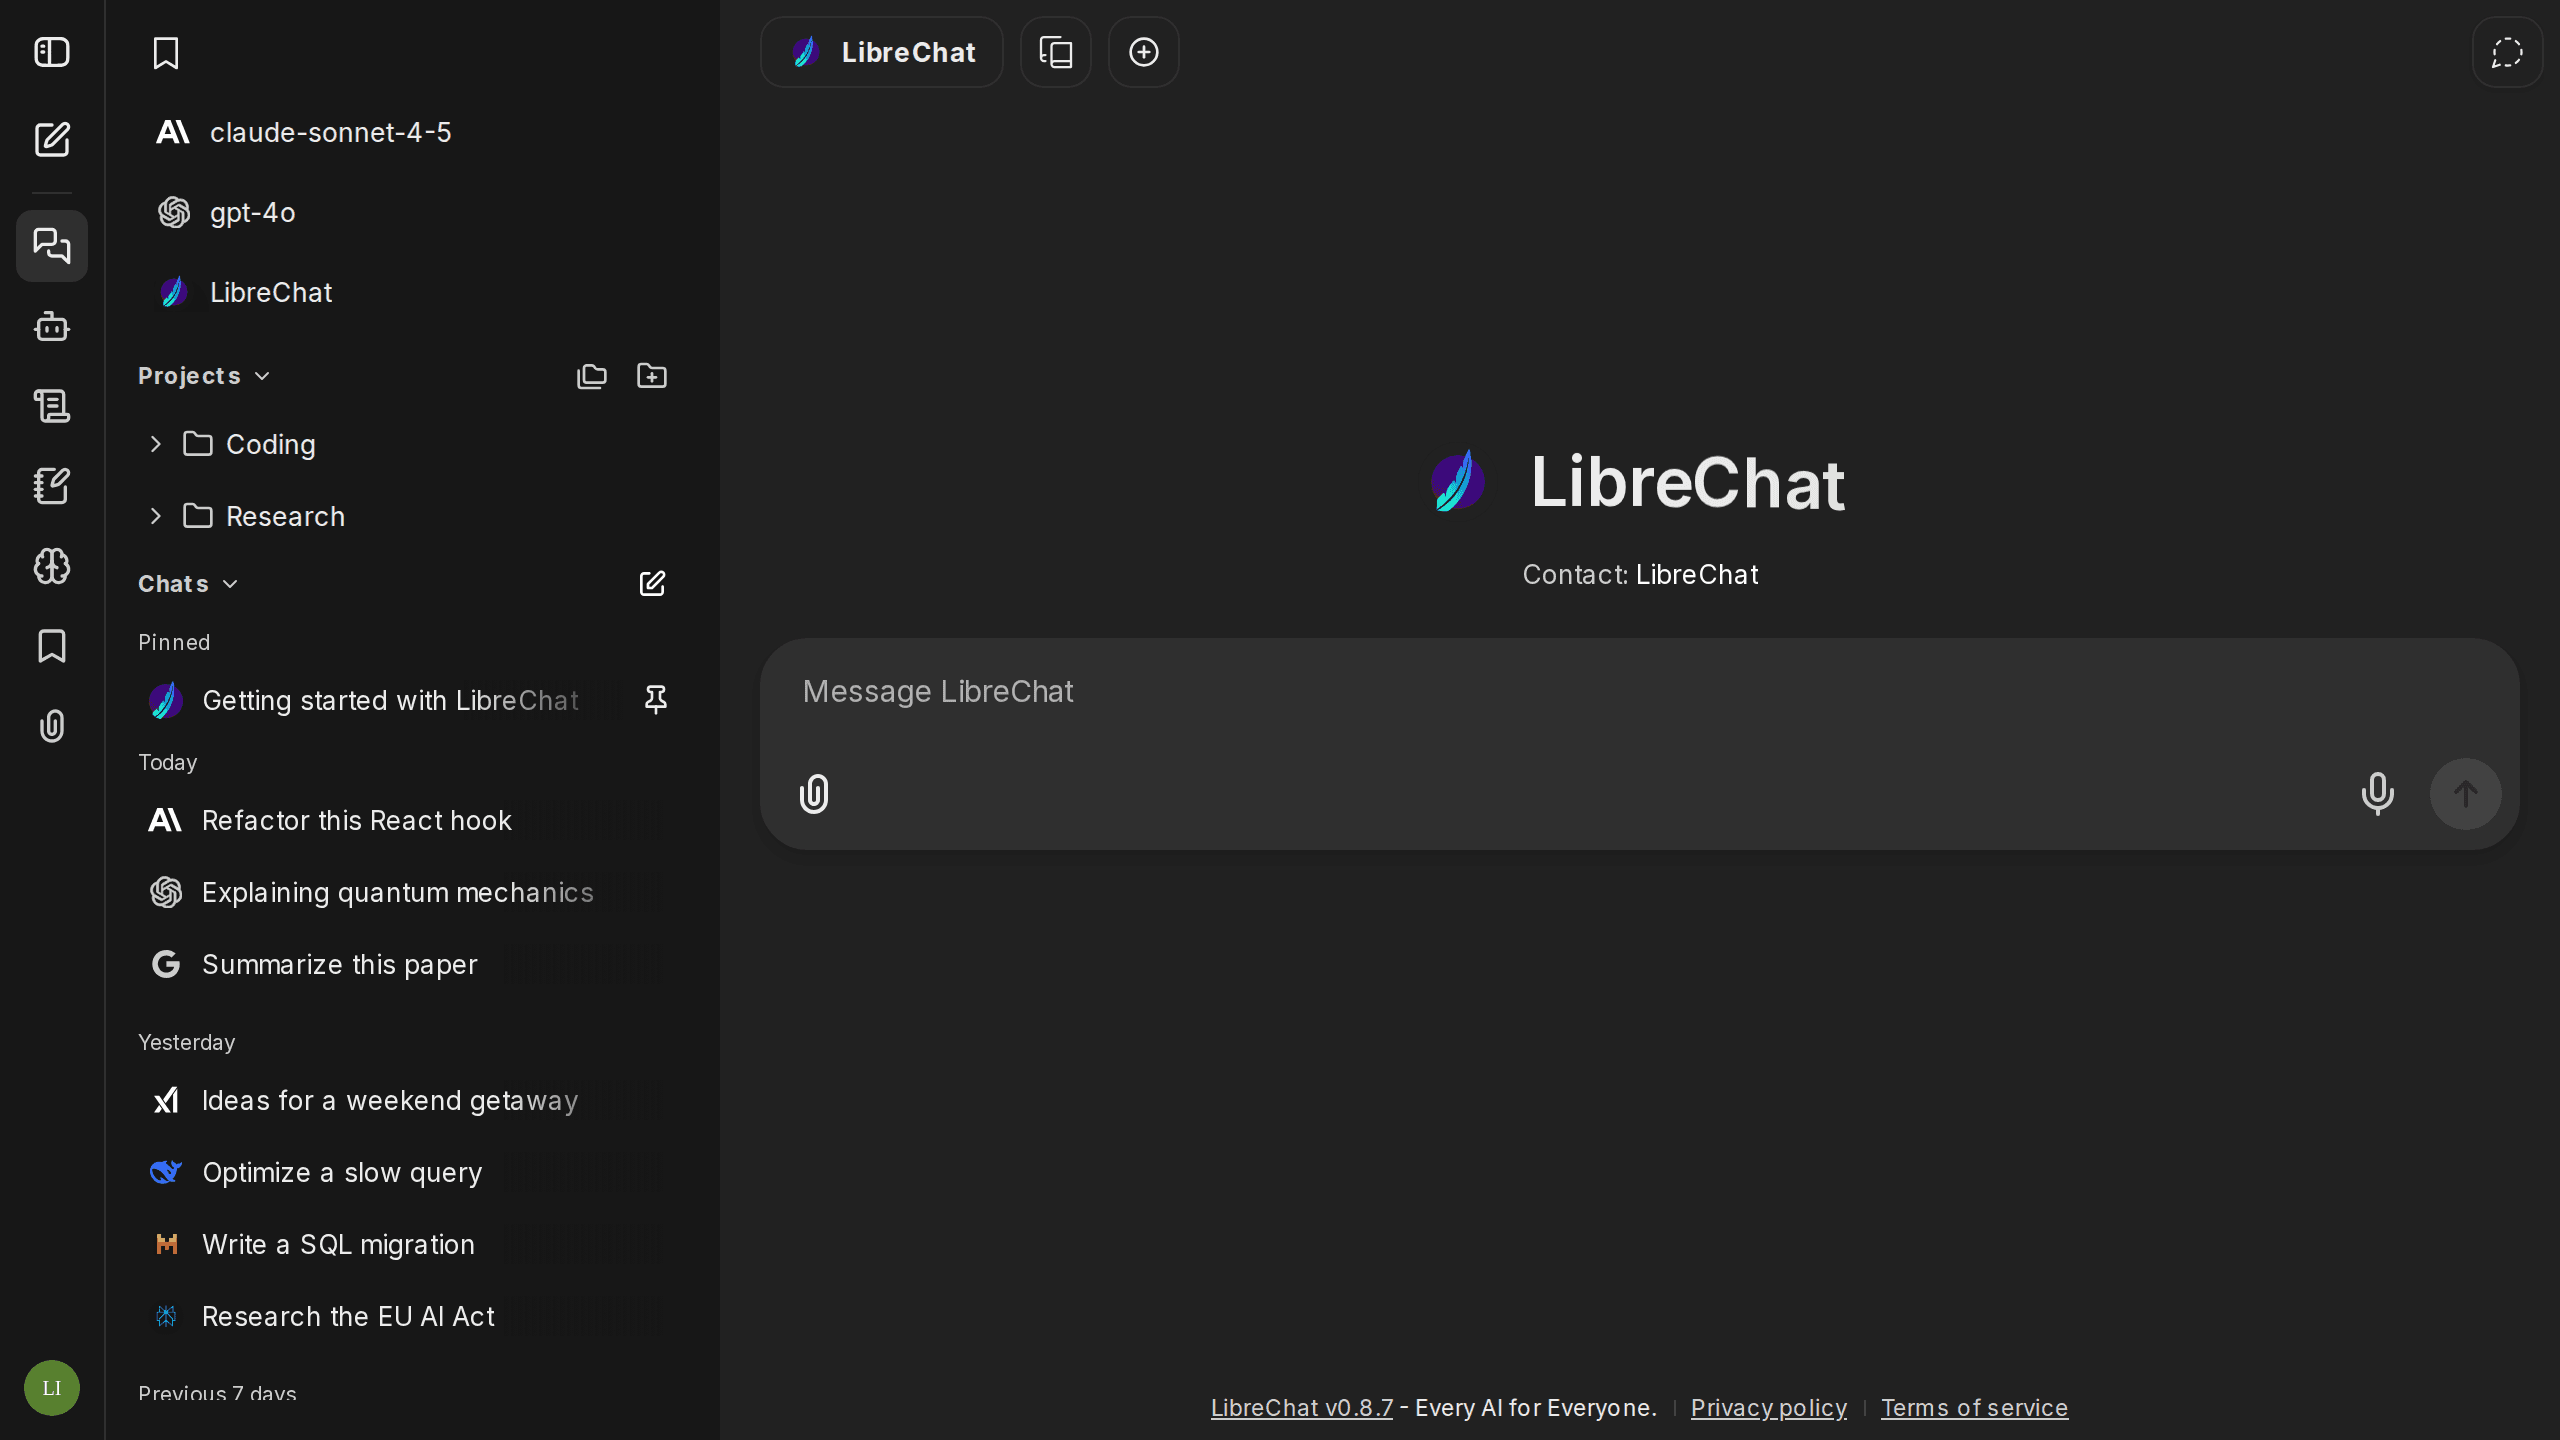
LibreChat es ideal para quienes quieren usar modelos locales y en la nube en una única interfaz de asistente completa. Entre sus funciones actuales se incluyen agentes, RAG, chat multimodal, ejecución de código, artefactos, búsqueda web, memoria persistente y amplias opciones de autenticación.
La característica más destacada es la integración del Protocolo de Contexto de Modelos. Los servidores MCP pueden estar disponibles directamente en el chat o asignarse a agentes específicos, lo que resulta útil para conectar un asistente privado con archivos, bases de datos, automatizaciones o servicios internos del laboratorio doméstico.
- Ideal para: quienes crean agentes, desarrolladores e instalaciones avanzadas para varios usuarios.
- Elígelo cuando: las herramientas y la flexibilidad entre proveedores sean más importantes que una configuración sencilla.
- Ten en cuenta: ofrece más opciones de configuración que las interfaces de chat ligeras.
3. LobeHub — El mejor espacio de trabajo personal de IA con un diseño cuidado
LobeHub, antes conocido como LobeChat, destaca por su interfaz refinada y la amplia compatibilidad con proveedores de modelos. Su integración con Ollama permite que los modelos alojados localmente aparezcan en el mismo espacio de trabajo moderno que los agentes y los modelos de proveedores.
También admite la carga de archivos y flujos de trabajo con bases de conocimiento, pero la implementación completa en servidor requiere más infraestructura de soporte que una interfaz que solo funciona en el navegador. Elígelo cuando la presentación, la organización de agentes y un espacio de trabajo personal completo importen más que minimizar la cantidad de contenedores.
- Ideal para: usuarios que valoran la calidad de la interfaz y los asistentes de IA organizados.
- Elígelo cuando: quieras acceder a Ollama local sin renunciar a un espacio de trabajo refinado.
- Ten en cuenta: las diferencias entre las implementaciones de cliente sencillas y las funciones completas respaldadas por bases de datos.
4. AnythingLLM — La mejor opción para documentos privados y RAG
AnythingLLM se centra en convertir archivos privados en espacios de trabajo de IA útiles. Combina la incorporación de documentos, las incrustaciones, el almacenamiento vectorial, el chat y los agentes en una sola aplicación, lo que reduce la cantidad de componentes que una persona principiante debe montar por separado.
La edición Docker admite acceso desde el navegador, varios usuarios, permisos de espacio de trabajo y conexiones a LLM locales. Es una mejor opción inicial que una interfaz de chat general si el requisito principal es hacer preguntas sobre manuales, notas, investigaciones o archivos domésticos.
- Ideal para: preguntas y respuestas sobre documentos y RAG local listo para usar.
- Elígelo cuando: los archivos sean el centro del flujo de trabajo.
- Ten en cuenta: las opciones de incrustaciones y bases de datos vectoriales, que afectan a la calidad de la recuperación independientemente del modelo de chat.
5. text-generation-webui — La mejor opción para controlar los modelos y la inferencia
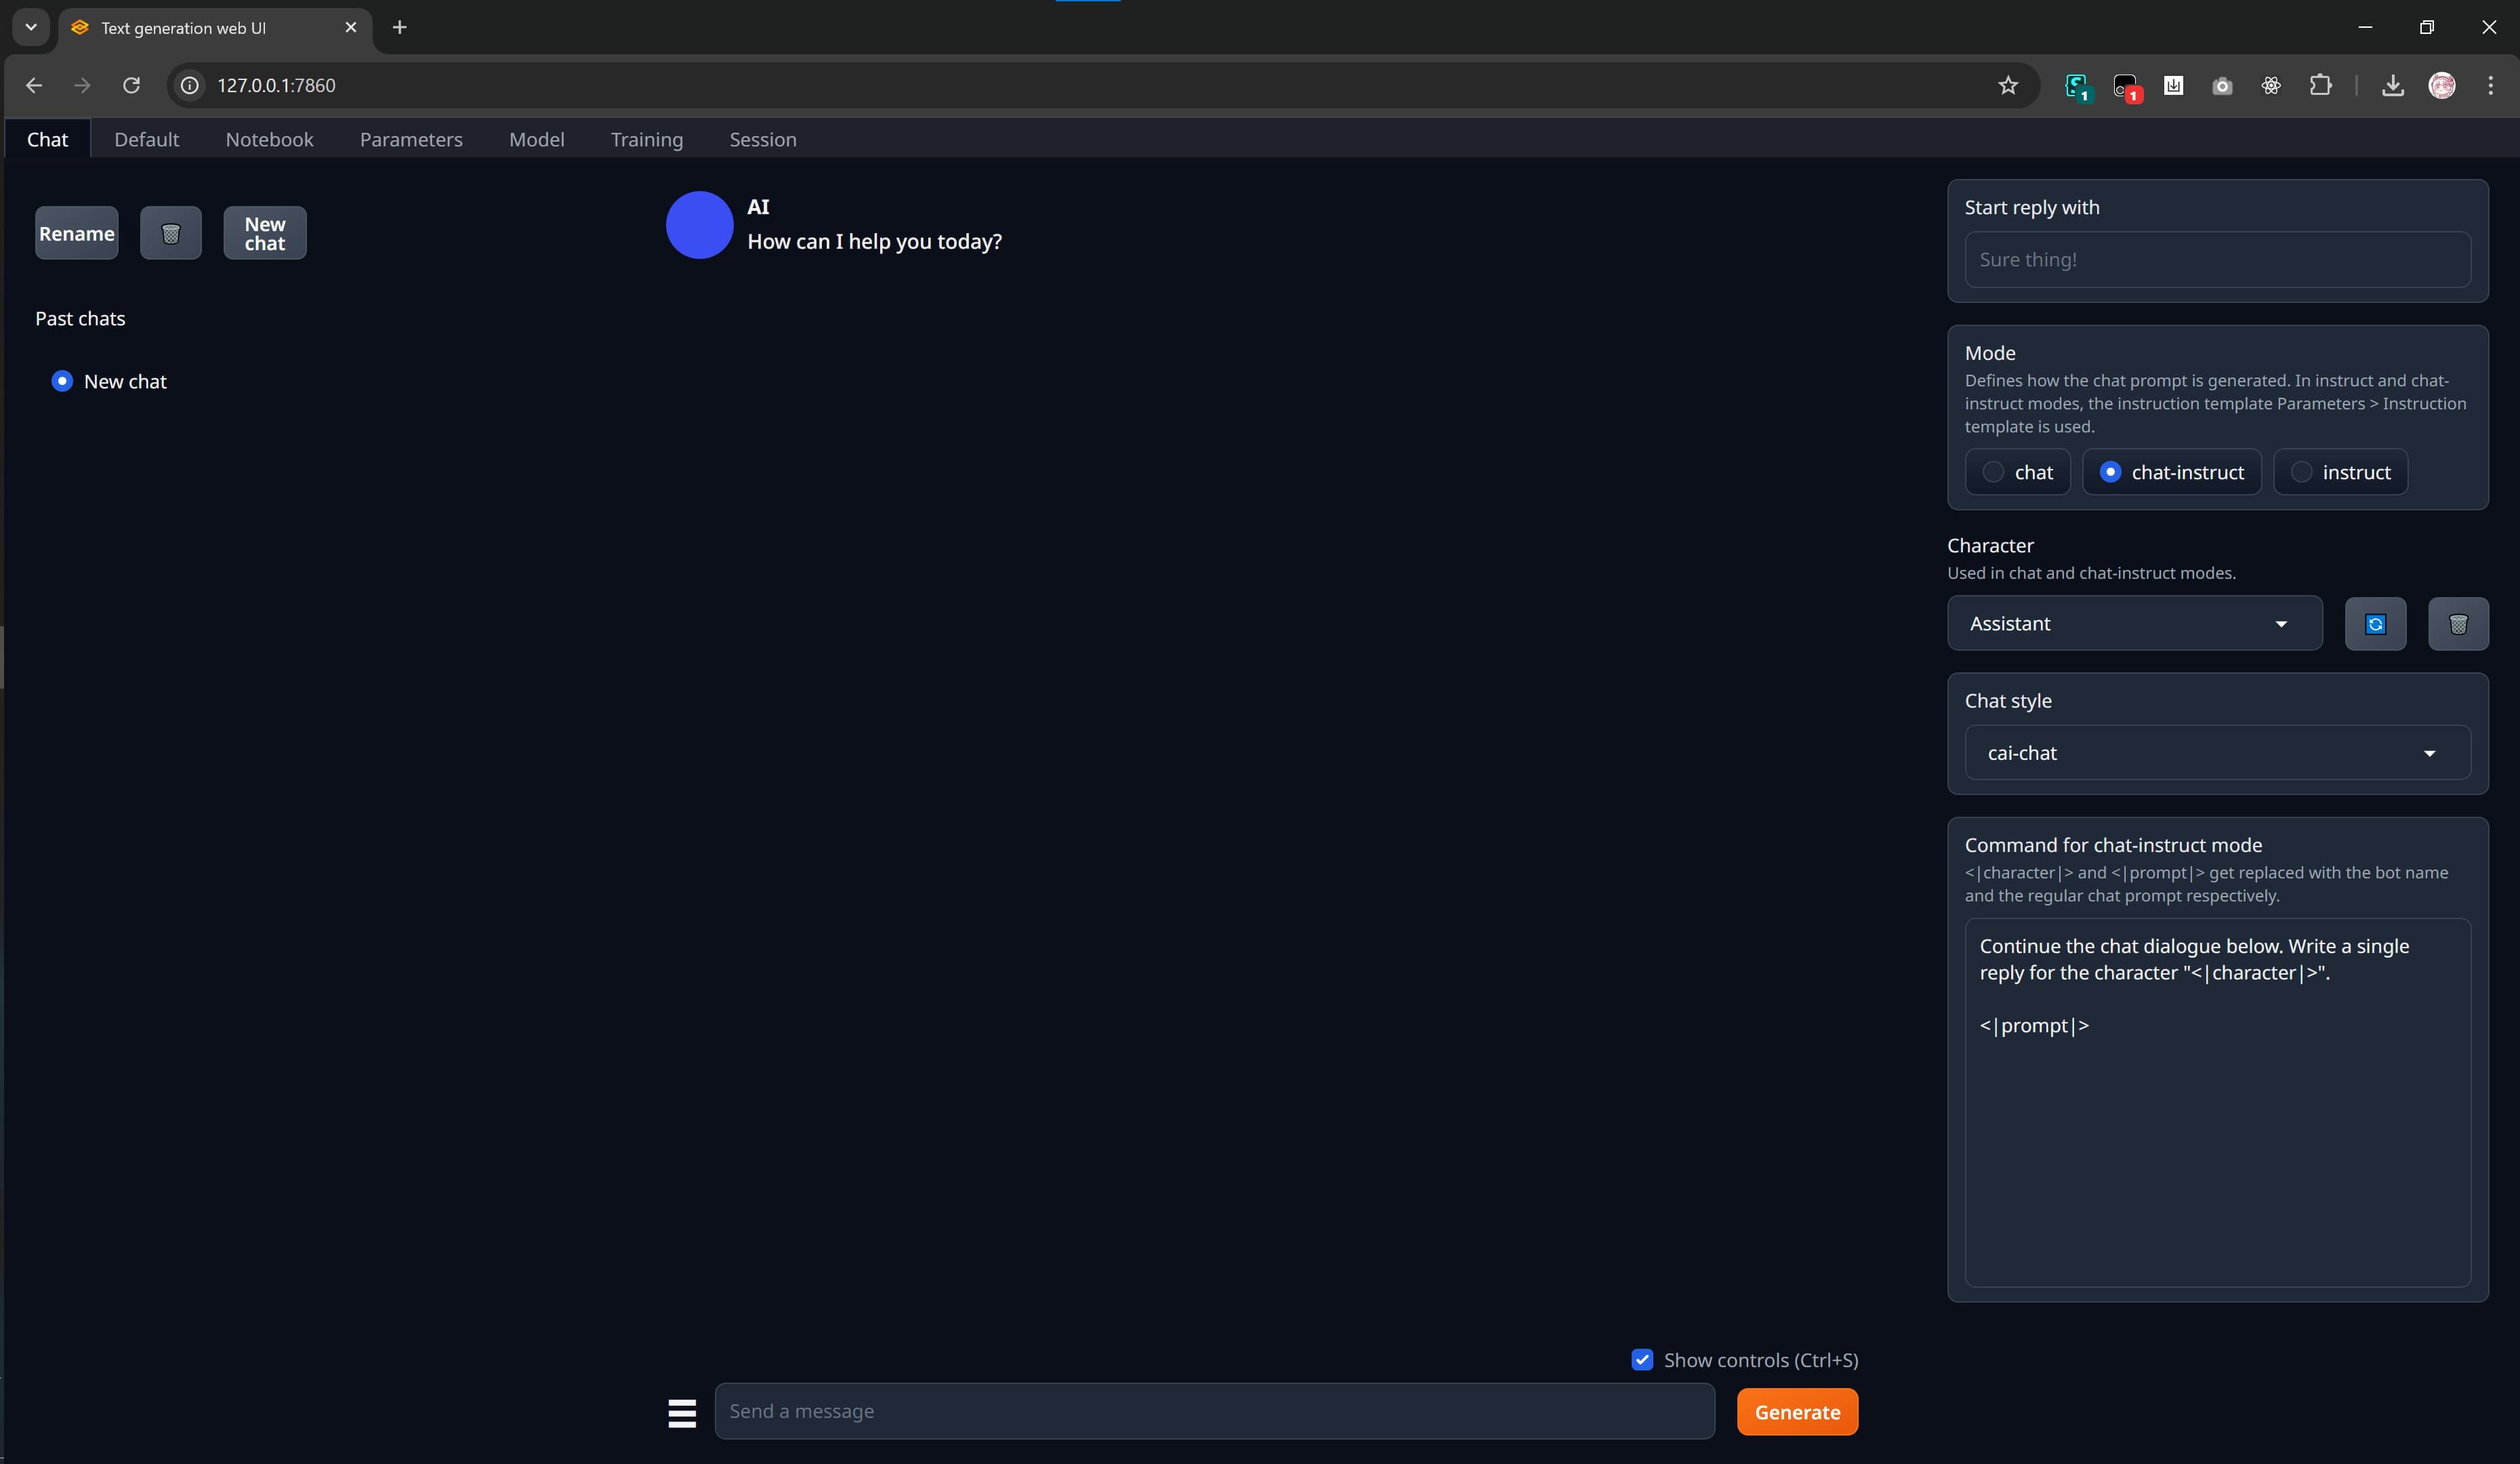
text-generation-webui es tanto una interfaz de navegador como un entorno flexible de inferencia local. Admite varios backends, como llama.cpp, Transformers, ExLlama y TensorRT-LLM, y ofrece carga de modelos, muestreo, plantillas de prompts, extensiones y una API compatible con OpenAI/Anthropic.
Esto lo hace útil para probar cuantizaciones o ajustar el comportamiento de generación antes de añadir otra interfaz. Es menos adecuado como portal doméstico, porque la administración multiusuario y la gestión integral del conocimiento no son sus puntos fuertes.
- Ideal para: entusiastas que comparan cargadores, formatos y ajustes de generación.
- Elígelo cuando: el control de la inferencia importe más que una experiencia multiusuario pulida.
- Ten en cuenta: no exponer una potente interfaz de gestión de modelos fuera de la LAN de confianza.
6. Big-AGI — Ideal para comparar varios modelos
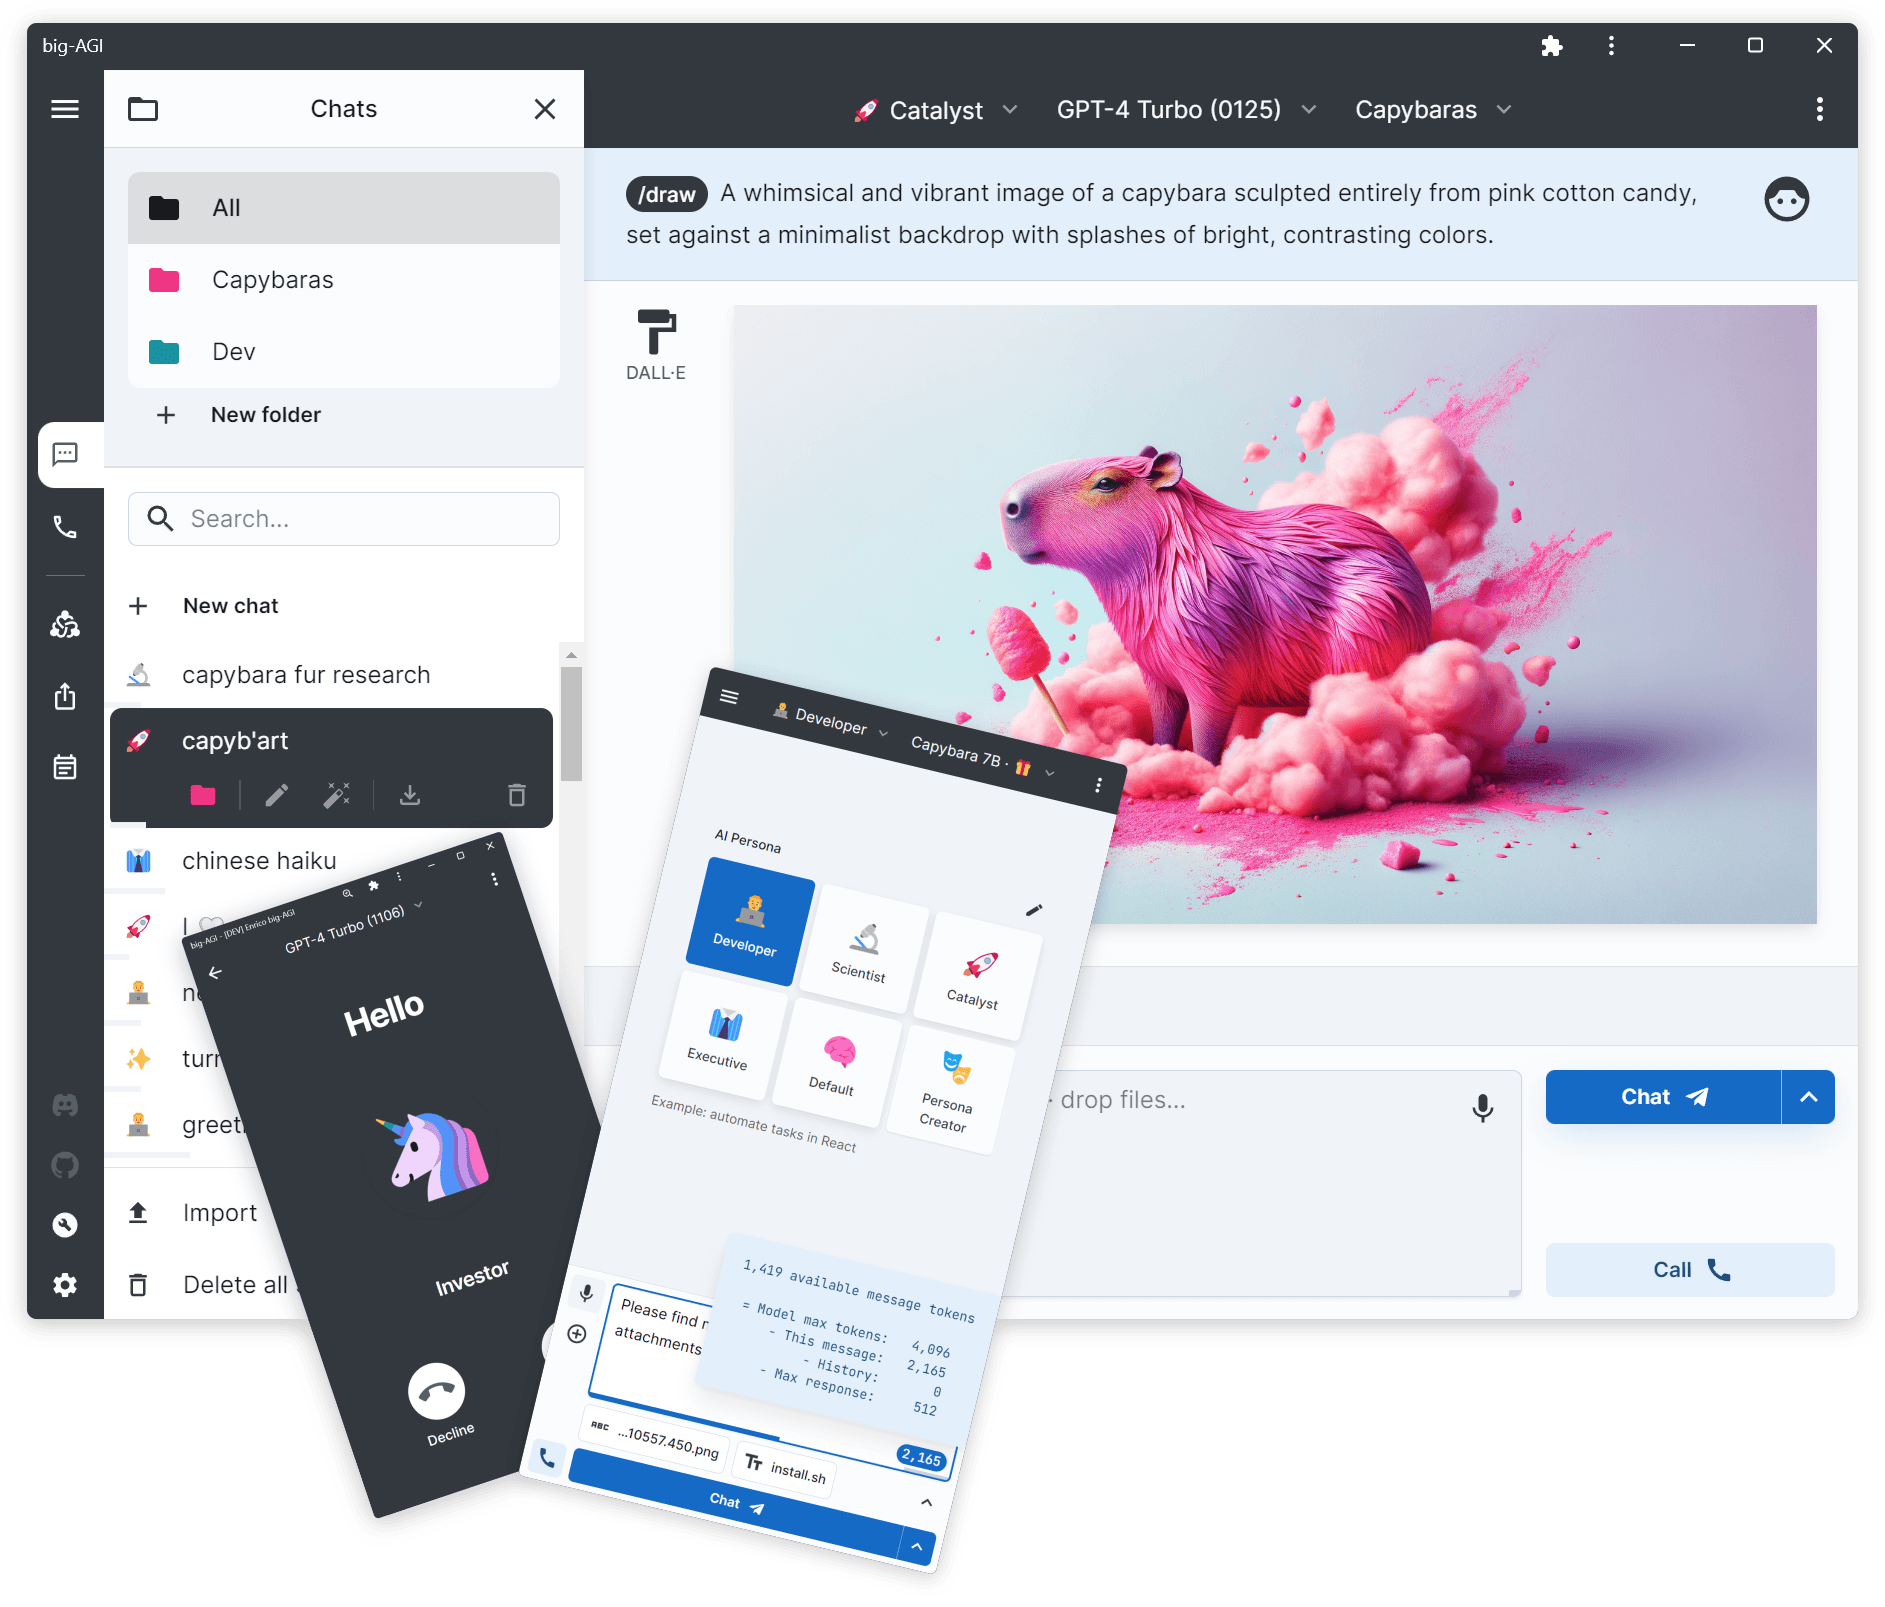
Big-AGI Open está diseñado como un espacio de trabajo multimodelo, no como un clon de chat de un único proveedor. Puede conectarse a Ollama, LM Studio, LocalAI y numerosos proveedores alojados, lo que permite combinar respuestas locales y en la nube en una interfaz orientada a la investigación.
Sus flujos de trabajo de comparación y síntesis son útiles cuando quieres que varios modelos aborden el mismo problema. La edición Open autoalojada no incluye cuentas de usuario nativas, por lo que es más adecuada para investigadores individuales que para implementarla en un hogar compartido, a menos que el acceso se gestione mediante un proxy inverso.
- Ideal para: investigación, comparación de modelos y trabajo híbrido entre local y la nube.
- Elígelo cuando: cambiar de modelo o compararlos sea fundamental para el flujo de trabajo.
- Ten en cuenta: que los proveedores en la nube pueden romper un flujo de datos que, por lo demás, sería local.
7. NextChat — La mejor interfaz ligera de IA local

NextChat es una interfaz de asistente pequeña, rápida y adaptable que se puede implementar con Docker o como aplicación web. Es compatible con URL base de API personalizadas, modelos implementados por cuenta propia mediante endpoints compatibles, máscaras de prompt, respuestas en streaming, uso como PWA y compatibilidad opcional con MCP.
Es una opción atractiva cuando el servidor doméstico debe dedicar sus recursos a la inferencia en lugar de a una pila de frontend pesada. Su mecanismo de código de acceso es más sencillo que la gestión integral de identidades y permisos multiusuario, así que usa un proxy inverso seguro si hay varias personas implicadas o acceso remoto.
- Ideal para: chatear con pocos recursos en teléfonos, tabletas y servidores antiguos.
- Elígelo cuando: la velocidad y la simplicidad sean más importantes que la RAG integrada.
- Ten en cuenta: no considerar un código de acceso compartido como una capa de seguridad completa.
8. SillyTavern — Ideal para personalidades y control de prompts

SillyTavern es una interfaz de navegador instalada localmente, dirigida a usuarios que quieren un control detallado de los personajes, las personalidades, la creación de prompts, el trasfondo, los ajustes de generación, la conversión de texto a voz y las conexiones para generar imágenes. Puede conectarse a una amplia variedad de API locales de generación de texto.
Aunque es más conocido por los juegos de rol y la escritura creativa, su Banco de datos añade conocimientos basados en recuperación a las instrucciones. La interfaz tiene una curva de aprendizaje más pronunciada y está diseñada principalmente para uso personal, pero pocas alternativas ofrecen el mismo nivel de control sobre las conversaciones y los personajes.
- Ideal para: escritura creativa, juegos de rol, personajes y creación avanzada de instrucciones.
- Elígelo cuando: sea esencial controlar cómo se construyen las instrucciones.
- Ten en cuenta: la densidad de las opciones de configuración y las extensiones de terceros.
9. Dify — La mejor opción para crear aplicaciones de IA autoalojadas
Dify requiere más recursos que una interfaz de chat típica porque es una plataforma de aplicaciones de IA. Ofrece orquestación visual, bases de conocimiento, agentes, flujos de trabajo, complementos, registros y aplicaciones web publicables, todo ello con modelos locales o remotos.
La implementación oficial con Docker Compose inicia numerosos servicios principales y complementarios, por lo que Dify es más adecuado para un servidor doméstico potente que para un sistema pequeño de placa única. Elígelo cuando quieras diseñar herramientas familiares reutilizables o aplicaciones internas, no solo sustituir una página de chat.
- Ideal para: crear, probar y publicar aplicaciones de IA.
- Elígelo cuando: los flujos de trabajo, las canalizaciones de conocimiento y las interfaces reutilizables justifiquen la carga adicional.
- Ten en cuenta: la cantidad de contenedores, las copias de seguridad de las bases de datos, las actualizaciones y el uso de recursos.
10. Flowise — La mejor interfaz visual para flujos de trabajo de IA
Flowise es una plataforma visual para crear flujos de chat, flujos de agentes, herramientas, componentes de recuperación y conexiones con modelos. Admite implementaciones autoalojadas y aisladas de la red, y puede conectarse a modelos locales mediante componentes como Ollama.
Flowise forma parte de esta lista porque su creador visual y sus interfaces de chat integrables son útiles en un laboratorio doméstico, pero no es el mejor cliente de chat de uso diario para todo propósito. Se gana un lugar cuando la interfaz está pensada para diseñar la lógica del asistente.
- Ideal para: crear prototipos visuales de agentes y flujos RAG.
- Elígelo cuando: quieras crear flujos sin tener que programar toda la aplicación.
- Ten en cuenta: proteger las credenciales, los puntos de conexión de los flujos y los permisos de las herramientas.
¿Qué interfaz web de IA local deberías elegir?
- Elige Open WebUI para disfrutar de la mejor experiencia general en un laboratorio doméstico.
- Elige LibreChat para usar herramientas MCP, agentes y varios proveedores de forma avanzada.
- Elige LobeHub para disfrutar de un espacio de trabajo personal cuidado.
- Elige AnythingLLM cuando los documentos privados y la generación aumentada por recuperación (RAG) sean prioritarios.
- Elija text-generation-webui si necesita controlar directamente la carga de modelos y la inferencia.
- Elija Big-AGI para comparar modelos locales y en la nube en un mismo espacio de trabajo.
- Elija NextChat para una interfaz de chat ligera.
- Elija SillyTavern para personalidades, juegos de rol e ingeniería de prompts.
- Elija Dify o Flowise si está creando una aplicación o un flujo de trabajo de IA.
Una arquitectura práctica para un laboratorio doméstico
Una configuración fiable separa cuatro capas: la interfaz web, el servidor de inferencia, la capa de datos y el acceso remoto. La interfaz puede ejecutarse en un contenedor Docker pequeño, mientras que Ollama, llama.cpp u otro entorno de ejecución aprovecha el host con GPU. Los documentos, archivos de modelos, bases de datos y copias de seguridad pueden permanecer en un NAS, mientras que un proxy inverso o una VPN privada controla el acceso desde el navegador.
Esta separación facilita las actualizaciones y evita que un fallo del frontend afecte a los modelos almacenados o a los archivos privados. También permite que un servidor de bajo consumo permanezca en línea las 24 horas del día, mientras que una máquina con GPU solo se enciende cuando se necesita una inferencia exigente. La comparación entre un laboratorio de IA compacto y un NAS completo con IA muestra cómo se pueden dividir esas funciones.
Ejecutar una interfaz web de IA local en hardware Zima
ZimaBoard 2 es un host práctico, siempre encendido, para interfaces web ligeras, proxies inversos, autenticación, bases de datos pequeñas y orquestación. Puede conectarse en red a Ollama u otro servidor de inferencia con una GPU dedicada. Es posible usar modelos pequeños de CPU, pero su función principal es coordinar servicios, no sustituir una estación de trabajo de IA de gama alta.
ZimaCube 2 ofrece almacenamiento ampliable para pesos de modelos, bases de conocimiento, archivos cargados y copias de seguridad. Eso lo convierte en una capa de datos ideal para Open WebUI, AnythingLLM, LibreChat, Dify o Flowise. Para ver un ejemplo detallado, descubra cómo un flujo de trabajo de NAS con IA de ZimaCube 2 combina almacenamiento con funciones de búsqueda privada y asistente.
Lista de verificación de seguridad antes de exponer la interfaz
- No redirija directamente el puerto de la aplicación a Internet. Use una VPN o un proxy inverso con TLS y autenticación sólida.
- Cree cuentas de usuario separadas cuando sea posible. No compartan una sesión de administrador en el hogar.
- Restrinja los endpoints de modelos y herramientas. Ollama, las bases de datos, los servidores MCP y los servicios de ejecución de código deben permanecer en redes de confianza.
- Conserva y haz copias de seguridad de los datos de la aplicación. El historial de chats, los almacenes vectoriales, la configuración y los documentos subidos deben mantenerse al sustituir el contenedor.
- Revisa las conexiones salientes. Los modelos en la nube, las búsquedas web, los proveedores de servicios de voz, los complementos y la telemetría pueden enviar datos fuera del laboratorio doméstico.
- Actualiza con criterio. Fija versiones de contenedor que sepas que funcionan, lee las notas de migración y conserva una copia de seguridad lista para revertir los cambios.
Si estás decidiendo entre contenedores e instalación directa, la guía sobre Docker y las aplicaciones de IA local nativas explica el aislamiento, el acceso a la GPU, las actualizaciones y la resolución de problemas.
Preguntas frecuentes
¿Cuál es la mejor interfaz web para Ollama?
Open WebUI es la opción predeterminada más adecuada para la mayoría de los usuarios de Ollama, ya que ofrece una conexión sencilla, varios usuarios, RAG, herramientas, archivos adjuntos y una interfaz apta para el uso diario. NextChat es más ligero, mientras que LibreChat destaca más en agentes e integraciones de MCP.
¿Puede una interfaz web de IA local ejecutarse en una máquina distinta de la del modelo?
Sí. La interfaz web puede ejecutarse en un servidor doméstico de bajo consumo y conectarse por la LAN a Ollama, vLLM, LocalAI u otro servicio de inferencia compatible en una máquina con GPU. Suele ser el diseño más eficiente para un laboratorio doméstico.
¿Alojar la interfaz en un servidor propio garantiza la privacidad?
No. La privacidad depende de todos los puntos de conexión configurados. Una interfaz local conectada a un modelo en la nube o a un proveedor de búsquedas externo aún puede transmitir instrucciones y archivos. Audita las API de modelos, las incrustaciones, las herramientas, los servicios de voz, los complementos y los registros.
¿Qué interfaz es mejor para chatear con documentos privados?
AnythingLLM es la opción integral más especializada para RAG basado en documentos. Open WebUI y LibreChat son mejores si el chat con documentos es una función más entre muchas, mientras que Dify y Flowise son adecuados para crear flujos de recuperación personalizados.
¿Necesito una GPU para alojar la interfaz web?
No. La interfaz suele ejecutarse en la CPU. El servidor del modelo usa una GPU y puede estar en la misma máquina o en otro sistema. Esta separación permite que un servidor eficiente aloje la interfaz de forma continua.
Veredicto final
Open WebUI es el mejor punto de partida para la mayoría de los laboratorios domésticos de IA local, porque combina facilidad de uso, compatibilidad con modelos locales, RAG, herramientas y acceso multiusuario. Elige LibreChat para instalaciones centradas en agentes, AnythingLLM para documentos privados, text-generation-webui para controlar la inferencia y Dify o Flowise para crear aplicaciones. La interfaz adecuada es la que ofrece las funciones que necesitas sin convertir un servicio doméstico privado en una plataforma innecesariamente compleja.

Productos recomendados


Centro de tecnología e IA
Más para leer
Fijación de la versión de embeddings: por qué los vectores de consultas y documentos deben seguir siendo compatibles
Una explicación centrada en el mecanismo sobre la fijación de versiones de embeddings, sus ventajas y desventajas en cuanto a recursos compartidos, tres preguntas...
Almacenamiento de modelos direccionado por contenido: cómo los hashes evitan descargas duplicadas de pesos
Una explicación centrada en el mecanismo del almacenamiento de modelos direccionado por contenido, sus ventajas y desventajas como recurso compartido, tres preguntas frecuentes sobre...
Acciones de compensación de agentes: cómo los pasos reversibles limitan los fallos parciales del flujo de trabajo
Una explicación centrada en los mecanismos de las acciones de compensación de los agentes, sus concesiones en recursos compartidos, tres preguntas frecuentes sobre la...


