
Återställningspunktskataloger: Så bygger beroendemanifest upp en privat AI-stack på nytt


Den observerbara effekten uppstår vanligtvis eftersom katalogposter knyter samman modell-, index-, metadata-, konfigurations- och hemlighetsversioner, medan delade resurser och tidsförlopp avgör hur stor effekten blir i praktiken.
I ett arbetsflöde för en hemmaserver kan kataloger över återställningspunkter påverka både interaktivt beteende och resursanvändning i bakgrunden. Effekten blir synlig först efter att begäran passerat genom flera bearbetningssteg, så ett enda genomsnittsvärde kan dölja var fördröjningen, kvalitetsförlusten eller felet började. Genom att separera transport, beräkning, lagring och applikationstillstånd går sambandet att testa under i övrigt identiska förhållanden.
Så når kataloger över återställningspunkter det lager som användaren märker
Effekten som användaren märker uppstår längre fram i kedjan än detta villkor: katalogposter knyter samman modell-, index-, metadata-, konfigurations- och hemlighetsversioner. Det steget ändrar vad nästa komponent tar emot, så det observerade resultatet kan inte tillskrivas enbart det slutliga gränssnittet eller modellen. Genom att hålla indata och arbetsbelastning konstanta blir denna tidiga omvandling synlig.
Modellen för sökning efter sökvägens MTU ger ett konkret sätt att tolka detta steg: katalogposter knyter samman modell-, index-, metadata-, konfigurations- och hemlighetsversioner. Det praktiska värdet ligger i att skilja den ändrade variabeln från senare effekter av buffring, schemaläggning, lagring eller rendering, som kan ge liknande symptom.
När det första steget ändras väljer beroendemanifest kompatibla artefakter vid återuppbyggnad. Konsekvensen kan visa sig som latens, noggrannhet, energiförbrukning, kapacitet eller upplevd jämnhet, beroende på artikelns frågeställning, men orsakskedjan börjar fortfarande innan det slutliga resultatet visas.
Resurskopplingen bakom resultatet
Resurskoppling spelar roll eftersom beroendemanifest väljer kompatibla artefakter vid återuppbyggnad. Samtidiga AI-, lagrings-, media- eller automatiseringsjobb kan därför förstärka en effekt som verkar liten i ett enskilt anropstest. Svansbeteendet är viktigare än ett genomsnitt för ett inaktivt system.
Mekanismen för identifiering av paketstorlek kopplar lagret med delade resurser till resultatet: beroendemanifest väljer kompatibla artefakter vid återuppbyggnad. Genom att mäta detta lager separat undviker man att förväxla dataflöde, cacheträffar, bekräftelser eller optimistiska statusuppdateringar med slutfört arbete som användaren faktiskt märker.
Samspelet fortsätter eftersom katalogernas korrekthet beror på att de refererade objekten testas före en katastrof. Därför kan två hemmaservrar med samma övergripande maskinvara eller nätverkshastighet bete sig olika när ködjup, datalayout, cachetillstånd eller policy skiljer sig åt.
Fall där kataloger över återställningspunkter inte är avgörande
Den påstådda effekten gäller inte universellt. I det här fallet återskapas hela stacken från källkod utan någon tidsbegränsning för återställningen. En annan flaskhals kan sätta taket innan en ändring av återställningspunktkatalogerna blir mätbar.
Sambandet med DNS-meddelandebehandling hjälper till att skilja den förväntade mekanismen från en konkurrerande förklaring. I ett kontrollerat test måste källdata, maskinvara, samtidighet, cachestatus och programvaruversioner hållas konstanta, samtidigt som endast titelvariabeln ändras.
Felgränsen nås när hela stacken återskapas från källkod utan någon tidsbegränsning för återställningen. Efter den punkten kan mer aggressiv finjustering öka kostnader, risker eller instabilitet utan att förbättra det resultat som utlovas i titeln.

Vanliga frågor om återställningspunktkataloger
Är återställningspunktkataloger den huvudsakliga flaskhalsen?
Inte automatiskt. Det är den huvudsakliga flaskhalsen endast om en ändring av den påverkar resultatet, samtidigt som beroendemanifest väljer kompatibla artefakter vid ombyggnad och övriga förhållanden hålls konstanta. Om resultatet inte påverkas är det ett annat steg som sätter taket.
Kan cachning dölja effekten av återställningspunktkataloger?
Ja. Varma cacheminnen, kvarhållna sessioner, modeller i minnet, buffrade medier och optimistiska gränssnittsuppdateringar kan kringgå steget som undersöks. Kalla och varma körningar bör redovisas separat. Detta beroende bör synliggöras i ett upprepningsbart test på en hemmaserver.
Vilket mätvärde för återställningspunktkataloger är viktigast?
De användbara mätvärdena är katalogtäckning, saknade objekt, RPO och RTO. Medelvärden bör kompletteras med svanslatens, fel, kvalitet eller resurskostnad, så att ett resultat som ser jämnare ut inte misstas för ett bättre system. Resultatet måste utvärderas separat från intilliggande steg i pipelinen.
Kör ett kontrollerat test av återställningspunktkataloger
Skapa en representativ arbetsbelastning och dokumentera katalogtäckning, saknade objekt, RPO och RTO innan du ändrar återställningspunktkatalogerna. Kör kalla och varma tester, inkludera realistisk samtidighet och använd samma data, versioner, maskinvara och användarsynliga framgångskriterium i varje jämförelse.
Använd den relaterade mekanismen i återställningspunktkataloger för att fastställa förväntad riktning före testningen. Ändra en variabel i taget, dokumentera median- och svansbeteende och behåll det misslyckade eller försämrade fallet så att resultatet omfattar dess operativa gräns.
Tillämpa ändringen endast när den uppmätta nyttan kvarstår i upprepade försök och den angivna gränsen fortfarande är acceptabel. Om ett annat steg är den dominerande flaskhalsen ska du låta återställningspunktkatalogerna vara oförändrade och i stället testa den konkurrerande flaskhalsen, inte dra slutsatser om orsakssamband utifrån korrelation.

Rekommenderade produkter

Teknik- och AI-hubb
Mer att läsa
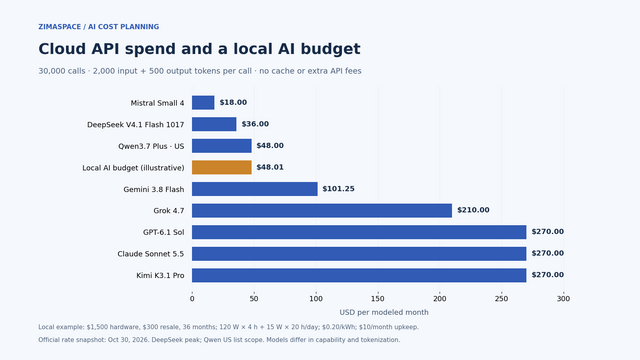
Cloud AI API Pricing vs Local AI: What Does Your Workload Really Cost?
Compare cloud API token charges with local AI hardware, electricity and upkeep. Work through a monthly example and use the free ZimaSpace cost calculator.

Problemet med den första hemligheten: Varför en AI-agent för hemmet fortfarande behöver en ursprunglig förtroenderot
En mekanismbaserad förklaring av problemet med hemlighet noll, avvägningarna kring delade resurser, tre vanliga frågor om frågespridning och ett praktiskt verifieringsprotokoll.
Arbetsbelastningsidentitetsfederering: Så undviker lokala tjänster delade API-nycklar
En mekanismfokuserad förklaring av federation för arbetsbelastningsidentitet, avvägningarna kring delade resurser, tre vanliga frågor om frågespridning och ett praktiskt verifieringsprotokoll.


