
Laya-modellen förklarad: Den öppen källkodsbaserade beslutsmodellen du kan köra lokalt


Laya är inte ännu en liten språkmodell som försöker bli en billigare ChatGPT. Den genererar inte stycken text token för token. I stället tar den emot ett tillstånd - till exempel ett e-postmeddelande, ett supportärende, ett agentspår eller ett JSON-objekt - och returnerar strukturerade beslut med sannolikheter.
Det placerar Laya i samma framväxande kategori som TypeSafes Jev, men med en viktig skillnad: Layas vikter är öppna under Apache 2.0 och modellen kan köras helt på lokal hårdvara. För lokal AI gör det Laya mer intressant än ännu en snabb klassificerare. Det väcker en större fråga: bör repetitiva AI-beslut över huvud taget skickas till en frontier-modell?
Vad är Laya?
Laya är en öppen modell med tillgängliga vikter, en icke-autoregressiv beslutsmodell utvecklad av Convai Innovations.
Den huvudsakliga engelska kontrollpunkten använder ModernBERT-large som grundmodell och innehåller ungefär 421 miljoner parametrar. I stället för att generera godtyckligt språk tillhandahåller programmet ett tillstånd och en eller flera typade frågor.
| Beslutstyp | Vad Laya returnerar | Exempel |
|---|---|---|
val |
Sannolikhet för fördefinierade alternativ | fakturering / support / försäljning |
poäng |
Förväntat värde på en ordnad skala | brådskandegrad från 0–4 |
noul |
P(sant) | Är detta e-postmeddelande nätfiske? |
Om det gränssnittet låter bekant beror det på att Jev använder en liknande modell för typade beslut. Vår tidigare guide till beslutsmodeller för AI-agenter förklarar varför denna modellkategori börjar växa fram.
Laya förstås bättre som en inlärd beslutsmotor
En generativ modell kan få:
”Läs detta supportärende och förklara vad kunden vill.”
Laya är utformad för snävare frågor:
- Vilken avdelning ska ta emot det?
- Är det brådskande?
- Ser det ut som nätfiske?
- Bör en annan modell granska det?
| Generativ modell | Laya |
|---|---|
| Skapar ett godtyckligt svar | Väljer bland fördefinierade utfall |
| Genererar token efter token | Poängsätter alternativ direkt |
| Användbar för skrivande och resonemang | Användbar för routning och klassificering |
| Utdatans längd påverkar fördröjningen | Ingen lång utdataserie |
Den viktiga skillnaden är inte ”smart modell kontra enkel modell”. Frågan är om programmet faktiskt behöver språkgenerering.
Om programvaran bara behöver veta om det gäller fakturering, teknisk support eller försäljning är det onödigt arbete att generera ett stycke text och sedan tolka tillbaka det till en enum.
Hur fattar Laya beslut utan att generera text?
Enligt den officiella arkitekturdokumentationen kombinerar Laya en ModernBERT-large-enkoder med ungefär 395 miljoner parametrar med ett beslutshuvud i två lager, poängsättning av alternativmarkörer samt en komponent för att agera eller eskalera.
Eftersom ModernBERT är dubbelriktad kan Laya beakta tillståndet, frågan och de tillgängliga alternativen tillsammans i stället för att förutsäga ett resultat en token i taget.
Den arkitektoniska skillnaden är anledningen till att en liten beslutsmodell kan vara attraktiv för arbetsbelastningar som:
- agentdirigering;
- e-posttriage;
- moderering;
- dokumentrelevans;
- avsiktsidentifiering;
- säkerhetsgrindar;
- eskalering i arbetsflödet.
Det här är precis den typ av rutinmässiga arbetsbelastningar där hybrid AI-routing blir användbar: behåll repetitivt arbete på ett billigare lokalt lager och reservera en större modell för de svåra fallen.
Har Laya verkligen ”inga hallucinationer”?
Projektets dokumentation säger att eftersom Laya inte genererar text eliminerar den tolkningsfel och hallucinationer.
Det påståendet behöver en viktig reservation.
Laya kan eliminera fel som:
- felaktig JSON;
- påhittade enum-värden;
- extra text runt ett strukturerat svar;
- fritt genererade påståenden.
Men den kan fortfarande fatta fel beslut.
En modell kan returnera:
billing: 0.92
även när ärendet borde ha gått till teknisk support.
Typad output förhindrar ogiltiga svar. Den garanterar inte korrekta bedömningar.
Den skillnaden är avgörande om resultatet styr en agent, ett säkerhetsarbetsflöde, en finansiell process eller en automatiserad åtgärd.
Varför kalibrering är viktigare än en konfidenssiffra
Laya tränas med RLCD, eller Reinforcement Learning for Calibrated Decisions. Målet är inte bara att välja rätt svar, utan också att göra den rapporterade sannolikheten användbar.
Ett produktionssystem kan sedan använda konfidensen för att styra eskalering:
| Konfidens | Möjlig åtgärd |
|---|---|
| Mycket hög | Hantera ett lågriskbeslut automatiskt |
| Medel | Fråga en större modell |
| Låg | Begär mänsklig granskning |
Men Layas egen dokumentation visar varför man inte bör lita blint på dessa sannolikheter. Projektet rapporterar en betydande förbättring av kalibreringen efter temperaturanpassning och rekommenderar att modellen kalibreras för användningsdomänen.
Med andra ord behöver en modell som är utformad för kalibrerade beslut fortfarande kalibreras för din faktiska arbetsbelastning.
Det viktigaste resultatet med Laya är inte hastigheten
Layas publicerade latenssiffror är imponerande. Projektet rapporterar korta beslut på tiotals millisekunder på en Tesla T4, medan den oberoende Laya-MLX-porten rapporterar cirka 13,4 ms för den engelska modellen och 7,4 ms för den flerspråkiga kontrollpunkten på en M3 Max.
Dessa mätningar bekräftar att Laya tillhör en helt annan distributionsklass än en generativ modell med flera miljarder parametrar.
Men det mer avslöjande resultatet är hur starkt prestandan beror på specialisering.
I projektets utvärdering av typade beslut presterar Laya-basmodellen endast något bättre än den slumpmässiga baslinjen vid zero-shot-användning. Efter uppgiftsspecifik finjustering förbättras den specialiserade kontrollpunkten dramatiskt.
| Utvärdering av typade beslut | Rapporterad träffsäkerhet |
|---|---|
| Slumpmässig baslinje | ~0,318 |
| Laya-basmodell, zero-shot | ~0,36 |
| Finjusterade Laya för typade beslut | ~0,766 |
Detta förändrar hur Laya bör förstås.
Det är inte nödvändigtvis en universell modell för resonemang med 421 miljoner parametrar som magiskt förstår varje nytt beslutsproblem.
Layas starkare fördel är att en liten modell kan specialiseras för en stabil beslutsyta, kalibreras och sedan köras extremt billigt i hög volym.
Finjustering kan vara viktigare än basmodellen
Projektet publicerar verktyg för träning och finjustering tillsammans med kontrollpunkterna. Det är betydelsefullt eftersom många produktionsbeslut är mycket domänspecifika.
Överväg:
- Vilket internt supportteam ansvarar för det här ärendet?
- Matchar det här dokumentet vår privata taxonomi?
- Ska den här hemautomationen köras?
- Vilken agent ska ta emot den här uppgiften?
- Kräver den här lokala filen en djupare AI-analys?
En generell modell kan besvara dessa frågor, men den kan upprepade gånger lägga beräkningskraft från en stor modell på att återskapa en beslutsgräns som knappt förändras.
En specialiserad Laya-kontrollpunkt kan i stället lära sig den gränsen direkt.
Detta passar in i en bredare trend kring öppna modeller kontra frontier-AI: den mest kapabla modellen är inte automatiskt den mest effektiva modellen för en upprepad, väldefinierad arbetsbelastning.
Där Laya fortfarande är svagt
De publicerade resultaten visar också tydliga begränsningar.
Stora etikettutrymmen är svåra. Layas dokumentation rekommenderar att begränsa valfrågor till ungefär färre än 20 alternativ. De tillgängliga alternativen delar på en fast tokenbudget, så mycket stora platta taxonomier kan försämra prestandan.
En hierarkisk routing är ofta mer logisk:
| Steg | Exempel |
|---|---|
| Första beslutet | Fakturering / Produkt / Säkerhet / Konto |
| Andra beslutet | Välj en av flera underkategorier |
Ordinal poängsättning är ett annat svagare område. Att be en modell välja en kategori är ofta enklare än att tillförlitligt skilja mellan närliggande nivåer, som frustrationspoäng från 1 till 5.
Kontexten är också begränsad jämfört med moderna LLM:er. Den engelska kontrollpunkten använder en indata budget på 512 tokens, medan andra Laya-varianter utökar detta till 1 024 tokens.
Det innebär att Laya passar mycket bättre för utvalda bevis än för att mata in ett helt långt dokument i modellen.
Laya jämfört med Jev: Öppen lokal modell eller hanterat besluts-API?
Laya beskrivs ofta som ett alternativ till Jev med öppen källkod, men att begränsa jämförelsen till benchmarkpoäng missar den viktigare arkitektoniska skillnaden.
| Laya | Jev | |
|---|---|---|
| Huvudroll | Typade beslut | Typade beslut |
| Öppna vikter | Ja | Inga offentliga vikter för närvarande |
| Egen drift | Ja | Värdtjänst |
| Finjustering | Tillgänglig | Ingen motsvarande offentlig lokal arbetsprocess |
| Lokal datasökväg | Möjligt | Begäran skickas till en värdtjänst |
| Operativ börda | Användaren hanterar modellen och kalibreringen | Leverantören hanterar inferensen |
Den specialiserade Laya-kontrollpunkten rapporterar högre noggrannhet än Jev i ett publicerat benchmarktest för typade beslut, medan Jev rapporterar bättre kalibrering i en del av samma jämförelse. Det räcker inte som bevis för att utse en modell till universellt bättre.
Den större skillnaden är kontroll.
Jev ger utvecklare en hanterad besluts-tjänst. Laya ger dem modellvikter som kan finjusteras, benchmarkas, låsas till en version och distribueras bredvid privata data.
Kan Laya köras helt lokalt?
Ja. Detta är Layas viktigaste praktiska fördel.
Den officiella modellen körs via PyTorch och Transformers. Communityprojekt har redan utökat driftsättningen till andra körmiljöer:
Den huvudsakliga 421M-kontrollpunkten är under 1 GB i sin publicerade viktrepresentation, vilket placerar den i en dramatiskt mindre minnesklass än de flesta användbara generativa LLM:er.
Det gör Laya relevant för det praktiska problemet med att dirigera modeller efter minneskrav. Ett system behöver inte hålla en stor generativ modell aktiv bara för att klassificera varje inkommande begäran.
Varför det är viktigt att köra beslutslagret lokalt
Lokal inferens handlar inte bara om att undvika en API-kostnad.
Indata till beslutsmodeller är ofta känsliga:
- e-post;
- supportärenden;
- privata dokument;
- kundregister;
- källdata;
- agentloggar;
- lokala sökresultat.
Ett värdbaserat besluts-API kan vara billigt, men applikationen måste fortfarande skicka tillståndet någonstans för klassificering.
Laya möjliggör en annan arkitektur:
| Lokalt lager | Eskaleringslager |
|---|---|
| Hämta privata filer | Avancerat resonemang |
| Klassificera och poängsätt lokalt | Frontier-modell |
| Identifiera känsligt innehåll | Komplex syntes |
| Dirigera rutinuppgifter | Tvetydiga gränsfall |
Detta är samma anledning till att lokal AI-bearbetning nära lagrade data spelar roll. Genom att behålla det första beslutet bredvid datan kan både nätverksexponering och onödig molninferens minskas.
Laya kan bli filtret före den stora modellen
Den starkaste arkitekturen kanske inte är Laya i stället för en LLM.
Det kan vara:
| Lager | Jobb |
|---|---|
| Regler | Hantera deterministiska fall |
| Lokal Laya | Hantera repetitiva diffusa beslut |
| Stor modell | Hantera svåra resonemang eller generering |
| Policy / människa | Godkänn åtgärder med stor påverkan |
Föreställ dig ett privat dokumentsystem med 10 000 lokala poster. En frontier-modell behöver inte läsa alla 10 000 på djupet.
En liten lokal modell kan först fråga:
- Är detta relevant?
- Vilken kategori tillhör den?
- Innehåller den känslig information?
- Är konfidensen tillräckligt låg för att eskalera?
Endast den svåra delmängden behöver dyr inferens.
En privat AI-assistent på en NAS är en självklar miljö för detta mönster, eftersom lagring, hämtning, klassificering och personuppgifter kan förbli lokala medan svårare förfrågningar selektivt eskaleras.
Vad Laya faktiskt förändrar
Under flera år har AI-arkitekturen rört sig mot allt mer generella modeller: en modell som kan resonera, koda, skriva, klassificera, söka och anropa verktyg.
Laya representerar den motsatta idén.
Vissa uppgifter kan bli bättre när modeller blir mer specialiserade, inte mer generella.
Om ett system behöver miljontals bedömningar, till exempel:
relevant eller irrelevant?
säker eller osäker?
ska dirigeras till A, B eller C?
fortsätta eller eskalera?
då kan en lokal beslutsmodell på 421 miljoner parametrar hamna i ett helt annat ekonomiskt och integritetsmässigt lager än en frontier-LLM.
Den viktiga frågan är därför inte om Laya kan slå Jev, Claude, Gemini eller GPT på allt.
Det kan den inte.
Den mer användbara frågan är:
hur många beslut i ett AI-arbetsflöde behövde egentligen aldrig en generativ modell från början?
Om svaret är ”många” kan små lokala beslutsmodeller bli ett av de lager som saknas i praktisk AI-infrastruktur.
Vanliga frågor om Laya
Vad är Laya-modellen?
Laya är en öppen viktad icke-autoregressiv beslutsmodell från Convai Innovations. Den tar emot ett tillstånd och typade frågor och returnerar val, poäng eller booleska sannolikheter i stället för att generera fri text.
Är Laya öppen källkod?
Modellvikterna publiceras under Apache 2.0, och offentliga resurser för inferens, utvärdering och finjustering finns tillgängliga från projektet.
Kan Laya köras lokalt?
Ja. Den officiella implementationen körs med PyTorch, medan communitydrivna körtider stöder ONNX på Node.js och MLX på Apple Silicon. Ett hostat inferens-API krävs inte efter att modellen har laddats ner.
Är Laya bättre än Jev?
Inte universellt. Laya erbjuder öppna vikter, självhostning och finjustering, medan Jev tillhandahåller en hanterad hostad beslutstjänst. Publicerade benchmarkresultat visar olika styrkor beroende på uppgiftstyp och kalibrering.
Vad används Laya bäst till?
Laya lämpar sig bäst för upprepade avgränsade beslut, till exempel dirigering, moderering, relevansbedömning, avsiktsdetektering, e-postsortering, säkerhetskontroller och beslut om när en större modell eller människa bör ta över.

Rekommenderade produkter

Teknik- och AI-hubb
Mer att läsa

Topp 10 AI-kodningsassistenter med öppen källkod 2026
Jämför 10 AI-kodningsassistenter med öppen källkod för IDE:er, terminaler, lokala modeller, självhostning, Git-arbetsflöden och autonom utveckling.
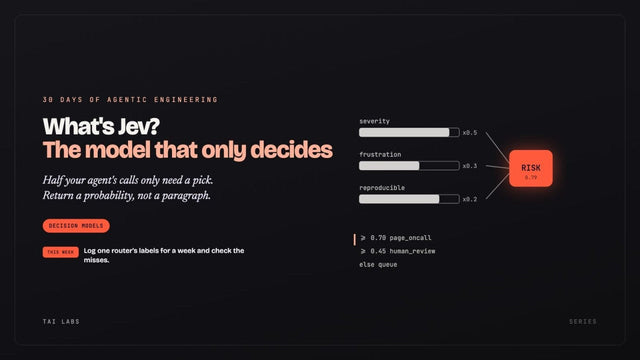
Exempel på användningsområden för Jev: 7 saker som människor redan bygger med TypeSafes beslutsmodell
Sju verkliga Jev-byggen visar var beslutsmodeller passar in: dirigering, webbläsaråtgärder, poängsättning, filtrering, spel, innehållsanalys och prioritering av research.

Varför går AI för hemmabaserade NVR-system från bildrutedetektering till händelseförståelse år 2026?
Förstå hur spår blir händelser, varför tidsmässig kontext minskar upprepade aviseringar och var händelsemedveten video-AI fortfarande brister.


