
Welche Faktoren führen dazu, dass sich Zitationsbereiche nach der Dokumentkonvertierung verschieben?


Zuverlässige Zitatstellen nach der Dokumentkonvertierung erfordern einen expliziten Zustand, messbare Kontrollen und Wiederherstellungsmechanismen. Kompatibilität und Richtlinien setzen dabei die praktischen Grenzen.
In einem Homeserver-Workflow können Abweichungen von Zitatstellen nach der Dokumentkonvertierung sowohl das interaktive Verhalten als auch die Ressourcennutzung im Hintergrund verändern. Die sichtbare Auswirkung zeigt sich erst, nachdem die Anfrage mehrere Verarbeitungsstufen durchlaufen hat. Eine einzelne Durchschnittszahl kann daher verschleiern, wo Verzögerungen, Qualitätsverluste oder Fehler ihren Ursprung hatten. Werden Transport, Rechenleistung, Speicher und Anwendungszustand getrennt betrachtet, lässt sich der Zusammenhang unter ansonsten identischen Bedingungen überprüfen.
Wie Abweichungen von Zitatstellen nach der Dokumentkonvertierung die für Nutzer sichtbare Ebene erreichen
Die für Nutzer sichtbare Auswirkung tritt erst nach dieser Bedingung auf: Kandidatenpassagen können vor dem Zusammenstellen des endgültigen Kontexts daraufhin bewertet werden, ob sie die konkrete Aussage belegen. Dieser Schritt verändert, was die nächste Komponente erhält. Daher lässt sich das beobachtete Ergebnis nicht allein der endgültigen Oberfläche oder dem Modell zuschreiben. Wenn Eingabe und Arbeitslast konstant bleiben, wird diese frühe Umwandlung sichtbar.
Das Modell der Retrieval-Augmented Generation bietet eine konkrete Möglichkeit, diese Stufe zu interpretieren: Kandidatenpassagen können vor dem Zusammenstellen des endgültigen Kontexts daraufhin bewertet werden, ob sie die konkrete Aussage belegen. Der praktische Nutzen besteht darin, die veränderte Variable von späteren Auswirkungen durch Pufferung, Planung, Speicherung oder Darstellung zu trennen, die ein ähnliches Symptom verursachen können.
Sobald sich die erste Stufe ändert, entfernt die Ausrichtung der Textstellen umfangreiche Chunks, deren hoher Retrieval-Score schwache Belege verschleiert. Je nach Fragestellung des Artikels zeigt sich die Folge möglicherweise als Latenz, Genauigkeit, Energieverbrauch, Kapazität oder wahrgenommene Flüssigkeit. Der ursächliche Ablauf beginnt jedoch weiterhin, bevor die endgültige Ausgabe angezeigt wird.
Die Ressourcenabhängigkeiten hinter dem Ergebnis
Die Ressourcenabhängigkeiten sind relevant, weil die Ausrichtung der Textstellen umfangreiche Chunks entfernt, deren hoher Retrieval-Score schwache Belege verschleiert. Gleichzeitige KI-, Speicher-, Medien- oder Automatisierungsaufgaben können daher einen Effekt verstärken, der in einem Benchmark mit nur einer Anfrage gering erscheint. Das Verhalten unter Spitzenlast ist wichtiger als der Durchschnitt bei einem inaktiven System.
Der Mechanismus der Retrieval-Evaluierung verbindet die Ebene der gemeinsam genutzten Ressourcen mit dem Ergebnis: Die Ausrichtung der Textstellen entfernt umfangreiche Chunks, deren hoher Retrieval-Score schwache Belege verschleiert. Durch die separate Messung dieser Ebene werden Durchsatz, Cache-Treffer, Bestätigungen oder optimistische Statusaktualisierungen nicht fälschlich als abgeschlossene, für Nutzer sichtbare Arbeit gewertet.
Die Wechselwirkung bleibt bestehen, weil Konvertierung und Chunking Offsets verschieben oder den unterstützenden Satz aufteilen können. Deshalb können sich zwei Homeserver mit derselben Hardware oder Netzwerkgeschwindigkeit auf dem Papier unterschiedlich verhalten, wenn Warteschlangentiefe, Datenanordnung, Cache-Zustand oder Richtlinien abweichen.
Fälle, in denen Zitatstellen nach der Dokumentkonvertierung abweichen, sind nicht aussagekräftig
Der behauptete Effekt gilt nicht allgemein. In diesem Fall gibt die Anwendung keine Zitate oder Belegbehauptungen aus. Ein anderer Engpass kann die Obergrenze setzen, bevor eine Änderung an Zitationsbereichen messbar wird, die nach der Dokumentkonvertierung verschoben sind.
Der Zusammenhang mit Retrieval-Qualität hilft, den erwarteten Mechanismus von einer konkurrierenden Erklärung zu unterscheiden. Bei einem kontrollierten Test müssen Quelldaten, Hardware, Parallelität, Cache-Zustand und Softwareversionen unverändert bleiben, während nur die Titelvariable geändert wird. Dieser Zusammenhang sollte bei einem reproduzierbaren Test auf einem Heimserver sichtbar bleiben.
Die Fehlergrenze ist erreicht, wenn die Anwendung keine Zitate oder Belegbehauptungen ausgibt. Darüber hinaus kann eine aggressivere Optimierung Kosten, Risiken oder Instabilität erhöhen, ohne das im Titel versprochene Ergebnis zu verbessern.

Häufig gestellte Fragen zu Zitationsbereichen, die nach der Dokumentkonvertierung verschoben sind
Sind Zitationsbereiche, die nach der Dokumentkonvertierung verschoben sind, der Hauptengpass?
Nicht automatisch. Es ist nur dann der Hauptengpass, wenn eine Änderung das Ergebnis beeinflusst, während die Span-Zuordnung große Textabschnitte entfernt, deren hohe Retrieval-Werte schwache Belege verschleiern, und die übrigen Bedingungen unverändert bleiben. Reagiert die Ausgabe nicht, setzt eine andere Stufe die Obergrenze.
Kann Caching den Effekt von Zitationsbereichen verschleiern, die nach der Dokumentkonvertierung verschoben sind?
Ja. Warme Caches, beibehaltene Sitzungen, im Speicher gehaltene Modelle, gepufferte Medien und optimistische Aktualisierungen der Benutzeroberfläche können die untersuchte Stufe umgehen. Ergebnisse mit kaltem und warmem Cache sollten getrennt ausgewiesen werden. Das Ergebnis muss getrennt von benachbarten Pipeline-Stufen bewertet werden.
Welcher Messwert ist bei Zitationsbereichen, die nach der Dokumentkonvertierung verschoben sind, am wichtigsten?
Zu den aussagekräftigen Messwerten gehören Span-Präzision, Belegquote, Offset-Verschiebung und Antwortabdeckung. Durchschnittswerte sollten zusammen mit der Latenz in den Randbereichen, Fehlern, Qualität oder Ressourcenkosten betrachtet werden, damit ein glatter wirkendes Ergebnis nicht fälschlich für ein besseres System gehalten wird.
Führe einen kontrollierten Test zu Zitationsbereichen durch, die nach der Dokumentkonvertierung verschoben sind
Erstelle eine repräsentative Arbeitslast und erfasse Span-Präzision, Belegquote, Offset-Verschiebung und Antwortabdeckung, bevor du Zitationsbereiche änderst, die nach der Dokumentkonvertierung verschoben sind. Führe Tests mit kaltem und warmem Cache durch, berücksichtige realistische Parallelität und verwende bei allen Vergleichen dieselben Daten, Versionen, Hardware und dasselbe für Nutzer sichtbare Erfolgskriterium.
Nutze den verwandten Mechanismus unter Zitationsbereiche, die nach der Dokumentkonvertierung verschoben sind, um vor dem Test die erwartete Richtung festzulegen. Ändere jeweils nur eine Variable, erfasse Median und Randverhalten und behalte den fehlerhaften oder verschlechterten Fall bei, damit das Ergebnis auch seine betriebliche Grenze zeigt.
Übernimm die Änderung nur, wenn der gemessene Nutzen in wiederholten Tests bestehen bleibt und die angegebene Grenze akzeptabel ist. Wenn eine andere Stufe den Engpass darstellt, lass Zitationsbereiche, die nach der Dokumentkonvertierung verschoben sind, unverändert und teste stattdessen diesen konkurrierenden Engpass, anstatt aus einer Korrelation auf Kausalität zu schließen.

Empfohlene Produkte

Tech- und KI-HUB
Mehr zum Lesen
Ransomware-Angriffe auf Synology-NAS: C3RB3R, DSM-Schwachstellen und was bestätigt ist
Analysieren Sie die Ransomware-Berichte zu Synology-NAS-Systemen aus dem Jahr 2026, die widersprüchlichen Angaben zum Einstiegspunkt von C3RB3R, DSM-Sicherheitshinweise, fehlende Patches und was die Belege...
Welche Komponenten ermöglichen transaktionssichere Tool-Workflows?
Eine mechanismenorientierte Erklärung transaktionssicherer Tool-Workflows, ihrer Abwägungen bei gemeinsam genutzten Ressourcen, drei FAQs zur Abfrageverteilung und eines praktischen Prüfverfahrens.
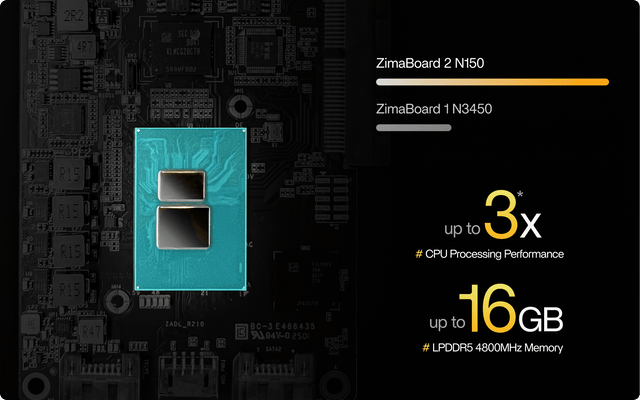
Welche Funktionen ermöglichen die deterministische Wiedergabe eines selbst gehosteten KI-Agenten?
Eine mechanismenorientierte Erklärung der deterministischen Wiedergabe eines selbst gehosteten KI-Agenten, seiner Kompromisse bei gemeinsam genutzten Ressourcen, drei FAQs zur Abfrageverteilung und einem praxisnahen …


