
GPU-Speicher-Wasserzeichen: Wie frühe Drucksignale Allokationsfehler verhindern


Der beobachtbare Effekt tritt üblicherweise auf, weil weiche und harte Schwellenwerte Druck signalisieren, bevor eine Zuweisung von Ressourcen für den Beschleuniger fehlschlägt; gemeinsam genutzte Ressourcen und das Timing bestimmen dabei das Ausmaß in der Praxis.
In einem Heimserver-Arbeitsablauf können GPU-Speicher-Watermarks sowohl das interaktive Verhalten als auch die Ressourcennutzung im Hintergrund verändern. Der sichtbare Effekt tritt erst auf, nachdem die Anfrage mehrere Verarbeitungsstufen durchlaufen hat. Deshalb kann ein einzelner Durchschnittswert verschleiern, wo Verzögerung, Qualitätsverlust oder Fehler ihren Anfang nahmen. Werden Transport, Berechnung, Speicher und Anwendungszustand getrennt betrachtet, lässt sich der Zusammenhang unter ansonsten identischen Bedingungen überprüfen.
Der Mechanismus hinter GPU-Speicher-Watermarks
Der Mechanismus befindet sich nicht ausschließlich in der endgültigen Anwendung. Weiche und harte Schwellenwerte signalisieren Druck, bevor eine Zuweisung von Ressourcen für den Beschleuniger fehlschlägt. Dieser Schritt verändert, was die nächste Komponente erhält. Daher lässt sich das beobachtete Ergebnis nicht allein der endgültigen Benutzeroberfläche oder dem Modell zuschreiben. Bleiben Eingabe und Arbeitslast konstant, wird diese frühe Umwandlung sichtbar.
Das Modell der GPU-Leistungssteuerung bietet eine konkrete Möglichkeit, diese Stufe zu interpretieren: Weiche und harte Schwellenwerte signalisieren Druck, bevor eine Zuweisung von Ressourcen für den Beschleuniger fehlschlägt. In der Praxis hilft es dabei, die veränderte Variable von späteren Auswirkungen durch Pufferung, Planung, Speicher oder Rendering zu unterscheiden, die ein ähnliches Symptom verursachen können.
Sobald sich die erste Stufe ändert, werfen Scheduler Caches aus, verringern die Batchgröße oder weisen Aufträge ab, sobald die jeweiligen Schwellenwerte überschritten werden. Je nach Fragestellung des Artikels kann sich die Folge in Latenz, Genauigkeit, Energieverbrauch, Kapazität oder wahrgenommener Flüssigkeit zeigen; der ursächliche Ablauf beginnt jedoch weiterhin, bevor die endgültige Ausgabe angezeigt wird.
Warum der Effekt unter Last zunimmt
Unter Last wird die nächste Abhängigkeit deutlicher, weil Scheduler Caches auswerfen, die Batchgröße verringern oder Aufträge abweisen, sobald die jeweiligen Schwellenwerte überschritten werden. Gleichzeitige KI-, Speicher-, Medien- oder Automatisierungsaufgaben können daher einen Effekt verstärken, der in einem Benchmark mit nur einer Anfrage gering erscheint. Das Verhalten in Spitzenzeiten ist wichtiger als ein Durchschnittswert im Leerlauf.
Der Mechanismus zur GPU-Inferenzplanung verbindet die Ebene gemeinsamer Ressourcen mit dem Ergebnis: Scheduler werfen Caches aus, verringern die Batchgröße oder weisen Aufträge ab, sobald die jeweiligen Schwellenwerte überschritten werden. Wird diese Ebene separat gemessen, lassen sich Durchsatz, Cache-Treffer, Bestätigungen oder optimistische Statusmeldungen davon unterscheiden, ob die Arbeit tatsächlich abgeschlossen und für Nutzer sichtbar ist.
Die Wechselwirkung besteht fort, weil Fragmentierung zu wenig zusammenhängenden Speicher oberhalb eines Byte-Watermarks übrig lassen kann. Deshalb können sich zwei Heimserver mit derselben beworbenen Hardware oder Netzwerkgeschwindigkeit unterschiedlich verhalten, wenn sich Warteschlangentiefe, Datenlayout, Cache-Zustand oder Richtlinie unterscheiden.
Was GPU-Speicher-Watermarks nicht erklären können
Der Zusammenhang in der Überschrift lässt sich in einem wichtigen Fall nicht mehr zur Vorhersage heranziehen. In diesem Fall hat jede Anfrage eine festgelegte winzige Speicherzuweisung und reichlich Reserve. Ein anderer Engpass kann die Obergrenze setzen, bevor eine Änderung der GPU-Speicher-Wasserstände messbar wird.
Der Zusammenhang mit der Iterationsplanung hilft dabei, den erwarteten Mechanismus von einer konkurrierenden Erklärung zu unterscheiden. Bei einem kontrollierten Test müssen Quelldaten, Hardware, Parallelität, Cache-Zustand und Softwareversionen unverändert bleiben; nur die Titelvariable darf geändert werden. Diese Abhängigkeit sollte bei einem reproduzierbaren Test auf einem Heimserver sichtbar bleiben.
Die Fehlergrenze ist erreicht, wenn jede Anfrage eine festgelegte winzige Speicherzuweisung und reichlich Reserve hat. Ab diesem Punkt kann eine aggressivere Abstimmung Kosten, Risiken oder Instabilität verursachen, ohne das im Titel versprochene Ergebnis zu verbessern.

Häufig gestellte Fragen zu GPU-Speicher-Wasserständen
Sind GPU-Speicher-Wasserstände der Hauptengpass?
Nicht automatisch. Es handelt sich nur dann um den Hauptengpass, wenn eine Änderung daran das Ergebnis beeinflusst, während Scheduler bei jedem Überschreiten eines Schwellenwerts Caches verdrängen, die Batch-Größe verringern oder Aufträge ablehnen und alle anderen Bedingungen unverändert bleiben. Wenn sich die Ausgabe nicht verändert, setzt eine andere Stufe die Obergrenze.
Kann Caching den Effekt von GPU-Speicher-Wasserständen verschleiern?
Ja. Warme Caches, aufrechterhaltene Sitzungen, residente Modelle, gepufferte Medien und optimistische Aktualisierungen der Benutzeroberfläche können die untersuchte Stufe umgehen. Kalte und warme Testläufe sollten getrennt ausgewiesen werden. Das Ergebnis muss unabhängig von benachbarten Pipeline-Stufen bewertet werden.
Welcher Messwert für GPU-Speicher-Wasserstände ist am wichtigsten?
Die aussagekräftigen Messwerte sind freie Bytes, der größte zusammenhängende Speicherblock, Verdrängungen und fehlgeschlagene Speicherzuweisungen. Durchschnittswerte sollten zusammen mit Latenzspitzen, Fehlern, Qualität oder Ressourcenaufwand betrachtet werden, damit ein glatter wirkendes Ergebnis nicht fälschlich als besseres System gilt.
Einen kontrollierten Test der GPU-Speicher-Wasserstände durchführen
Erstellen Sie eine repräsentative Arbeitslast und erfassen Sie vor einer Änderung der GPU-Speicher-Wasserstände die freien Bytes, den größten zusammenhängenden Speicherblock, Verdrängungen und fehlgeschlagene Speicherzuweisungen. Führen Sie kalte und warme Testläufe durch, berücksichtigen Sie realistische Parallelität und verwenden Sie bei allen Vergleichen dieselben Daten, Versionen und Hardware sowie dasselbe für Nutzer sichtbare Erfolgskriterium.
Nutzen Sie den verwandten Mechanismus in GPU-Speicher-Wasserständen, um vor dem Test die erwartete Richtung festzulegen. Ändern Sie immer nur eine Variable, erfassen Sie Median- und Randverhalten und behalten Sie den fehlgeschlagenen oder verschlechterten Fall bei, damit das Ergebnis auch dessen Betriebsgrenze umfasst.
Übernehmen Sie die Änderung nur, wenn der gemessene Nutzen in wiederholten Versuchen anhält und die angegebene Grenze akzeptabel bleibt. Wenn eine andere Stufe den Engpass darstellt, lassen Sie die GPU-Speicher-Wasserstände unverändert und testen Sie stattdessen diesen konkurrierenden Engpass, statt aus einer Korrelation auf einen Kausalzusammenhang zu schließen.

Empfohlene Produkte

Tech- und KI-HUB
Mehr zum Lesen
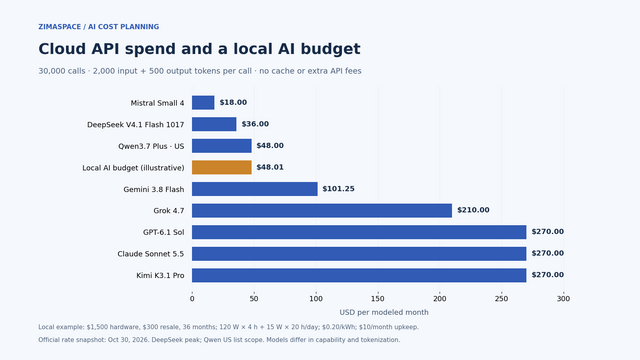
Preise für Cloud-KI-APIs vs. lokale KI: Was kostet Ihre Arbeitslast wirklich?
Vergleiche die Kosten für Cloud-API-Tokens mit denen für lokale KI-Hardware, Strom und Wartung. Rechne ein monatliches Beispiel durch und nutze den kostenlosen ZimaSpace-Kostenrechner.

Das Secret-Zero-Problem: Warum ein KI-Agent für zu Hause immer noch einen anfänglichen Vertrauensanker braucht
Eine Erklärung des Secret-Zero-Problems, die beim Mechanismus ansetzt, seiner Zielkonflikte bei gemeinsam genutzten Ressourcen, drei FAQs zur Abfrageverteilung und eines praktischen Verifizierungsprotokolls.
Workload-Identitätsföderation: Wie lokale Dienste gemeinsam genutzte API-Schlüssel vermeiden
Eine mechanismusorientierte Erklärung der Workload-Identitätsföderation, ihrer Abwägungen bei gemeinsam genutzten Ressourcen, drei FAQs zur Abfrageverteilung und eines praktischen Prüfprotokolls.


